

基于对比学习与大语言模型的文本因果特征选择方法
[杨嘉豪1, 2  , 杨俊涛
1, 2 , 曹大元1, 2 , 熊寿久1, 2 , 俞奎1, 2 ]
, 杨俊涛, 曹大元, 熊寿久, 俞奎]
|
|


作者简介:
杨嘉豪, 硕士研究生,主要研究方向为因果发现、特征选择.E-mail:2024170872@mail.hfut.edu.cn.
杨俊涛, 博士研究生,主要研究方向为因果发现、特征选择和聚类.E-mail:juntaoyang@mail.hfut.edu.cn.
曹大元, 博士研究生,主要研究方向为因果发现、联邦学习.E-mail:dayuancao@mail.hfut.edu.cn.
熊寿久, 博士研究生,主要研究方向为因果发现、表示学习.E-mail:2025030067@mail.hfut.edu.cn.
从文本数据中学习与目标变量相关的因果特征,是提升模型可解释性与决策可靠性的重要途径之一.然而,文本因果特征选择仍面临两方面挑战:1)潜在特征通常隐含于非结构化文本中,且句子表示常混合潜在特征语义与情感信息,导致潜在特征提取结果不稳定;2)潜在特征在提取、赋值与补充过程中动态变化,难以实现稳定高效的因果特征选择.针对上述问题,文中提出基于对比学习与大语言模型的文本因果特征选择方法(Textual Causal Feature Selection via Contrastive Learning and Large Language Model, TCFS).首先,针对潜在特征提取不稳定的问题,设计解耦潜在特征提取方法,并结合迭代聚类优化,构建语义一致、结构稳定的潜在特征簇.然后,针对因果特征动态变化带来的选择困难,提出动态因果特征选择方法,动态维护与目标变量相关的马尔可夫毯,实现关键因果特征的稳定识别与冗余剔除.最后,通过潜在特征赋值将非结构化文本转化为结构化数值数据,并引入缺失特征发现机制,对难以解释的样本进行分析与迭代补充,持续优化潜在特征集合与特征选择结果.实验表明,TCFS能有效提升文本场景中潜在特征提取的稳定性和因果特征选择的准确性,为可解释预测与文本因果分析提供有效支持.
About Author:
YANG Jiahao, Master student. His research interests include causal discovery and feature selection.
YANG Juntao, Ph.D. candidate. His research interests include causal discovery, feature selection and clustering.
CAO Dayuan, Ph.D. candidate. His research interests include causal discovery and federated learning.
XIONG Shoujiu, Ph.D. candidate. His research interests include causal discovery and representation learning.
Learning causal features related to a target variable from textual data is considered as an important approach to improve model interpretability and decision reliability. However, textual causal feature selection still faces two challenges. Latent features are usually embedded in unstructured text, and latent feature semantics are often mixed with sentiment information in sentence representations. Consequently, latent feature extraction results are unstable. Stable and efficient causal feature selection becomes difficult due to the dynamic changes of latent features during extraction, assignment and supplementation. To address these issues, a method for textual causal feature selection via contrastive learning and large language model(TCFS) is proposed in this paper. First, a decoupled latent feature extraction method is designed to address the instability of latent feature extraction, and iterative clustering optimization is introduced to construct semantically consistent and structurally stable latent feature clusters. Second, a dynamic causal feature selection method is proposed, and the stable identification of key causal features and the removal of redundant features are achieved by dynamically maintaining the Markov blanket associated with the target variable. Finally, unstructured text is transformed into structured numerical data through latent feature assignment, and a missing-feature discovery mechanism is introduced to analyze hard-to-explain samples and iteratively supplement the missing features, thereby continuously optimizing the latent feature set and the feature selection results. Experiments demonstrate that TCFS effectively improves the stability of latent feature extraction and the accuracy of causal feature selection in text scenarios and provides effective support for interpretable prediction and textual causal analysis.
因果特征选择[1, 2]旨在从观测数据中识别与目标变量存在潜在因果关联的特征, 是提升模型可解释性与决策可靠性的重要技术手段之一[3].在现实世界中, 大量数据以文本形式存在, 如在线评论、社交媒体帖子与论坛讨论等[4], 若能从这些文本中自动提取潜在特征, 并识别与目标变量密切相关的关键因果特征, 将进一步拓展因果特征选择在文本场景中的应用价值[5].由于现有的主流因果特征选择方法主要处理结构化数值数据, 如何从文本数据中挖掘因果特征, 已成为一个新兴且具有重要挑战性的研究方向.
近年来, 大语言模型(Large Language Model, LLM)已成为从文本中识别因果关系的一类极具潜力的方法.一些研究者开始探索将LLM应用于文本特征抽取, 并与传统因果特征学习算法结合, 完成因果特征挖掘任务.例如, COAT(Causal Representation Assistant)[6]作为当前具有代表性的研究工作, 设计一种多阶段框架:首先从文本中抽取潜在特征, 再构建结构化数值数据, 最后利用经典因果发现算法学习全局因果图.
尽管这类方法为文本场景中的因果特征选择提供有价值的探索路径, 但仍难以解决若干关键问题.具体而言, 文本场景中的因果特征选择仍面临如下两个关键挑战.一方面, 如何从海量、噪声较强且语义复杂的非结构化文本中准确提取语义清晰的潜在特征, 并形成簇内语义一致、结构稳定的潜在特征簇, 仍十分困难.其主要原因在于:潜在特征通常隐含于自然语言表达之中, 而通用句嵌入往往同时混合潜在特征语义与情感信息.由于聚类过程依赖表示相似性进行划分, 这种信息混杂会干扰句子表示对潜在特征语义相似性的准确刻画[7], 导致描述同一潜在特征的句子被错误拆分, 或描述不同潜在特征的句子被错误聚合, 进而影响潜在特征提取结果的一致性与稳定性.另一方面, 如何在潜在特征动态变化的过程中实现稳定高效的因果特征选择, 同样是一个关键难题.潜在特征并非预先给定, 而是在提取、赋值与修正过程中持续更新.传统静态特征选择方法通常假设输入的变量集合在建模前是固定且已知的[8], 因此难以直接适应这种动态特征空间.现有方法大多缺乏稳定的动态更新机制, 仍依赖在特征集合更新后重新执行全量特征筛选的策略.该策略容易导致入选特征在迭代过程中频繁变化, 难以稳定维护与目标变量相关的关键特征子集.
为此, 本文提出基于对比学习与大语言模型的文本因果特征选择方法(Textual Causal Feature Selection via Contrastive Learning and Large Language Model, TCFS), 结合对比学习驱动的潜在特征提取机制与动态因果特征选择策略.首先, 提出解耦潜在特征提取方法.通过构建潜在特征对比学习与情感对比学习任务, 对句子表示中的潜在特征语义信息与情感信息进行解耦优化, 缓解通用句嵌入中多种信息混合导致的聚类偏差问题, 形成语义一致、结构稳定的潜在特征簇.然后, 提出动态因果特征选择方法.将潜在特征的初始提取与后续迭代中的缺失特征发现建模为动态特征流, 并围绕目标变量持续更新其相关特征子集, 从而避免变量集合变化时反复执行全量特征筛选的问题, 提升动态场景中因果特征选择的稳定性与效率.
文本场景中的因果特征选择通常涉及两个相互衔接的关键环节.先从非结构化文本中抽取语义清晰的潜在特征, 并形成簇内语义一致、结构稳定的潜在特征簇.再在此基础上识别与目标变量相关的关键因果特征.现有研究也主要围绕这两个方向展开.
基于聚类的文本潜在特征抽取方法主要可分为两类:基于通用预训练句向量的直接聚类方法和基于表示优化的聚类方法.
基于通用预训练句向量的直接聚类方法通常利用预训练语言模型(如SBERT(Sentence-BERT)、MiniLM等)生成句向量[9], 并结合K-means、层次聚类等算法形成特征簇, 从而实现观点或潜在特征的自动抽取[10, 11].这类方法实现简单、易于迁移, 但通常假设语义相似的句子在嵌入空间中能自然聚集, 因此较依赖预训练表示的质量, 容易受到文本中多粒度语义混合的影响[12].
基于表示优化的聚类方法通过表示优化提升聚类效果[13, 14].已有研究指出, 直接对通用句嵌入进行聚类往往难以获得语义一致的簇结构, 主要原因在于句子表示通常同时混合潜在特征语义信息与情感态度信息[15].为了缓解这一问题, 近年来有研究者引入对比学习方法, 增强嵌入表示的可分性.Zhao等[16]提出CONE(Unsupervised Contrastive Opinion Extraction), 构建双分支对比学习任务, 引导模型分别学习特征表示与情感表示, 以此提升聚类质量, 改善特征簇的一致性与稳定性.此类方法在文本特征抽取与表示优化方面取得较优性能, 但其研究重点多集中于特征抽取或文本表示解耦, 尚未进一步与因果发现或因果驱动的特征选择过程形成紧密结合.
现有基于传统因果发现的流特征选择方法主要面向结构化数值数据.在结构化数值数据场景中, 特征选择方法被广泛用于从高维变量集合中筛选与目标变量最相关的关键特征.传统方法包括基于相关性的统计筛选方法、嵌入式学习方法及基于因果理论的特征选择方法.其中, PC-algorithm[17]、基于快速因果推断(Fast Causal Inference, FCI)的算法[18]、基于马尔可夫毯(Markov Blanket, MB)的特征选择方法[19, 20]能通过识别目标变量的MB确定其最小充分特征集合, 从而实现因果驱动的特征选择[21].
然而, 这类方法通常假设输入变量集合在建模前是固定且已知的[22].当特征在数据流环境中逐步到达时, 传统因果发现方法往往难以直接适用[23].为此, 一些研究者提出流式特征选择(Streaming Feature Selection)方法, 通过在线相关性评估或条件独立性检验, 针对符合条件的新特征进行增量更新, 从而避免在每次变量变化后重新执行完整的特征选择过程[24], 如OSFS(Online Streaming Feature Selec-tion)[25]、Fast-OSFS[26]、SFS(Streaming Feature Selection)[27]等, 均能在动态特征空间中实现较高效的特征筛选.
在文本数据场景中, 因果特征选择面临更复杂的问题.与结构化数值数据不同, 文本中的潜在特征通常并非预先给定, 而是需要从非结构化文本中逐步抽取、赋值并不断更新.已有研究通常采用“ 文本潜在特征抽取-结构化数值数据构建-因果发现或特征筛选” 的三阶段思路开展分析, 代表性工作如 COAT.这类方法为文本场景中的因果特征选择提供初步探索, 但其核心流程仍主要建立在静态特征选择框架之上.当文本潜在特征在分析过程中持续生成、更新或剔除时, 现有方法通常难以动态维护与目标变量相关的关键特征子集.
现有流特征选择方法在结构化数值数据场景中已取得较优性能, 但文本数据场景是一个新兴的研究方向, 有待进一步拓展研究.
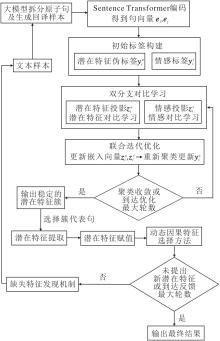
本文提出基于对比学习与大语言模型的文本因果特征选择方法(TCFS), 整体架构如图1所示.首先, 针对潜在特征提取不稳定的问题, 设计解耦潜在特征提取方法, 并结合迭代聚类优化, 构建语义一致、结构稳定的潜在特征簇.然后, 针对因果特征动态变化带来的选择困难, 提出动态因果特征选择方法, 动态维护与目标变量相关的马尔可夫毯, 实现关键因果特征的稳定识别与冗余剔除.最后, 通过潜在特征赋值将非结构化文本转化为结构化数值数据, 并引入缺失特征发现机制, 对难以解释的样本进行分析与迭代补充, 持续优化潜在特征集合与特征选择结果.
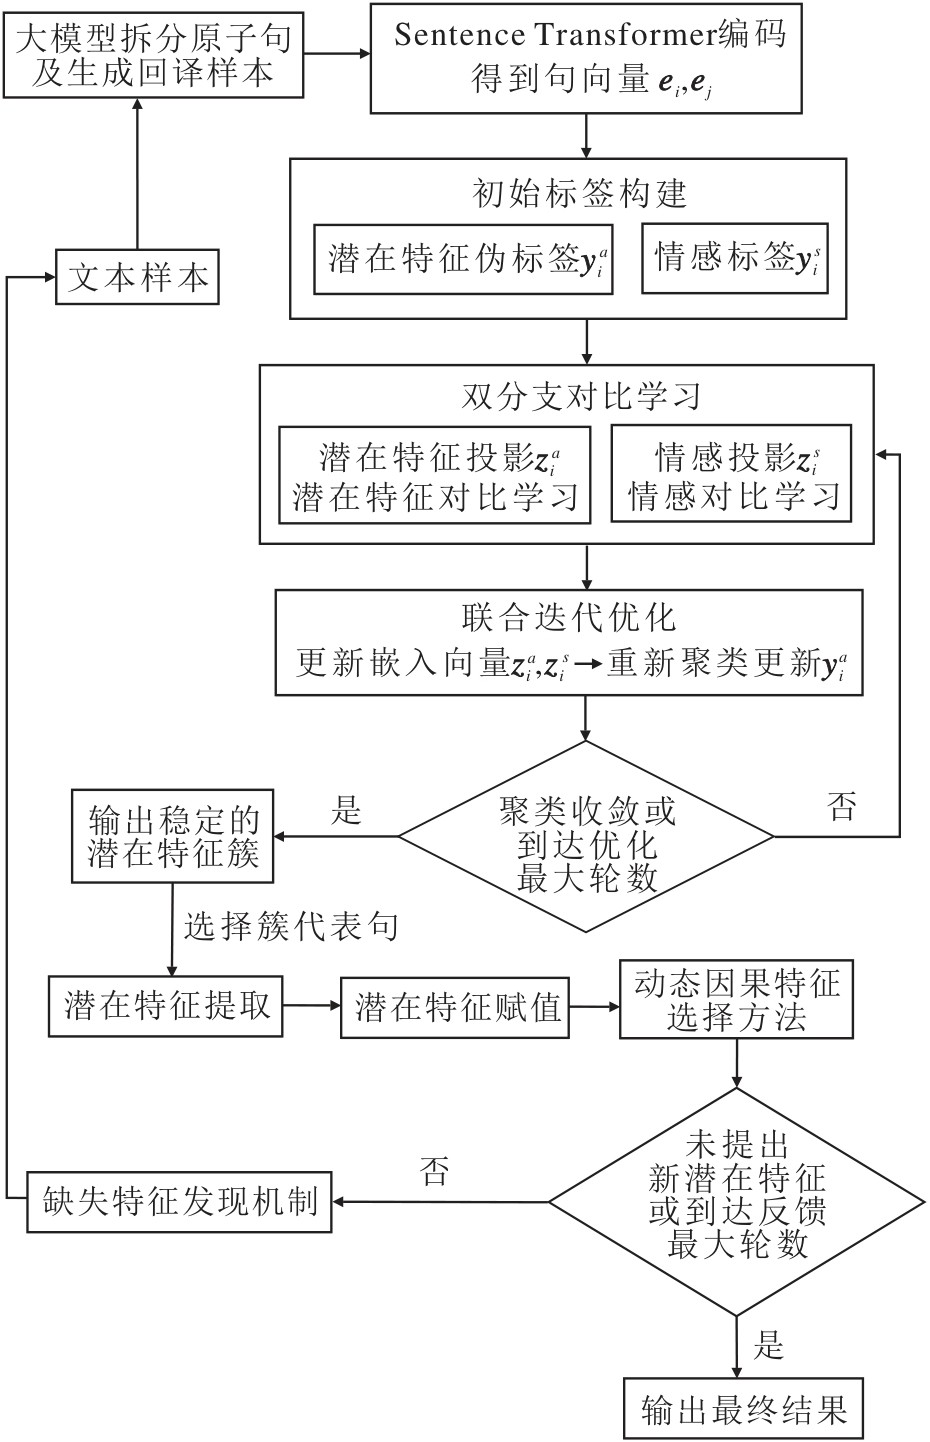 | 图1 TCFS整体架构Fig.1 Overall architecture of TCFS |
为了将非结构化文本转化为可用于后续因果特征选择的结构化数值数据, 首先从文本中提取语义清晰且结构稳定的潜在特征, 并在此基础上完成赋值和结构化数值数据构建.在文本场景中, 该过程面临两方面困难.1)原始评论文本通常包含多特征、多情感混合表达, 若直接将整条评论编码为通用句向量并进行聚类, 容易造成潜在特征语义与情感态度相互干扰.即使进一步将评论拆分为原子句, 通用句向量仍可能同时编码特征信息与情感信息, 从而影响潜在特征簇的一致性与稳定性.2)原始文本缺乏显式结构, 若不能将抽取得到的潜在特征稳定映射回样本层面, 则难以形成高质量的结构化数值数据.为此, 本文提出解耦潜在特征提取方法, 依次通过原子句划分与初始标签构建、潜在特征与情感对比学习、迭代聚类优化与潜在特征提取及赋值这3个步骤, 实现从潜在特征提取到结构化数值数据构建的完整过程.
2.1.1 原子句划分与初始标签构建
为了便于后续潜在特征分析与建模, 先将文本划分为最小语义单元, 并在此基础上构建原子句级标签, 为后续对比学习中的样本筛选与表示优化提供监督信号.通常直接使用传统规则(如标点符号或正则表达式)进行句子切分, 可能会出现拆分不完整、语义断裂的问题.为了解决这一问题, 本文采用分解型提示词引导LLM进行原子句划分.该提示词要求方法将原始文本拆分为仅包含单一观点或事实的短句, 保持各原子句语义完整, 不得添加原文中不存在的信息, 并以JSON格式返回原子句集合.
完整提示模板如下所示.
system_prompt="""You are an expert in text decomposition.
Your task:
-Break the input text into multiple atomic sentences.
-Each atomic sentence must describe only one idea, fact, or opinion.
-Preserve the original meaning, sentiment, entities, and factual details.
-Keep the original wording whenever possible.
-Do NOT add, delete, infer, summarize, or rewrite information.
Output format:
Return strict JSON in the following format:
{"sentences": ["sentence 1", "sentence 2"]}"""
对于文本样本集
D=(xn, tn
其中, xn表示第n个原始文本样本, tn表示对应的目标变量取值, N表示文本样本总数.对于任意文本样本xn, 通过LLM拆分得到第n个文本样本的原子句集合:
Sn={sn1, sn2, …,
其中mn表示该样本被拆分后的原子句数量.每个原子句均作为最小语义单元, 保证其在语义上相对独立且完整.
将所有样本拆分得到的原子句集合合并, 得到全局原子句集合:
$S=\bigcup_{n=1}^{N} S_{n}=\left\{s_{1}, s_{2}, \cdots, s_{M}\right\}, $
其中, $M=\sum_{n=1}^{N} m_{n}$表示所有文本样本被拆分后得到的原子句总数.
下面为每个原子句si构建潜在特征标签
其中, K表示预设的初始聚类数, 即潜在特征簇数量.根据原子句所属文本样本的目标变量tn构建情感标签:
上述潜在特征标签
2.1.2 潜在特征-情感对比学习机制
在完成原子句划分与初始标签构建后, 本文进一步优化原子句表示, 目的在于学习更适合潜在特征聚类的表示.尽管在2.1.1节中已通过原子句划分将原始文本细化为语义更清晰的最小单元, 但通用句嵌入仍可能同时编码原子句描述的潜在特征语义与情感信息, 从而导致描述同一潜在特征的句子因情感差异而被拉远, 或描述不同潜在特征的句子因相似情感而被错误聚合.为此, 本文引入潜在特征-情感对比学习机制, 分别学习原子句的潜在特征语义表示与情感表示, 对句子表示中的潜在特征语义与情感信息进行解耦优化, 削弱情感信息对潜在特征聚类的干扰.
对于每个原子句si, 首先将其句向量ei分别输入两个独立的多层感知机(Multilayer Perceptron, MLP), 得到潜在特征空间表示
和情感空间表示
其中,
为了构造对比学习样本对, 本文采用“ 回译增强+标签筛选” 的方式生成正负样本.其中:正样本由原子句si经LLM回译得到的增强句sj(i)构成, 其中j(i)表示与样本i配对的正样本索引; 负样本依据2.1.1节中获得的标签进行筛选.设原子句si及其正样本sj(i)在潜在特征空间中的表示分别为
和情感对比损失
其中, B表示当前批量中的原子句数量, τ 表示温度参数, sim(· , · )表示余弦相似度, 指示函数1[· ]用于筛选负样本, 所选样本既不与当前样本属于同一潜在特征/情感类别, 也不与自身样本重叠.
最终损失函数为:
L=
通过优化上述损失函数, 方法能在潜在特征嵌入空间和情感嵌入空间中分别学习解耦表示, 从而为后续迭代聚类优化及潜在特征提取与赋值提供更稳定清晰的表示基础.
2.1.3 迭代聚类优化与潜在特征提取及赋值
通过潜在特征-情感对比学习机制获得原子句在潜在特征空间表示
重新执行K-means聚类, 得到更新后的潜在特征伪标签
为了判断聚类是否达到稳定状态, TCFS使用轮廓系数(Silhouette Score)进行评估.设样本i所在簇为A, b(i)表示i到最近的其它簇的平均距离, a(i)表示i在簇A内的平均距离, 则样本i的轮廓系数:
s(i)=
第r轮迭代后, 整个聚类的轮廓系数为所有样本的平均值, 即
S(r)=
若相邻两轮迭代的轮廓系数变化足够小, 或达到预设最大迭代轮数, 则认为聚类过程收敛或结束.具体停止条件设定为
|S(r)-S(r-1)|≤ ε 或r≥ Tmax,
其中, ε 表示收敛阈值, Tmax表示最大迭代轮数.满足任一条件时, 停止迭代, 得到最终稳定的潜在特征簇结构.
在得到最终的潜在特征簇C后, TCFS从每个簇中选取若干离簇中心最近的关键句
Sj={s1, s2, …, sm}
作为最具代表性的句子样本, 其中m表示从第j个潜在特征簇中选取的代表句数量.然后将这些关键句输入LLM, 通过系统提示引导方法提取第j个潜在特征簇的潜在特征名称:
fj=LLM(Sj, prompt),
其中, Sj表示簇中选出的关键句集合, prompt表示用于引导LLM根据簇代表句生成潜在特征名称的抽象概括型提示模板.本文采用抽象概括型提示词引导LLM根据簇代表句生成简洁、抽象且具有可解释性的潜在特征名称, 并要求方法避免输出同义、重复或过于具体的特征概念.
完整提示模板如下.
system_prompt=f"""
You are a text analysis expert. Your task is to identify one core abstract factor shared by a set of representative sentences.
##Extraction Guidelines:
1.Output one concise and generalized semantic concept, preferably expressed in 1~2 English words.
2.The factor should represent the common high-level meaning of the representative sentences.
3.Avoid synonyms or semantically overlapping factors. Unify similar concepts.
4.Do not output generic placeholders such as "factor", "feature", "aspect", or "attribute".
5.If a concept has already been extracted, do not repeat it or use a synonymous expression.
6.Do not output specific objects, descriptive phrases, sentiment words, or low-level details.
Existing factors: {", ".join(existing_factors)}
Please strictly return JSON in the following format: {{"factor": "factor_name"}} """
在完成潜在特征提取后, 为每个文本生成对应潜在特征的赋值.具体地, 本文将文本与候选特征集合一并输入LLM, 引导方法判断评论中各潜在特征对应的赋值结果.
完整提示模板如下.
prompt_template={"template": """[Role Definition]
You are a professional text analysis assistant. Please process user-provided texts according to these strict instructions:
# Annotation Rules
# Important!When evaluating factors:
-Consider all synonyms as equivalent to the main factor
-Unify similar or synonymous terms into the core factor concept
#Evaluation Criteria
-Positive (1):
-Clearly positive descriptions
-Degree adverbs + positive expressions
-Negative (-1):
-Clearly negative descriptions
-Negation words + neutral terms
-Not Mentioned (0):
-Assign 0 only if the factor or any of its synonyms are definitely not mentioned
-Do not assign 0 if the factor is implied, indirectly referenced, or expressed using synonyms
#Current Task
##Feature List
{factors}
## texts to Annotate
{texts}
Please provide the output: """,
"factors": factor_columns, "criteria": criteria}
该模板要求方法将每个潜在特征标记为正向(1)、负向(-1)或未提及(0), 从而生成结构化的特征赋值向量.对于文本xi中的第j个潜在特征fj, 赋值
vij=
最终得到的所有向量与目标变量ti结合, 形成结构化数据矩阵:
XF=
其中, N表示评论数量, K表示潜在特征总数,
vi=[vi1, vi2, …, viK]
表示第i条文本对应的每个潜在特征的取值.该矩阵即为后续动态因果特征选择的输入, 用于识别与目标变量t存在潜在因果关联的关键因果特征.
为了便于整体展示潜在特征提取与赋值模块的执行流程, 给出该模块的完整伪代码描述.
算法1 解耦潜在特征提取方法
输入 文本样本集D={(xn, tn)
输出 潜在特征集合F, 样本级结构化特征表示XF
$S \leftarrow \bigcup_{n=1}^{N} \text { LLM-Split }\left(x_{n}\right)$
对原子句集合S进行编码, 得到句向量ei
对各原子句进行回译增强并编码, 得到增强句向量ej(i)
根据原子句所属样本的目标变量tn构建初始情感标签
{
for r=1 to Tmaxdo
基于ei、ej(i)、
{
计算当前轮廓系数S(r)
if r> 1 and |S(r)-S(r-1)|≤ ε then
break
end if
end for
根据最终伪标签
从各簇Cj中选择代表句集合Sj, 并生成潜在特征名称fj← LLM(Sj, prompt)
F← {f1, f2, …, fK}
对每个样本xi, 根据潜在特征集合F生成赋值向量vi
XF←
return F, XF
2.2.1 理论分析与识别边界
本文采用基于条件独立性检验的马尔可夫毯(MB)学习方法, 从当前已提取并完成赋值的潜在特征集合上, 识别与目标变量t具有局部依赖关系的候选特征.设当前观测变量集合
V=F∪ {t},
其中
F={f1, f2, …, fm},
表示当前已提取并完成赋值的潜在特征集合.若进一步将条件独立性检验得到的结果解释为具有局部因果结构意义的MB候选集合, 需要依赖如下基本假设.
1)因果马尔可夫假设.假设观测变量的联合概率分布满足因果马尔可夫条件, 即任一变量在给定其父节点后, 与其非后代变量条件独立.在该假设下, 因果图中的d-分离关系能在观测概率分布中表现为相应的条件独立关系, 从而为利用条件独立性检验识别目标变量的MB提供理论基础.
2)因果忠实性假设.假设观测概率分布中存在的条件独立关系均能由因果图中的d-分离关系解释, 不存在由参数抵消或特殊概率分布产生的额外条件独立关系.若该假设不成立, 因果图中真实相邻的变量可能被错误判定为条件独立, 从而造成MB成员的漏选.
3)相对因果充分性假设.相对于当前观测变量集合V, 假设候选潜在特征与目标变量t之间不存在同时影响二者、但未被观测的重要共同原因.需要指出的是, 在文本场景中, 该假设可能受到两类未观测因素的影响.第1类是未在文本中显式表达的外部因素, 如用户先验偏好、实际产品质量、促销活动、物流条件、消费场景及时间环境等.这些因素可能同时影响评论中的潜在特征表达与最终评分, 但无法仅根据评论文本进行观测.第2类是已在文本中表达, 但未被潜在特征提取与赋值模块正确结构化表示的语义因素.如原子句划分误差、潜在特征聚类偏差、LLM命名粒度不一致及特征赋值误差, 均可能导致相关语义因素未进入当前观测潜在特征集合.
当上述未观测因素存在时, 某些候选潜在特征可能仅因共同原因而与目标变量表现出统计依赖, 从而被误识别为MB候选成员.同时, 真实相关特征也可能因提取或赋值遗漏而未进入候选变量集合.因此, 本文采用的因果充分性假设仅适用于当前已提取并完成赋值的观测潜在特征集合, 并不意味着文本及现实环境中的所有潜在因素均已被完整观测.
4)条件独立性检验可靠性假设.假设当前样本规模能支持采用的条件独立性检验, 并且潜在特征提取与赋值过程中产生的误差不会严重改变变量之间的统计依赖关系.有限样本、潜在特征赋值噪声、LLM生成误差及条件集合规模增加等因素, 均可能导致条件独立性检验结果偏离真实关系, 进而造成MB成员的误选或漏选.
在因果贝叶斯网络及上述假设成立的条件下, 目标变量t的MB理论上由其父节点、子节点及子节点的其它父节点, 即配偶节点组成, 相应公式为:
MB(t)=Parents(t)∪ Children(t)∪ Spouses(t).
给定MB(t)后, 目标变量t与观测变量集合上的其余变量条件独立, 即
t⊥V\(MB(t)∪ {t})|MB(t).
因此, MB是使目标变量在给定该集合后与其余观测变量条件独立的最小变量集合, 可视为相对于当前观测变量空间预测目标变量所需的局部充分特征集合.
需要说明的是, 上述公式描述MB的理论组成.本文采用的动态MB学习方法主要识别目标变量的父/子邻接候选集合, 而不是进一步区分其中各变量相对于目标变量的具体因果方向.令PC(t)表示目标变量的父/子邻接候选集合, SP(t)表示配偶候选集合, 则本文实际估计的MB表示为
为了简化后续表述, 下文若无特别说明, 将TCFS在当前观测特征空间下得到的估计结果
总之, 本文所称的“ 关键因果特征” 是指在当前已提取并完成赋值的观测潜在特征集合中, 通过条件独立性检验识别得到的MB候选成员, 并不等同于现实完整因果系统中目标变量的直接原因.当存在未观测混杂因素、潜在特征提取遗漏、特征赋值误差或条件独立性检验偏差时, 所得结果仅反映当前观测特征空间下的局部依赖关系与可能的因果结构信息.
2.2.2 动态MB识别与更新机制
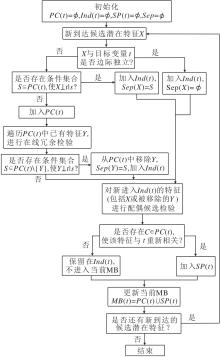
在上述理论假设与识别边界下, 为了适应候选潜在特征在反馈过程中持续增加的场景, 提出基于MB的动态因果特征选择方法, 在当前候选潜在特征集合上持续维护目标变量t的局部相关特征集合, 实现新增特征的动态纳入与冗余特征的在线删除, 整体流程如图2所示.
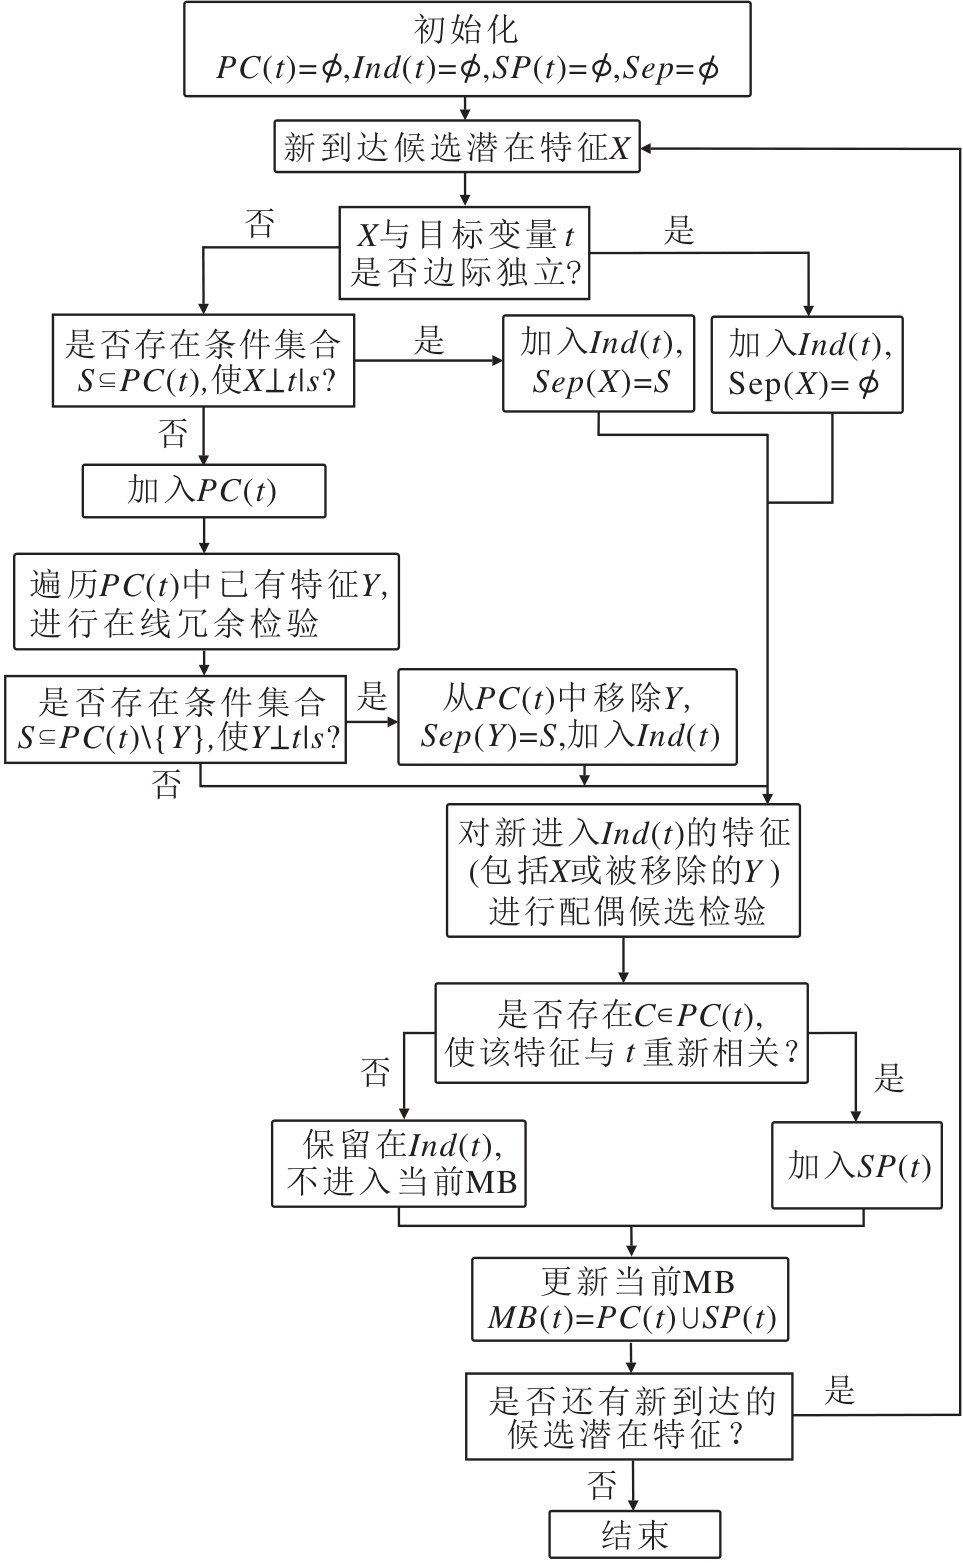 | 图2 动态因果特征选择方法流程图Fig.2 Flowchart of dynamic causal feature selection method |
为了完整描述动态MB的识别与更新过程, 本文维护父/子邻接候选集合PC(t)、独立特征集合Ind(t)、分离集映射Sep及配偶候选集合SP(t).PC(t)保存当前与目标变量保持局部条件依赖关系的父/子邻接候选特征.Ind(t)保存当前被判定为与目标变量边际独立或条件独立的特征.Sep(X)表示候选特征X对应的分离集, 即使候选特征X与目标变量t条件独立的条件集合.SP(t)保存根据局部碰撞结构性质识别得到的配偶候选特征.在首次筛选前, 将PC(t)、Ind(t)、SP(t)初始化为空集, 并将Sep初始化为空映射.针对初始候选潜在特征按照潜在特征提取模块的输出顺序依次处理, 反馈阶段发现的新增潜在特征按照发现顺序被追加至当前特征流.
本文采用基于核的条件独立性检验(Kernel-Based Conditional Independence, KCI)判断变量之间的边际独立性和条件独立性, 设置显著性水平α =0.05, 设KCI检验得到的p值为p(X, t|S), 其中S表示条件集合.当p(X, t|S)> α 时, 认为候选特征X与目标变量t在给定条件集合S后条件独立, 即X⊥t|S; 当p(X, t|S)≤ α 时, 认为二者在给定条件集合S后仍然条件相关, 即X⊥/ t|S.
如图2所示, 对于每个新到达的候选潜在特征X, 首先检验其与目标变量t的边际独立性.若二者在无条件情况下独立, 将X加入独立特征集合, 并将其分离集记录为空集:
Ind(t)← Ind(t)∪ {X}, Sep(X)=Ø .
需要指出的是, 边际独立的特征不一定完全与目标变量无关, 仍可能在给定某个邻接候选特征后重新表现为条件相关, 从而成为配偶候选.因此, 进入Ind(t)的特征仍需接受后续配偶候选检验.
若X与目标变量t边际相关, 进一步从当前父/子邻接候选集合PC(t)中选取条件子集S⊆PC(t), 并检验X与t在给定S后的条件独立关系.若存在某个条件集合S, 使得X⊥t|S, 说明在控制当前已有候选特征后, X与目标变量之间不再具有额外的局部依赖关系.此时, 将X加入独立特征集合, 并记录相应的分离集:
Ind(t)← Ind(t)∪ {X}, Sep(X)=S.
若在允许的条件集合范围内均不存在能使X与目标变量t条件独立的集合, 即对于检验的条件子集均满足X⊥/ t|S, 则将X加入父/子邻接候选集合:
PC(t)← PC(t)∪ {X}.
当新特征进入PC(t)后, 已有候选特征与目标变量之间的条件独立关系可能发生变化.因此, 进一步对当前PC(t)中的已有候选特征执行在线冗余检验.对于任意特征Y∈ PC(t), 从除Y以外的父/子邻接候选特征中选择条件集合S⊆PC(t)\{Y}.
若存在某个条件集合S, 使得Y⊥t|S, 则说明Y与目标变量之间的局部依赖关系可由其它候选特征解释.此时, 将Y从父/子邻接候选集合上移除, 并记录其分离集:
PC(t)← PC(t)\{Y}, Sep(Y)=S,
Ind(t)← Ind(t)∪ {Y}.
被移除的候选特征不会被直接完全舍弃, 而是继续接受配偶候选检验.该机制使算法不仅能动态接收新增特征, 还能根据新增变量引起的条件依赖关系变化及时删除已有冗余特征.
对于进入Ind(t)的候选特征, 进一步结合当前父/子邻接候选集合进行配偶候选识别.在因果贝叶斯网络中, 若候选特征X与目标变量t共同指向某个邻接变量C, 则可能形成碰撞结构X→ C← t.
在该结构下, X与t可能在未给定C时相互独立, 但在给定C后重新表现为条件相关.因此, 对于X∈ Ind(t)及C∈ PC(t), 若X在其分离集条件下与目标变量独立, 即X⊥t∣Sep(X), 但在进一步给定候选邻接特征C后重新表现为条件相关, 即
X⊥/ t|Sep(X)∪ {C},
则将X作为配偶候选加入SP(t), 即
SP(t)← SP(t)∪ {X},
否则, X继续保留在Ind(t)中, 不进入当前MB.这里识别的是依据局部条件独立关系得到的配偶候选, 而不是经过完整因果定向确认的配偶节点.
完成父/子邻接候选识别、在线冗余删除和配偶候选识别后, 按照
MB(t)=PC(t)∪ SP(t)
更新目标变量当前的MB.当后续缺失特征发现机制产生新的候选潜在特征时, 保留上一轮得到的PC(t)、Ind(t)、Sep和SP(t)等状态, 并对新增特征及受其影响的已有候选特征重新执行上述条件独立性检验, 同时更新相应的候选集与分离集, 而不重新对全部候选潜在特征执行从头筛选策略.由此, 方法能在候选潜在特征集合持续变化的情况下动态维护与目标变量相关的MB, 并及时删除因新增特征而变得冗余的已有候选特征.
2.2.3 缺失特征发现机制
在真实文本场景中, 由于非结构化文本具有较强的多样性和复杂性, 单轮潜在特征提取与因果特征选择往往难以一次性识别全部关键因果特征.也就是说, 即便当前MB已能较好地解释大部分样本, 仍可能存在一部分样本在当前关键因果特征视角下难以被充分解释.为此, 本文进一步引入特征反馈机制, 对这些仍未被有效解释的样本进行针对性分析, 并通过反馈挖掘补充新的潜在特征, 从而持续优化潜在特征集合与MB.
与面向原子句表示的潜在特征提取过程不同, 缺失特征发现阶段聚焦样本级反馈分析.具体而言, 依据当前MB从结构化特征矩阵中提取对应列, 构建每个样本在当前关键因果特征子集下的表示, 并在该MB子空间中重新对样本进行聚类, 从当前关键因果特征视角刻画样本分布.设第i个样本的真实目标变量为ti, 基于当前MB训练得到的预测模型输出为
δ i=|ti-
在当前MB子空间完成样本聚类后, 设得到的样本簇集合
G={G1, G2, …, GR},
其中, R表示样本簇总数, Gq(q=1, 2, …, R)表示第q个样本簇.对每个簇内样本, 统计平均预测误差:
$\bar{\delta}_{q}=\frac{1}{\left|G_{q}\right|} \sum_{x_{i} \in G_{q}} \delta_{i} .$
簇平均误差越大, 说明该簇中的样本在当前MB条件下越难被模型解释.需要指出的是, 较高预测误差并不必然意味着当前MB遗漏真实因果特征.预测误差还可能来源于标签噪声、有限样本、预测模型设定偏差、潜在特征赋值误差、LLM生成误差及未观测外部因素等.因此, 本文不将高误差样本直接视为遗漏因果特征的证据, 而仅将平均预测误差较高的样本簇作为反馈候选, 用于优先分析当前特征表示与预测模型难以充分解释的文本.在得到难解释簇后, 将其中样本作为反馈样本重新输入2.1节描述的潜在特征提取模块, 引导LLM从这些样本中继续挖掘新的潜在特征, 揭示当前MB尚未覆盖的因果信息.然后, 基于新增潜在特征重新执行特征赋值, 更新结构化特征矩阵, 并进一步动态更新MB.通过这种“ 筛选-解释-反馈-更新” 的闭环机制, 方法能在迭代过程中补充可能遗漏的候选潜在特征, 提升潜在特征集合的完整性及关键因果特征筛选结果的鲁棒性与可解释性.当反馈样本中不再能挖掘新的潜在特征, 或达到预设最大反馈迭代轮数时, 反馈过程终止.此时得到的潜在特征集合与MB被视为最终结果.
本节对TCFS在不同LLM和数据集上的性能进行系统评估, 重点考察潜在特征提取质量、潜在特征赋值质量、基于MB筛选的关键因果特征子集的识别效果.
实验在AppleGastronome(AG)、Watermelon(WM)电商评论数据集上进行, 涵盖合成电商场景和真实电商场景.AG是合成电商评论数据集, 包含用户关于苹果商品的200条评论, 用于评估方法在可控场景中的潜在特征发现质量与因果特征选择能力.Watermelon(WM)是来自沃尔玛平台的真实评论数据集, 包含778条实例数, 用于评估方法在真实复杂场景中的泛化能力.
考虑到不同LLM在指令遵循、文本拆分、语义概括、结构化输出和特征赋值等方面存在差异, 本文选取DeepSeek、Qwen两个系列进行实验, 共包括DeepSeek-R1∶ 8b、DeepSeek-R1∶ 14b、DeepSeek-V3.2、Qwen3∶ 8b、Qwen3∶ 14b、Qwen3∶ 32b、Qwen-max、Qwen-plus.上述方法覆盖不同系列、参数规模及调用方式.DeepSeek-R1∶ 8b、DeepSeek-R1∶ 14b、Qwen3∶ 8b、Qwen3∶ 14b和Qwen3∶ 32b用于考察不同参数规模下模型能力变化对实验结果的影响; DeepSeek-V3.2、Qwen-max和Qwen-plus用于考察云端通用模型在较强指令理解与结构化生成能力下的表现.同时选择DeepSeek和Qwen两个系列, 可降低实验结论对单一模型家族的依赖, 并评价TCFS在不同LLM配置下的适应性与稳定性.
在每组完整实验中, 原子句划分、回译增强、潜在特征命名、潜在特征赋值及反馈候选特征发现均使用同一个LLM, 避免在同次实验中混用不同模型带来的额外影响.不同方法在相同模型配置下采用一致的数据输入、提示词结构、输出格式要求、最大迭代轮数和评价指标.所有LLM输出均采用JSON或预定义结构进行约束.对于格式错误、字段缺失或解析失败的情况, 采用统一的重试和异常处理机制.
本文选择DATA+CoT(DATA with Chain-of-Thought Prompting)和COAT[6]作为对比方法.DATA+CoT是文献[6]中设置的LLM基线.该方法将任务描述、目标变量及部分原始文本样本输入LLM, 并通过链式思维提示引导模型分析文本中可能与目标变量相关的高层潜在特征.DATA+CoT主要依赖LLM自身的文本理解与推理能力进行特征发现, 不进一步学习结构化因果图, 也不依据因果发现结果进行多轮反馈更新.COAT为面向非结构化观测数据的因果表示学习框架, 首先利用LLM提出候选潜在特征及其赋值规则, 对原始文本执行样本级特征赋值, 将其转化为结构化数值数据.然后采用因果发现算法学习目标变量与候选特征之间的因果结构, 并依据当前因果发现结果筛选难以被已有特征解释的样本, 反馈给LLM继续补充候选潜在特征.
为了保证公平性, TCFS与COAT在每组实验中采用相同的数据集、目标变量、LLM配置和评价指标.两种方法的最大反馈迭代轮数均设为3.在当前轮次未发现新的候选潜在特征、无法获得有效反馈样本, 或达到预设的最大迭代轮数时, 终止迭代.LLM输出均采用JSON结构进行约束, 若输出解析失败, 最多重试5次.重试后仍未获得有效结果时, 将当前样本相应潜在特征的赋值设为0.在因果特征选择阶段, 两种方法均采用KCI进行条件独立性检验, 显著性水平设为0.05.此外, 在TCFS的反馈样本筛选阶段, 采用K-means对当前结构化特征空间中的样本进行聚类, 设置聚类数为当前候选潜在特征数量加1, 随机种子数为42, 初始化次数为10.
本文从如下3个方面评估方法性能.1)潜在特征提取质量, 使用Recall、Precision、F1指标衡量从文本中抽取的潜在特征与Ground Truth的一致性.2)潜在特征赋值质量, 用于评估潜在特征经赋值后构成结构化数值数据的准确性, 即样本在各潜在特征上的赋值结果与标注结果的一致程度.3)关键因果特征识别性能, 用于评估选择后得到的关键因果特征子集与Ground Truth的匹配情况, 同样使用Recall、Precision、F1指标进行衡量.
AG、WM数据集上, 不同规模LLM下各方法在潜在特征提取任务上的指标值如表1所示, 表中黑体数字表示最优值.由表可见, TCFS在多数配置下取得更优或更稳定的结果, 说明其能从原始文本中识别更多真实存在的潜在特征, 同时保持较优的提取质量.具体来看, TCFS的优势主要体现在两个方面:1)Recall值普遍更高, 说明其能识别更多真实存在的潜在特征; 2)在多数配置下Precision值仍保持在较高水平, 从而使F1值获得稳定提升.尽管在个别模型配置下, 随着Recall值的提高, Precision值会出现一定波动, 但整体趋势表明, TCFS能在提升潜在特征覆盖度的同时, 保持较好的综合提取质量.尤其是在更复杂的WM真实评论场景中, TCFS的优势更明显, 说明其对噪声干扰和多样化表达具有更好的适应能力.
 | 表1 各方法在潜在特征提取任务上的指标值 Table 1 Metric values of different methods on latent feature extraction task % |
上述结果表明, 通过对比学习实现潜在特征嵌入与情感嵌入的解耦, 以及迭代聚类优化, TCFS能将语义相近的句子聚集在同一潜在特征簇中, 从而显著提升潜在特征提取的全面性与稳定性.因此, TCFS能在不同模型规模和不同数据复杂度下, 更稳定提升潜在特征提取的全面性与综合质量.
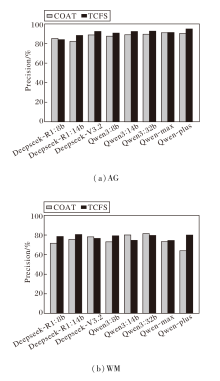
在潜在特征赋值阶段, 筛选的潜在特征子集被映射为结构化表示, 本文通过实验评估TCFS对潜在特征的赋值准确性.AG、WM数据集上的潜在特征赋值结果如图3所示.
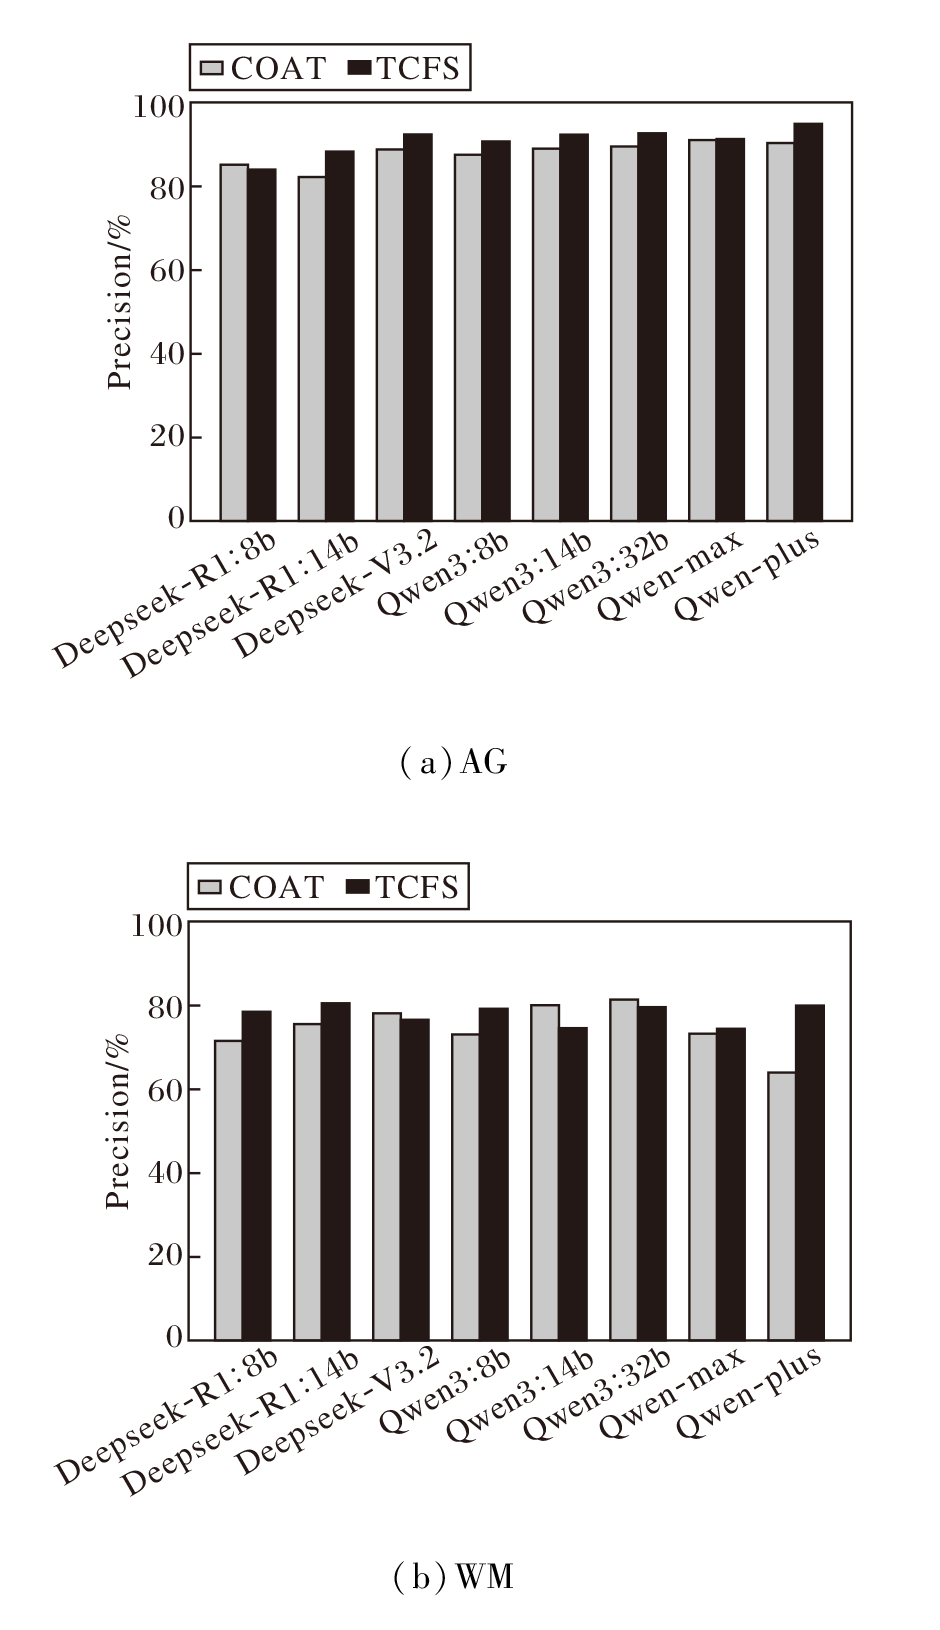 | 图3 各数据集上潜在特征赋值结果Fig.3 Latent feature assignment results on different datasets |
由图3可见, TCFS在2个数据集上均表现出较优的潜在特征赋值能力.在AG数据集上, TCFS在各模型配置下整体优于COAT, 表现出较好的稳定性与一致性.在更复杂的WM数据集上, TCFS在大多数模型配置下仍取得更高的赋值准确率, 说明该方法在不同规模LLM和不同复杂度评论场景中均能有效改善潜在特征赋值质量.不过, 相比AG数据集, WM数据集上的结果波动更大, 个别模型配置下TCFS与COAT的指标值差距较小, 甚至略低于COAT.这表明在更具挑战性的场景中, 潜在特征赋值性能仍会受到模型能力和数据复杂度的共同影响.
总之, TCFS在2个数据集上均表现出较优的潜在特征赋值能力.其原因在于:前一阶段潜在特征提取性能的提升, 尤其是更高的F1值, 表明获得的潜在特征集合能更准确、完整地覆盖目标潜在特征, 同时减少冗余潜在特征带来的干扰.在此基础上, LLM在后续赋值阶段能基于更清晰、紧凑的候选潜在特征集合进行判断, 从而有效降低赋值歧义并提升整体赋值准确性.
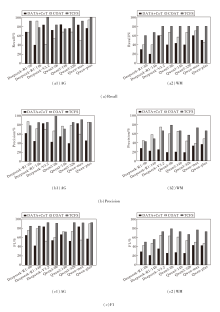
MB学习用于进一步筛选与目标变量最相关的关键因果特征子集.在AG、WM数据集上及不同规模LLM配置下, DATA+CoT、COAT、TCFS在因果特征学习阶段的指标值如图4所示.由图可见, 在AG数据集上, TCFS的Recall值整体位于两种对比方法之上, 并且在多数模型配置下保持较高水平, 说明其能更充分保留与目标变量相关的有效特征.Precision值虽然在个别模型配置下存在一定波动, 但整体仍保持较强竞争力, 因此F1值在大多数配置下也处于领先或并列领先位置.
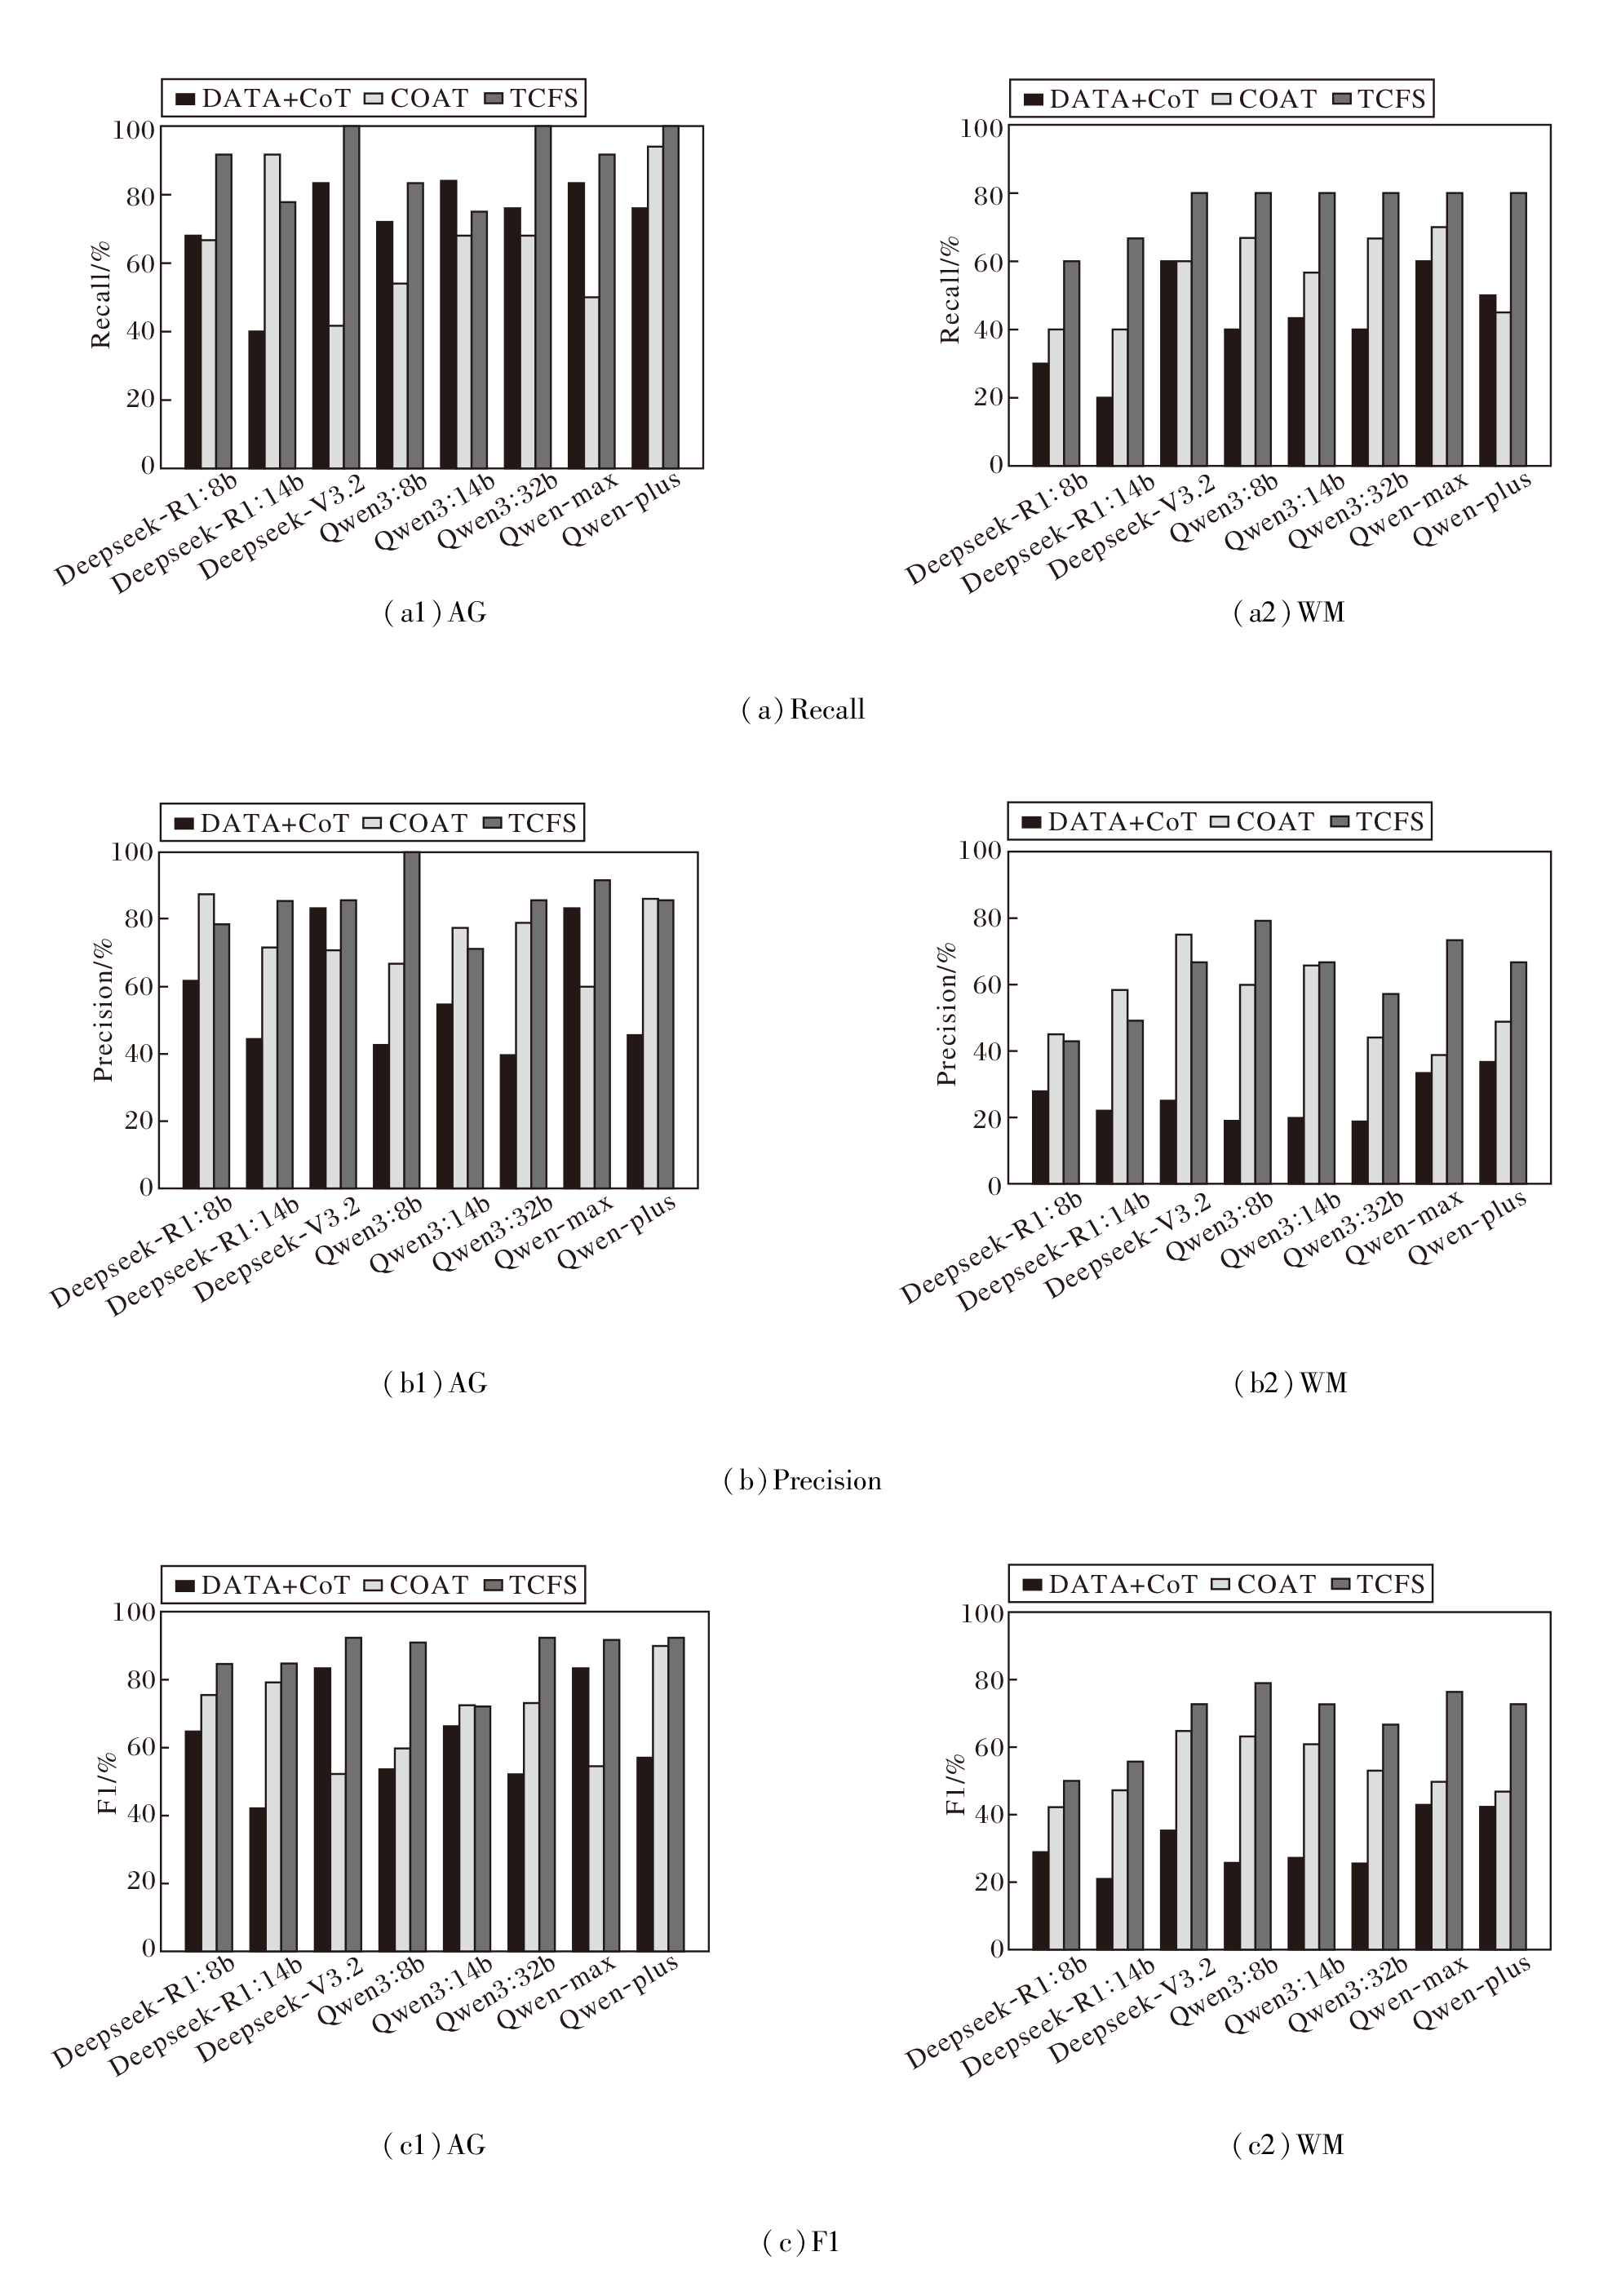 | 图4 各方法在因果特征学习阶段的指标值Fig.4 Metric values of different methods in the causal feature learning stage |
相比之下, 在WM数据集上, TCFS的优势更明显:Recall值几乎在所有模型配置下都是最高, F1值也整体保持领先.这说明在真实评论场景中, TCFS仍能较充分识别与目标变量相关的关键因果特征.与此同时, 相比AG数据集, WM数据集上的Precision、F1指标波动更大, 这也表明在更复杂、更具噪声的场景中, 关键因果特征识别更具挑战性.
TCFS在MB学习阶段取得更优性能, 主要原因在于其采用动态因果特征选择方法, 能随候选潜在特征集合的变化持续维护目标变量的MB, 而不必在每次潜在特征更新后重新对全量候选潜在特征集合执行“ 从头再筛” 策略.这种动态更新机制能更及时地保留与目标变量具有真实相关性的新增潜在特征, 同时剔除已被其它特征解释的冗余特征, 从而在提升关键因果特征覆盖率的同时抑制无关特征的引入.
总之, TCFS采用的动态因果特征学习方法能更有效地从候选潜在特征中筛选真正与目标变量相关的关键因果特征子集, 并在不同规模LLM与不同复杂度数据场景中保持较好的稳定性与鲁棒性, 从而稳定提升关键因果特征识别效果.
为了进一步验证TCFS识别关键因果特征的实际应用价值, 基于在AG数据集上经过最终轮迭代得到的结构化特征数据, 开展下游评分预测实验, 考察所选MB特征在减少输入特征数量的同时, 能否保留与目标评分相关的有效信息.
设置4类输入特征集合:全部候选潜在特征(All Features)、TCFS识别得到的MB特征(TCFS-MB)、基于互信息(Mutual Information, MI)筛选得到的MI-TopK、基于最小绝对收缩与选择算子(Least Absolute Shrinkage and Selection Operator, LASSO)回归系数绝对值筛选得到的Lasso-TopK.为了保证公平, MI和Lasso所选特征数量K与对应TCFS-MB的特征数量保持一致.Qwen3∶ 8b配置下共有10个候选特征, TCFS-MB包含6个特征, 因此设置MI-Top6和Lasso-Top6.Qwen-plus配置下共有10个候选特征, TCFS-MB包含9个特征, 因此设置MI-Top9和Lasso-Top9.
本文选取Ridge回归、随机森林回归和支持向量回归(Support Vector Regression, SVR)作为下游预测模型, 并采用五折交叉验证, 即每次使用4份数据训练模型、剩余1份用于测试, 重复5次后取平均结果.评价指标包括平均绝对误差(Mean Absolute Error, MAE)、均方根误差(Root Mean Squared Error, RMSE)和决定系数R2.MAE和RMSE值越低、R2值越高, 表示预测性能越优.对于MI和Lasso, 每折均仅使用训练数据完成特征选择, 避免测试信息泄漏.
相应下游评分预测结果如表2和表3所示, 表中黑体数字表示最优值.
| 表2 Qwen3∶ 8b配置下不同特征集合的下游评分预测结果 Table 2 Downstream rating prediction results of different feature subsets under Qwen3∶ 8b configuration |
| 表3 Qwen-plus配置下不同特征集合的下游评分预测结果 Table 3 Downstream rating prediction results of different feature subsets under Qwen-plus configuration |
由表2和表3可见, 综合2种LLM配置和3种下游预测模型, TCFS-MB在6组实验中的4组上取得整体最优结果, 并在全部实验中均优于All Fea-tures.由此表明, TCFS识别的MB特征能在压缩特征空间的同时, 较好地保留与目标评分相关的信息, 具有一定的下游预测价值.
为了验证情感监督分支对潜在特征表示学习及后续关键因果特征识别的作用, 构造变体TCFS-w/oSent.该变体去除样本级情感标签、情感表示分支及情感对比损失, 仅保留基于潜在特征聚类伪标签的潜在特征对比学习.除了上述修改以外, 原子句划分、回译增强、初始聚类数、训练轮数、LLM配置、潜在特征命名、特征赋值及动态MB学习等设置均与TCFS保持一致.
分别在AG、WM数据集上, 采用Qwen3∶ 8b和Qwen-plus配置进行实验, 从潜在特征提取和关键因果特征识别两个阶段评价情感分支的作用, 结果如表4和表5所示, 表中黑体数字表示最优值.由表可知, 去除情感分支后, TCFS在2个数据集上的潜在特征提取与关键因果特征识别性能均有所下降, 且Precision、F1指标的下降较明显.这说明仅依赖潜在特征聚类伪标签虽然能保持一定的特征覆盖能力, 但容易引入冗余或不准确的候选特征.情感分支能降低情感信息对潜在特征表示的干扰, 提高潜在特征提取质量及后续关键因果特征识别效果.
| 表4 TCFS-w/oSent和TCFS的潜在特征提取结果 Table 4 Latent feature extraction results of TCFS-w/oSent and TCFS % |
| 表5 TCFS-w/oSent和TCFS的关键因果特征识别结果 Table 5 Key causal feature identification results of TCFS-w/oSent and TCFS % |
为了验证候选潜在特征持续增加时TCFS动态更新结果的稳定性, 在AG数据集上分别采用Qwen3∶ 8b和Qwen-plus配置, 执行TCFS, 对比相邻两轮MB特征集合的变化情况.设第r-1轮、第r轮得到的MB特征集合分别表示为Mr-1和Mr.本文采用Jaccard相似度
J(Mr-1, Mr)=
和特征保留率
R(Mr-1, Mr)=
评价相邻轮次之间的稳定性, 其中Jaccard相似度用于衡量相邻两轮MB集合的整体一致程度, 特征保留率用于衡量上一轮已识别特征在下一轮中的保留情况.两项指标值越高, 说明动态更新过程中已有MB结构受到的扰动越小.
AG数据集上不同LLM配置下动态MB更新结果如表6所示.
| 表6 AG数据集上不同LLM配置下动态MB更新结果 Table 6 Results of dynamic MB updating under different LLM configurations on AG dataset |
由表6可看出, 综合两种LLM配置, 第1次更新的平均Jaccard相似度为62.50%, 第2次更新后提升至86.11%.结果表明, 在候选潜在特征动态增加的过程中, TCFS能较好地保留已有关键特征, 并围绕新增信息对MB集合进行渐进式调整, 整体呈现出较好的连续性和一定的收敛趋势.需要说明的是, 动态稳定性并不意味着不同轮次的MB集合完全不变, 部分特征的新增或删除体现方法在获得更多候选信息后对当前局部MB结构的更新.
COAT和TCFS的总体运行时间如表7所示.由表可看出, 两种方法在不同数据规模下呈现出差异化的时间表现.在规模较小的AG数据集上, TCFS的运行时间略高于COAT.这主要是因为TCFS引入原子句划分、回译增强、双分支对比学习及迭代聚类优化等多个处理环节.当样本规模较小时, 这些模块的初始化与训练开销在总体运行时间中占比较高.与此同时, COAT中FCI(Fast Causal Inference)的全局因果发现计算压力尚未充分显现, 因此TCFS在小规模数据集上暂未体现出明显的效率优势.
| 表7 COAT与TCFS的总体运行时间对比 Table 7 Comparison of total running time of COAT and TCFS |
在规模较大的WM数据集上, COAT的运行时间显著增加, 而TCFS表现出更好的运行效率.其主要原因在于:COAT在每轮候选潜在特征更新后, 均需基于目标变量和当前全部特征重新执行FCI, 学习完整的全局因果图.随着样本规模和特征数量的增加, 重复执行全量FCI产生的计算开销会迅速累积.相比之下, TCFS将潜在特征的持续补充建模为动态特征流, 并围绕目标变量增量维护MB.对于每个新到达的候选特征, TCFS仅需执行与目标变量及当前父子邻接候选集合相关的条件独立性检验, 并通过在线冗余删除机制动态更新已有结果, 而无需重新学习所有变量之间的全局因果结构.因此, TCFS能有效减少特征集合变化后重复执行全量因果发现带来的额外计算开销, 在较大规模数据集上展现出更优的运行效率和可扩展性.
本文提出基于对比学习与大语言模型的文本因果特征选择方法(TCFS), 面向非结构化文本场景中关键因果特征发现问题, 形成从潜在特征提取与赋值到动态因果特征选择的完整流程.TCFS能从文本中较稳定地识别潜在特征, 并在候选潜在特征集合动态变化的条件下实现关键因果特征的持续筛选与更新.实验表明, TCFS在潜在特征提取、潜在特征赋值及关键因果特征识别等任务上均取得较优性能, 尤其在Recall、F1指标上表现出较稳定的优势, 说明其能充分识别与目标变量相关的关键因果特征, 并提升文本场景中因果特征选择的稳定性与准确性.未来可将TCFS扩展至多模态数据场景, 并进一步探索更复杂因果结构下的潜在特征发现与特征选择问题, 提升方法的普适性与鲁棒性.
本文责任编委 陈松灿
Recommended by Associate Editor CHEN Songcan
| [1] |
|
| [2] |
|
| [3] |
|
| [4] |
|
| [5] |
|
| [6] |
|
| [7] |
|
| [8] |
|
| [9] |
|
| [10] |
|
| [11] |
|
| [12] |
|
| [13] |
|
| [14] |
|
| [15] |
|
| [16] |
|
| [17] |
|
| [18] |
|
| [19] |
|
| [20] |
|
| [21] |
|
| [22] |
|
| [23] |
|
| [24] |
|
| [25] |
|
| [26] |
|
| [27] |
|