

基于全局轨迹感知的多相机多目标跟踪
[范宇腾1, 2  , 王强
3 , 甄奕豪1, 2 , 陈希爱1 , 马驰4 , 范慧杰1 ]
, 王强, 甄奕豪, 陈希爱, 马驰, 范慧杰]
|
|


作者简介:
范宇腾, 硕士研究生,主要研究方向为多相机多目标跟踪.E-mail:fanytncu@163.com.
王 强, 博士,副教授,主要研究方向为深度学习、多任务学习、图像恢复、视觉分析.E-mail:wangqiang@syu.edu.cn.
甄奕豪, 硕士研究生,主要研究方向为目标跟踪、视频生成、视频世界模型.E-mail:zhenyihao@sia.cn.
陈希爱, 博士,副研究员,主要研究方向为机器人视觉、图像处理、模式识别.E-mail:chenxiai@sia.cn.
马 驰, 博士,副教授,主要研究方向为模式识别、数据分析、机器学习.E-mail:machi@hzu.edu.cn.
现有全局跟踪方法主要将全局轨迹视为历史目标特征的集合,缺乏对轨迹级身份语义的显式建模与一致性约束,难以充分挖掘目标跨时空的长期身份一致性.针对上述问题,文中提出基于全局轨迹感知的多相机多目标跟踪方法(Global Trajectory-Aware Multi-camera Multi-target Tracking, GTAT).首先,设计全局轨迹语义编码模块,为每条全局轨迹聚合具有长期身份语义的轨迹级表示.再构建全局轨迹感知增强模块,利用交叉注意力机制将全局轨迹级身份语义注入时间窗口内的目标关联特征,实现目标级表示对轨迹级上下文信息的显式感知.最后,设计全局轨迹一致性损失,约束轨迹级表示与目标级关联特征之间的匹配关系,提升全局轨迹表示的身份一致性建模能力和关联特征的身份判别能力.实验表明,GTAT在6个公开多相机多目标跟踪数据集上均取得较优性能.
About Author:
FAN Yuteng, Master student. His research interests include multi-camera multi-object tracking.
WANG Qiang, Ph.D., associate profe-ssor. His research interests include deep learning, multi-task learning, image restoration, and visual analysis.
ZHEN Yihao, Master student. His research interests include object tracking, video generation, and video world models.
CHEN Xiai, Ph.D., associate professor. Her research interests include robot vision, image processing, and pattern recognition.
MAChi, Ph.D., associate professor. His research interests include pattern recognition, data analysis, and machine learning.
In existing global tracking methods, global trajectories are mainly treated as collections of historical target features. However, trajectory-level identity semantics are not explicitly modeled, and identity consistency constraints are not imposed. Therefore, the long-term identity consistency of targets across time and space cannot be fully exploited. To address these issues, a global trajectory-aware multi-camera multi-target tracking method termed GTAT is proposed. First, for each global trajectory, a trajectory-level representation with long-term identity semantics is aggregated by the global trajectory semantic encoding module. Then, global trajectory-level identity semantics are injected into target association features within the temporal window by the global trajectory-aware enhancement module through a cross-attention mechanism. Thus, trajectory-level contextual information can be explicitly perceived by target-level representations. Finally, a global trajectory consistency loss is designed to constrain the matching relationship between trajectory-level representations and target-level association features. Consequently, the ability of global trajectory representations to model identity consistency is improved. The identity discriminability of association features is also enhanced. Experiments demonstrate that GTAT achieves superior performance on six public multi-camera multi-target tracking datasets.
多相机多目标跟踪[1]的目标是在多个具有重叠视野的相机视角中定位并关联同一目标, 现已广泛应用于城市监控[2]、自动驾驶[3]、人群行为分析[4]、交通场景理解[5]等领域.相比传统的单视角跟踪[6], 多相机多目标跟踪的一个重要优势在于模型能融合来自多个视角的信息, 得到更丰富的视觉线索.这种信息多样性的提升使得目标建模更鲁棒和更具判别性[7], 从而在遮挡频繁或目标外观变化显著的场景中仍保持较优的跟踪性能[8].
多相机多目标跟踪方法可划分为两阶段范式和全局范式.现有传统方法以两阶段范式为主, 研究重点集中在跨相机跟踪.该范式将任务划分为单相机跟踪[9]和跨相机跟踪[10]两个阶段, 先利用现成的多目标跟踪器[11]完成单相机跟踪, 再对各视角下的跟踪结果进行跨相机关联.Specker[12]提出OCMC-Track, 在各相机视角内生成单相机轨迹并投影至世界坐标系, 再通过校正匹配级联机制动态重评估跨相机关联结果, 减少在线跟踪过程中的错误关联.Quach等[13]提出DyGLIP(Dynamic Graph Model with Link Prediction), 将多相机目标关联问题建模为动态图中的链路预测问题, 并结合注意力机制增强动态图表示, 提升数据关联的准确性.He等[14]提出TRACTA(Tracklet-to-Target Assignment), 将多相机数据关联问题建模为一个受约束的轨迹片段至目标匹配问题, 并通过受限非负矩阵分解求解满足约束条件的最优关联结果.Gan等[15]提出MvMHAT(Multi-view Multi-human Association and Tracking), 通过成对对称相似性与三元组传递相似性学习跨时间、跨视角的一致性表征, 实现跨视角关联.在MvMHAT的基础上, Feng等[16]进一步引入STAN(Spatio-Tem-poral Assignment Network), 将外观特征学习与分配矩阵优化统一至端到端自监督框架中, 并结合全局时空结构信息优化关联结果.针对多相机小目标跟踪中跨视角关联困难和遮挡严重的问题, Liu等[17]提出MIA-Net(Multi-matching Identity Authentication Network), 挖掘不同视角下目标拓扑关系, 实现跨相机身份关联与遮挡目标补全.Hao等[18]提出CrossMOT(Cross-View Multi-object Tracking), 在跟踪过程中联合优化单视角嵌入空间与跨视角嵌入空间, 实现更优的多视角目标特征之间的数据关联.
尽管两阶段范式取得较优效果, 但仍存在如下局限.1)在两阶段范式中, 最终的跟踪结果主要由单摄像头跟踪阶段决定, 由于该阶段仅依赖单视角内的信息, 因此对多视角信息的利用不充分.2)两阶段范式中任何一个阶段出现错误都会影响下一帧的结果, 相比全局范式, 产生误差累积的可能性更大[19].
为了解决上述问题, 研究趋势逐渐转向全局范式.Zhen等[20]提出GMT(Global Multi-camera Multi-target Tracking), 将历史时间窗口内来自不同视角的目标特征组织为全局轨迹, 将目标跟踪问题转化为全局轨迹-目标匹配问题.与两阶段范式先在单视角下完成跨时间跟踪、再进行跨视角匹配的方式不同, GMT使用的全局轨迹包含来自多个视角的信息, 因此可自然实现在跟踪过程中对多视角信息的利用.此外, 全局轨迹的编码形式实现对不同视角目标的ID统一, 对于新目标只需要进行一次匹配即可确定其ID, 避免不必要的两阶段匹配, 降低误差累积的可能.凭借对跨视角线索的直接利用, GMT的综合性能显著优于传统两阶段跟踪范式.在全局跟踪框架的基础上, Fan等[21]引入红外模态, 利用可见光与热红外信息的互补性[22], 提出ADMCMT(All-Day Multi-camera Multi-target Tracking Network).为了解决额外模态带来的计算开销问题, 文献[22]设计基于Mamba的轻量化特征融合模块, 同时提出邻近目标收集策略, 利用目标周围物体的信息增强跟踪精度.
虽然全局跟踪范式显著提升多相机跟踪性能, 但现有方法对全局轨迹本身的建模仍较粗浅.以GMT为代表的现有方法主要将全局轨迹组织为历史目标特征集合, 在关联阶段计算当前目标与轨迹内所有历史目标特征的相似度并取均值, 以此刻画轨迹与目标的匹配关系.该类方法本质上仍停留在目标级特征匹配层面, 缺乏对轨迹级身份语义的显式建模与统一表达.因此, 尽管模型能利用多视角下的历史目标信息, 却未能学习并使用可表征整条轨迹长期身份的轨迹级表示.
在多相机多目标跟踪任务中, 同一目标在不同时间与不同视角下具备稳定的身份一致性信息.例如:不同视角下的运动模式、外观结构及长期时空变化规律均能刻画同一目标的身份属性.若仅依赖目标级特征完成匹配, 模型难以充分利用这些跨时间、跨视角的长期身份信息, 在复杂遮挡、外观相似或剧烈视角变化场景中容易出现身份切换与跨视角关联错误.因此, 如何从全局轨迹中学习统一的轨迹级身份语义表示, 并进一步利用该表示增强目标级关联特征的判别能力, 成为当前全局多相机跟踪研究中的关键问题之一.
针对上述问题, 本文提出基于全局轨迹感知的多相机多目标跟踪方法(Global Trajectory-Aware Multi-camera Multi-target Tracking, GTAT).不同于GMT仅对全局轨迹隐式建模, GTAT从轨迹级身份建模的角度出发, 将全局轨迹表示学习与目标级关联特征增强融合至统一框架.首先, 设计全局轨迹感知模块(Global Trajectory-Aware Module, GTAM).先依托全局轨迹语义编码模块(Global Trajectory Semantic Encoding, GTSE), 引入可学习的全局轨迹令牌, 对跨时间、跨视角的历史目标特征进行聚合建模, 得到描述长期身份一致性的轨迹级表示.再通过全局轨迹感知增强模块(Global Trajectory-Aware Enhance-ment, GTAE), 利用交叉注意力机制, 将轨迹级身份语义显式注入时间窗口内的目标关联特征, 使目标级表示能感知全局轨迹上下文信息, 提升复杂场景中的跨视角关联鲁棒性.然后, 构建全局轨迹关联模块(Global-Level Trajectory Association, GTA), 对增强后的目标级关联特征与历史全局轨迹进行统一关联建模, 根据目标与轨迹之间的匹配关系完成全局身份分配, 并输出各目标对应的全局轨迹ID.最后, 提出全局轨迹一致性损失(Global Trajectory Con-sistency Loss, GTC), 约束轨迹级表示与目标级关联特征之间的匹配关系, 对轨迹级身份语义进行显式监督, 实现跨时间、跨视角条件下的身份一致性建模, 提升关联特征的判别能力.实验表明, GTAT在6个公开多相机多目标跟踪数据集上取得优于当前最强全局基线GMT的性能表现, 从而验证其在复杂跨视角场景中的有效性.
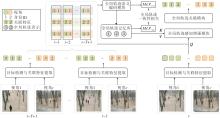
本文提出基于全局轨迹感知的多相机多目标跟踪方法(GTAT), 遵循全局跟踪范式, 整体架构如图1所示.
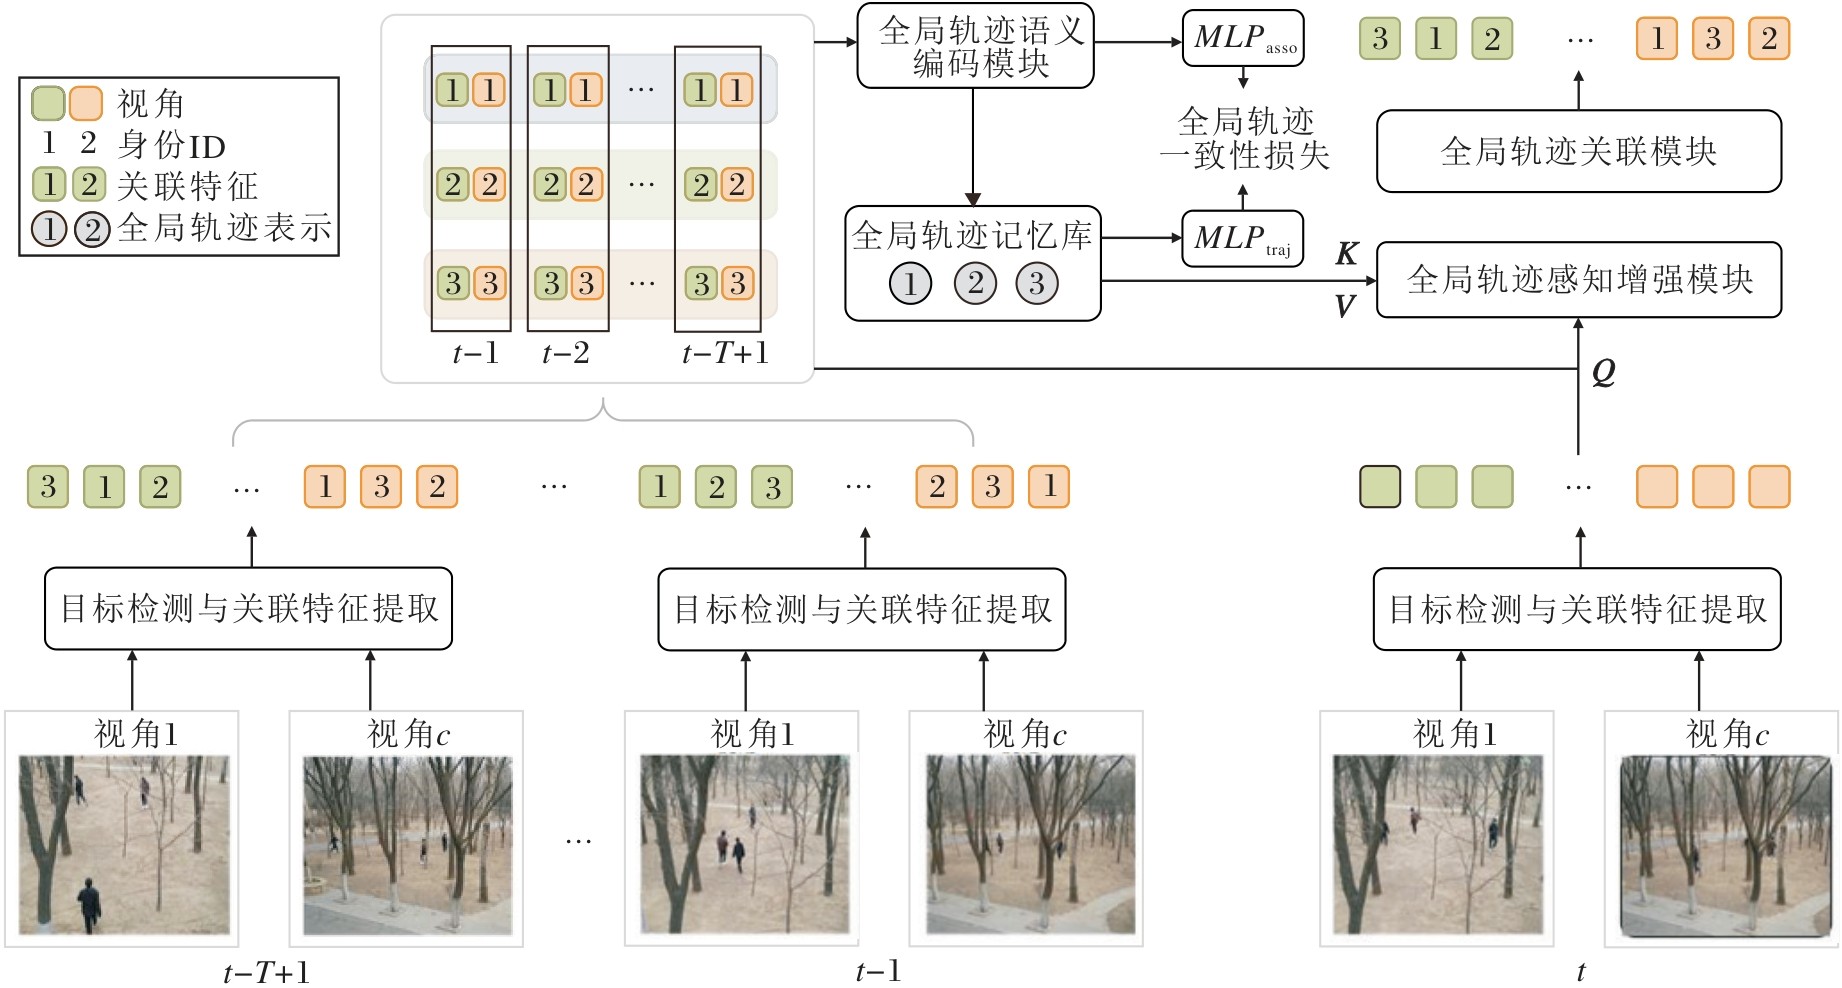 | 图1 GTAT整体架构Fig.1 Overall architecture of GTAT |
在环境中设置C个具有重叠视野的相机, 多相机多目标跟踪的任务是实时检测、跟踪所有相机拍摄的每个目标, 并为不同相机中的相同目标赋予统一的身份ID.在s时刻, 输入为所有相机采集的图像Ms={
$\boldsymbol{\tau}_{j}=\left\{\boldsymbol{F}_{s, j}^{\text {asso }, c} \mid s \in[t-T+1, t-1], c \in[1, C]\right\}, $
其中, t表示当前时刻, T表示时间窗口长度.
GTAT首先通过全局轨迹语义编码模块(GTSE)聚合全局轨迹中的长期身份信息, 构建全局轨迹记忆库, 再通过全局轨迹感知增强模块(GTAE)将轨迹级身份语义注入目标级关联特征, 得到全局轨迹感知的关联特征, 然后通过全局轨迹关联模块(GTA)计算当前帧所有目标与全局轨迹的匹配分数, 最终使用匈牙利算法为目标分配轨迹ID.
在推理初始化阶段, 首先, 选择目标数量最多的视角作为主视角, 并为该视角中的各目标分配唯一的初始ID.然后, 将其余视角中目标依次与主视角中的目标进行匹配.对于匹配成功的目标, 并入对应的全局轨迹, 并赋予与该轨迹一致的ID; 对于未能成功匹配的目标, 分配新的ID, 并建立相应的全局轨迹.由此完成全局轨迹的初始化.当历史时间窗口长度为T-1时, 采用滑动窗口方式进行后续推理.时间窗口每次整体向后滑动一个时间步, 并移除窗口中上一时刻的观测.
与GMT直接基于目标级关联特征进行全局匹配不同, GTAT通过全局轨迹感知模块(GTAM)将全局轨迹感知过程拆分为两步:全局轨迹级语义提取和目标级特征增强.首先, 对于每条历史轨迹, 利用GTSE, 聚合跨时间、跨视角的历史关联特征, 得到显式轨迹级表示, 用于描述该轨迹的长期身份语义.其次, 将所有轨迹级表示组织为全局轨迹记忆库.在此基础上, 通过GTAE, 利用交叉注意力机制, 按视角建模轨迹级表示与目标级关联特征之间的依赖关系, 并将轨迹级上下文信息注入时间-视角窗口内的目标级关联特征.即便推理阶段GTA依旧采用均值相似度策略, 计算当前目标与整条历史轨迹的匹配得分, 但经过增强后的目标特征已融入显式轨迹身份语义, 可有效区分外观相似目标, 维持跨时间跨视角的身份一致性, 输出更稳定可靠的全局关联结果.
1.2.1 全局轨迹语义编码模块
为了提取轨迹级别的全局表示, 设计GTSE, 引入可学习的全局轨迹令牌
为了适配Transformer编码器输入形式, 将轨迹τ j按照时间和视角组织的特征展平为一维序列, 定义如下:
$\left\{x_{\tilde{t}, j}\right\}_{\tilde{t}=1}^{T_{g}}=\operatorname{Flatten}\left(\boldsymbol{\tau}_{j}\right), $
其中,
Tg=(T-1)C,
表示全局时间总步数, Flatten(· )表示将轨迹τ j展平的函数,
s∈ [t-T+1, t-1], c∈ [1, C].
由此构造模块原始输入:
Z
将其送入Transformer编码器, 完成特征编码:
Z
其中n表示编码器层数.最终截取输出序列中全局轨迹令牌对应的首位特征作为第j条轨迹的全局轨迹特征:
其中D表示特征维度.
1.2.2 全局轨迹感知增强模块
然而, 当前时间窗口内的关联特征仍缺乏显式的全局轨迹级信息.为此, 设计GTAE, 利用全局轨迹记忆库, 对时间窗口[t-T+1, t]内的关联特征进行分视角增强.
对于第c个视角, 构建时间窗口内的关联特征集合:
$\boldsymbol{F}_{[t-T+1, t]}^{\text {asso }, c}=\bigcup_{s=t-T+1}^{t} \boldsymbol{F}_{s}^{\text {asso }, c}$,
其中
K=V=[
其中J表示历史窗口内轨迹的数量.在此基础上, 通过交叉注意力将历史轨迹级全局上下文分视角注入时间窗口的关联特征中, 得到第c个视角下的增强特征:
$\widehat{\boldsymbol{F}}_{[t-T+1, t]}^{\text {asso }, c}=\operatorname{Softmax}\left(\frac{\boldsymbol{Q}^{c} \boldsymbol{K}^{\mathrm{T}}}{\sqrt{D}}\right) \boldsymbol{V}, $
其中softmax(· )表示沿键向量维度对注意力得分矩阵进行逐行归一化.采用残差连接得到最终增强特征:
最终, 整个时间窗口内的全局轨迹感知关联特征为:
$\widetilde{\boldsymbol{F}}_{[t-T+1, t]}^{\text {asso }}=\bigcup_{c=1}^{C} \widetilde{\boldsymbol{F}}_{[t-T+1, t]}^{\text {asso }, c} .$
该模块利用提取的全局轨迹级表示, 对时间窗口内的关联特征进行全局轨迹感知增强, 从而引入目标的长期身份一致性特征, 有效解决原有关联特征全局信息不足的缺陷.
本文采用全局跟踪范式, 将多相机多目标跟踪建模为全局层面的轨迹-目标关联过程.首先将历史时间窗口内的轨迹感知关联特征
在推理阶段, 首先计算增强后的当前目标特征
在训练阶段, 编码器和解码器将时间窗口内轨迹感知增强的目标特征
$H_{a b}=\frac{\exp \left(E_{a b}\right)}{\exp \left(E_{a 0}\right)+\sum_{q=1}^{N} 1_{\left(t_{q}=t_{b} \text { and } c_{q}=c_{b}\right)}\left(\exp \left(E_{a q}\right)\right)} $.
其中:
对于真实标签矩阵X∈ RN× (L+1), 相应元素计算方式如下:
Xab=
其中, pa↔ pb表示Γ 中第b个目标与H中第a个标签匹配.最终的关联损失为:
$L_{\text {asso }}=-\frac{1}{N}\left(\sum_{a=1}^{N}\left(\sum_{b=1}^{L+1} X_{a b} \ln H_{a b}\right)\right) .$
现有关联损失本质上仅对目标级匹配关系施加约束, 缺乏轨迹层面的身份一致性监督.为此, 本文引入全局轨迹一致性损失(GTC), 以第1.2.1节中得到的全局轨迹表示和目标级关联特征的匹配关系为监督信号, 要求每条轨迹的全局表示在整个历史窗口内始终与其身份一致的关联特征保持稳定匹配关系.这样可在训练过程中同时从不同层面对关联特征进行优化与约束, 并保证历史窗口内全局轨迹级表示与关联特征之间的一致性, 从而增强全局轨迹级表示的身份一致性建模能力, 提升关联特征的判别能力.
本文仅考虑历史窗口[t-T+1, t-1].对于该窗口内的所有帧, 按照“ 时间优先、视角次优先” 的顺序, 将时间索引s与视角索引c联合展平为全局时间步
由此, 第j条轨迹在全局时间步
对于第i条轨迹的全局表示
$z_{i}^{\text {traj }}=M L P_{\text {traj }}\left(c_{i}^{g}\right)$
和第j条轨迹在全局时间步
$z_{j, i}^{\text {asso }}=M L P_{\text {asso }}\left(\dot{\boldsymbol{F}}_{j, i}^{\text {asso }}\right) .$
再通过点积计算两者之间的相似度:
若将(j,
为了构建GTC的监督信号, 定义有效候选掩码矩阵M和轨迹-目标对应矩阵G, 分别用于刻画候选轨迹的有效性及轨迹与目标之间的身份对应关系.首先, 掩码矩阵M用于表征历史窗口内哪些候选轨迹-时间对是有效的, 矩阵中元素
$M_{i, j, \tilde{t}}=\left\{\begin{array}{ll} 1, & \text { 轨迹 } i, j \text { 在全局时间步 } \tilde{t} \text { 中同时存在有效目标特征 } \\ 0, & \text { 其它 } \end{array}\right.$
其次, 轨迹-目标对应矩阵G用于表征正负样本, 矩阵中元素
$G_{i, j, \tilde{t}}=\left\{\begin{array}{ll} 1, & \text { 轨迹 } i 、 j \text { 在全局时间步 } \tilde{t} \text { 中同时存在有效目标特征, 且二者属于同一身份 } \\ 0, & \text { 其 } \end{array}\right.$
上述监督信号的作用可理解为:对于第i条全局轨迹, 其轨迹级表示应当与该轨迹在不同时间、不同视角下的目标级关联特征保持较高的相似度, 而与其它轨迹的关联特征保持较低的相似度.由于多相机多目标视频中目标并非在所有时间和所有视角下均可见, 若直接在所有轨迹-全局时间对上计算损失, 会引入无效监督.为此, 引入有效候选掩码矩阵M, 用于避免不可观测或不可匹配的候选项参与损失计算, 确保GTC仅在有效候选集合上进行优化.基于上述定义, 记正样本集合
P={(i, j,
其中每个三元组表示第i条全局轨迹与(j,
Ω i={(j,
在此基础上, 将GTC定义为一个带掩码约束的多分类交叉熵损失:
$L_{\mathrm{GTC}}=-\frac{1}{|P|} \sum_{(i, j, \tilde{t}) \in P} \ln \left(\frac{\exp \left(A_{i, j, \tilde{t}}\right)}{\sum_{\left(j^{\prime}, \tilde{t}^{\prime}\right) \in \Omega_{i}} \exp \left(A_{i, j^{\prime}, \tilde{t}^{\prime}}\right)}\right) .$
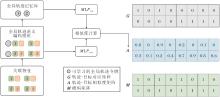
GTC中相关矩阵构建示例如图2所示.
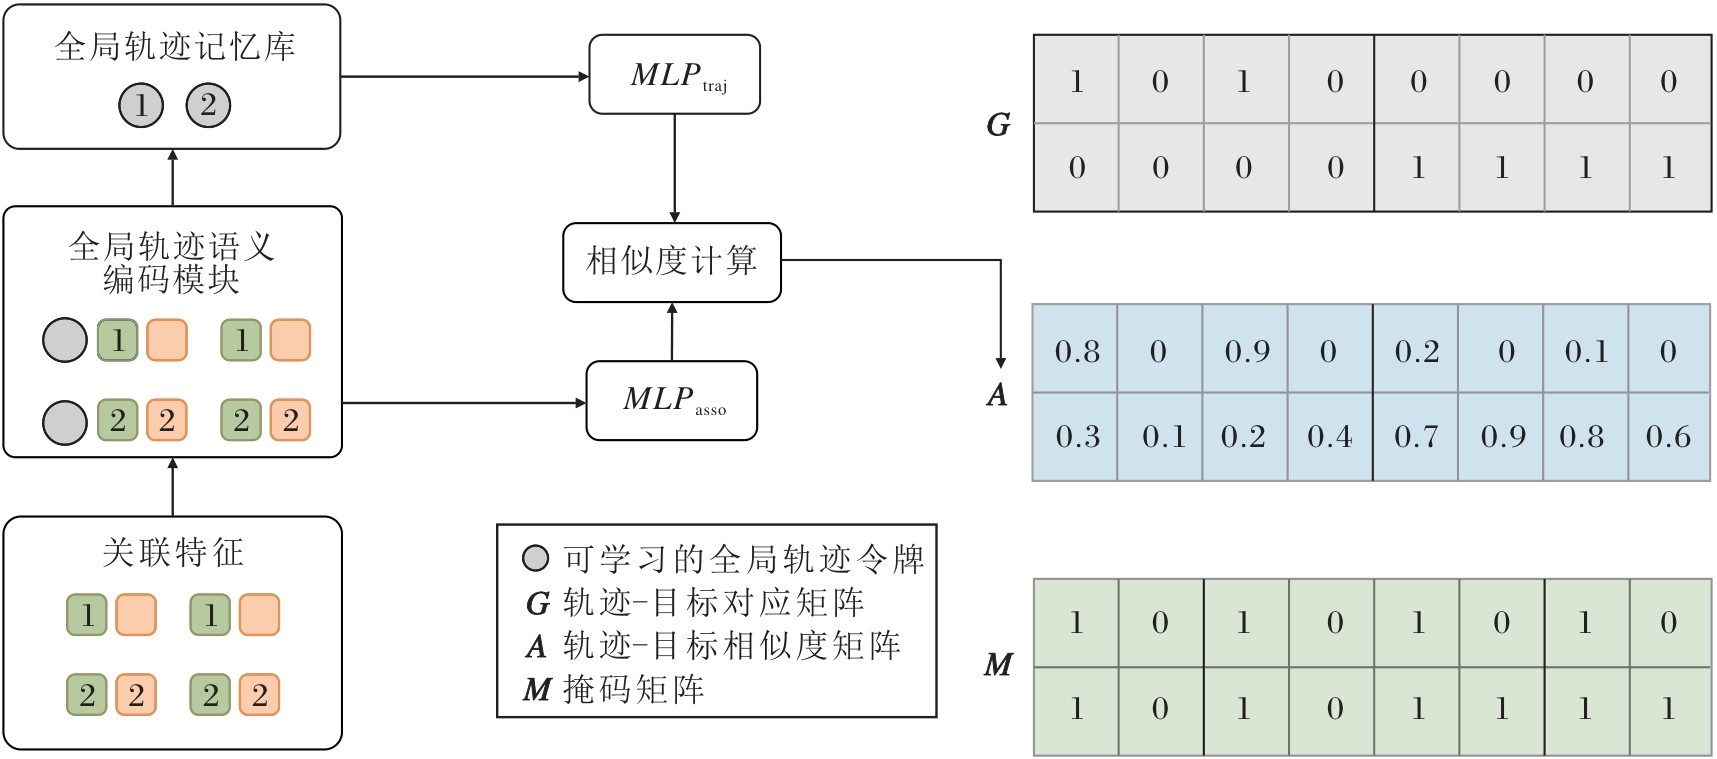 | 图2 GTC中相关矩阵的构建示例Fig.2 Example of constructing relevant matrices in GTC |
示例包含2条全局轨迹和4个全局时间步, 矩阵的行表示全局轨迹索引i, 列表示展平后的轨迹-全局时间步索引(j,
鉴于跟踪任务高度依赖于目标定位的准确性, 本文将训练过程划分为两个阶段.在第1阶段中, GTAT沿用GMT的检测器和关联特征提取模块进行训练:以DLA-34(Deep Layer Aggregation-34)[23]作为骨干网络, CenterNet[24]作为检测器.CenterNet以特征图为输入, 直接预测目标中心点的置信热力图, 并对目标尺寸和中心偏移进行回归.该设计能在保持结构简洁的同时实现较精确的目标定位, 为后续的目标特征提取与跟踪关联提供可靠的位置信息.目标检测分支的损失函数表示如下:
Ldet=Lheatmap+λ sizeLsize+λ offLoff,
其中, λ size=0.1, λ off=1.0, Lheatmap表示中心点热力图损失, Lsize表示目标尺度(长宽)回归损失, Loff表示中心点偏移回归损失.
为了学习具有身份判别性的外观特征, 采用交叉熵损失、三元组损失和中心损失进行联合监督.该分支损失函数如下所示:
LREID=LCE+LTriplet+LCenter,
其中, LCE表示交叉熵损失, LTriplet表示三元组损失, LCenter表示中心损失.训练时每个预测框会被分配给与其交并比(Intersection over Union, IoU)最大的真实框对应的身份标签, 以此为LREID提供可靠的监督信号.因此, 第1阶段的训练损失函数为:
Lstage1=Ldet+LREID.
第2阶段对完整模型进行训练, 损失函数为:
Lstage2=Ldet+λ 1Lasso+λ 2LGTC,
其中, λ 1=3.0, λ 2=1.0, Lasso表示时间窗口内所有目标匹配关系的交叉熵损失, LGTC表示本文的全局轨迹一致性损失.
本文采用DLA-34作为骨干网络, CenterNet作为目标检测器.在VisionTrack数据集[20]上, 先将输入图像等比例缩放至1 280× 720, 再采用取值范围为0.8~1.2的随机尺度因子对图像进行缩放增强, 然后输入骨干网络.在预训练阶段, 采用Adam(Adaptive Moment Estimation)优化器, 初始学习率设为1× 10⁻⁴.在CrowdHuman数据集[25]上对骨干网络与目标检测器进行联合预训练, 共迭代4.5× 10⁴次, 批次大小设为32.在正式训练阶段, 在两块NVIDIA RTX L40 48 G GPU上完成训练, 仍采用Adam优化器, 学习率设为5× 10⁻⁵, 时间窗口长度T设为9.其中, 第1阶段训练迭代1.05× 10⁴次, 第2阶段训练迭代1.4× 10⁴次.在推理阶段, 使用单张NVIDIA A6000 GPU进行评估, 时间窗口长度T设为60, 目标检测器的置信度阈值设为0.525, 与大多数现有工作保持一致.虽然训练和推理设置的时间窗口长度不一致, 但训练和推理都依据目标级关联特征之间的匹配关系, 因此并不存在训练和推理不一致的问题.
为了全面评估GTAT的性能, 在 MvMHAT[15]、DIVOTrack[18]、VisionTrack[20]、EPFL[26]、CAMPUS[27]、WILDTRACK[28]数据集上进行实验. MvMHAT数据集仅包含1个场景, 每段序列由3~4个不同视角组成.DIVOTrack数据集覆盖10个真实世界场景, 共包含20段视频序列, 涵盖室内与室外公共环境, 并由3台运动相机完成采集.VisionTrack数据集覆盖15个真实场景, 包含88段视频序列, 场景环境类型多样, 目标分布情况多样, 在数据规模与多样性方面均优于现有同类数据集.与采用固定地面相机采集的数据集不同, VisionTrack数据集上的数据由两架运动中的无人机完成拍摄, 从而引入更复杂的视角变化与动态成像条件[29].EPFL数据集包含5个场景, 每段序列由3~4个不同视角组成, 主要采集6~11名行人行走或奔跑的视频.各视角分辨率相对较低, 均为360× 288.CAMPUS数据集包含4个场景, 每个场景由4台1080P相机拍摄.WILDTRACK数据集仅包含1个场景, 具有7个视角, 场景中目标密度较高、遮挡与交互频繁, 因此更能体现模型的跨视角关联能力.
本文采用MOTA(Multiple Object Tracking Accuracy)[30]、HOTA(High Order Tracking Accuracy)[31]、AssA(Association Accuracy Score)[31]、ID
为了评估跨视角的跟踪性能, 使用CVIDF1(Cross-View IDF1 Metric)和CVMA(Cross-View Ma-tching Accuracy)[18]指标.CVIDF1指标是IDF1指标的跨视角版本, 主要用于衡量跨视角的ID一致性, 公式如下:
CVIDF1=
其中, CVIDP表示跨视角的ID精度, CVIDR表示跨视角的ID召回率.
CVMA指标是MOTA指标的跨视角版本, 公式如下:
$C V M A=1-\sum_{t}\left(m_{t}+f_{\mathrm{pt}}^{c}+2 m_{\mathrm{met}}\right)\left(\sum_{t} g_{t}\right)^{-1}, $
其中, mt表示在时间t时丢失的检测, gt表示在时间t时来自所有视角的真实目标, fpt表示假阳性匹配对的数量, mmet表示错误匹配对的数量.
实验选取如下对比方法:$MvMHAT _{\text {prev }}$[15]、$MvMHAT_{\text {Res }}$[16]、$MvMHAT_{Trans}$[16]、CrossMoT[18]、GMT[20]、AGW (Attention Generalized Mean Pooling with Wei- ghted Triplet Loss)[33]、CTL[34].AGW和CTL均为行人重识别方法, 二者作为外观特征提取网络接入DIVOTrack基准采用的统一跨视角关联流程, 完成多相机多目标跟踪.MvMHATprev表示MvMHAT的前期版本.MvMHATRes和MvMHATTrans分别表示Mv-MHAT的ResNet版本和Transformer版本.
为了保证公平性, GTAT的检测器设置与GMT相同, 各对比方法的实验结果采用文献[20]中公布的结果.
各方法在VisionTrack、DIVOTrack数据集上的指标值如表1所示.由表可见, 在VisionTrack 数据集上, 相比GMT, GTAT取得更优值, 表明其在跨视角匹配与身份一致性方面均取得提升, 其中IDF1、AssA、CVMA、CVIDF1指标分别提升1.7%、1.5%、1.3%和1.6%, 表明挖掘和利用目标的身份一致性信息能有效提升跨视角关联性能.不同于Vision-Track数据集上由多架无人机拍摄带来的显著动态视角变化, DIVOTrack数据集上的视角变化相对有限, 因此场景变化也相对较弱.实验表明, 相比GMT, GTAT取得更优性能, IDF1、AssA、CVMA、CVIDF1指标分别提升2.1%、2.5%、3.2% 和 2.9%.
 | 表1 各方法在VisionTrack、DIVOTrack数据集上的性能对比 Table 1 Performance comparison of different methods on VisionTrack and DIVOTrack datasets % |
各方法在WildTrack、MvMHAT数据集上的指标值如表2所示.由表可见, 在WildTrack数据集上, 相比GMT, 尽管GTAT的AssA指标略有下降, 但CVMA、CVIDF1、MOTA、HOTA、IDF1指标均取得明显提升, 说明GTAT能更有效地提升复杂多视角场景中的全局身份建模能力与跨视角匹配能力, 在整体跟踪性能上取得更优平衡.MvMHAT数据集上行人目标尺度较大、外观清晰、背景干扰较少、极端遮挡情况相对较少, 同时行人活动范围与相机运动模式较为规律, 目标通常不会频繁进出视野, 因此轨迹断裂与身份切换发生的概率较低, 整体跟踪难度相比其它密集复杂场景也相对较小.相比GMT, GTAT的IDF1、AssA、CVMA、CVIDF1指标分别提升2.1%、5.8%、2.3% 和 2.3%.
| 表2 各方法在WildTrack、MvMHAT数据集上的性能对比 Table 2 Performance comparison of different methods on WildTrack and MvMHAT datasets % |
各方法在CAMPUS、EPFL数据集上的指标值如表3所示.
| 表3 各方法在CAMPUS、EPFL数据集上的性能对比 Table 3 Performance comparison of different methods on CAMPUS and EPFL datasets % |
由表3可见, 在CAMPUS数据集上, 相比GMT, GTAT的CVMA、CVIDF1指标分别提升3.7%和3.2%.在EPFL数据集上, 相比GMT, GTAT在部分与检测相关的指标上略有下降, 但其跟踪性能更优, IDF1、CVIDF1指标分别提升2.1%和2.7%.尽管EPFL、CAMPUS数据集上场景类型相对单一、可跟踪目标数量有限, 但测试集通常由较长的连续视频序列构成, 更强调跟踪过程中的时序一致性、长时遮挡恢复能力和身份保持能力, 因此更能体现GTAT的长期关联建模能力.
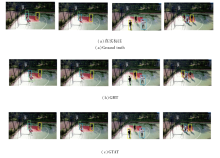
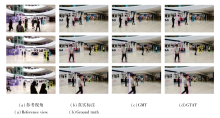
为了更直观地展示GTAT和GMT的性能差异, 选取2组GMT典型失效场景展开对比分析.Vision-Track数据集上00018court1场景涵盖篮球运动, 属于长时序视频, 具有目标运动剧烈、遮挡频繁等特点, 适用于评估方法的单视角跟踪性能.DIVOTrack数据集上SHOP场景为拥挤的室内商场环境, 跨视角外观差异显著, 且场景中目标尺度变化较大, 适用于评估跨视角匹配性能.GTAT和GMT的可视化结果如图3和图4所示.
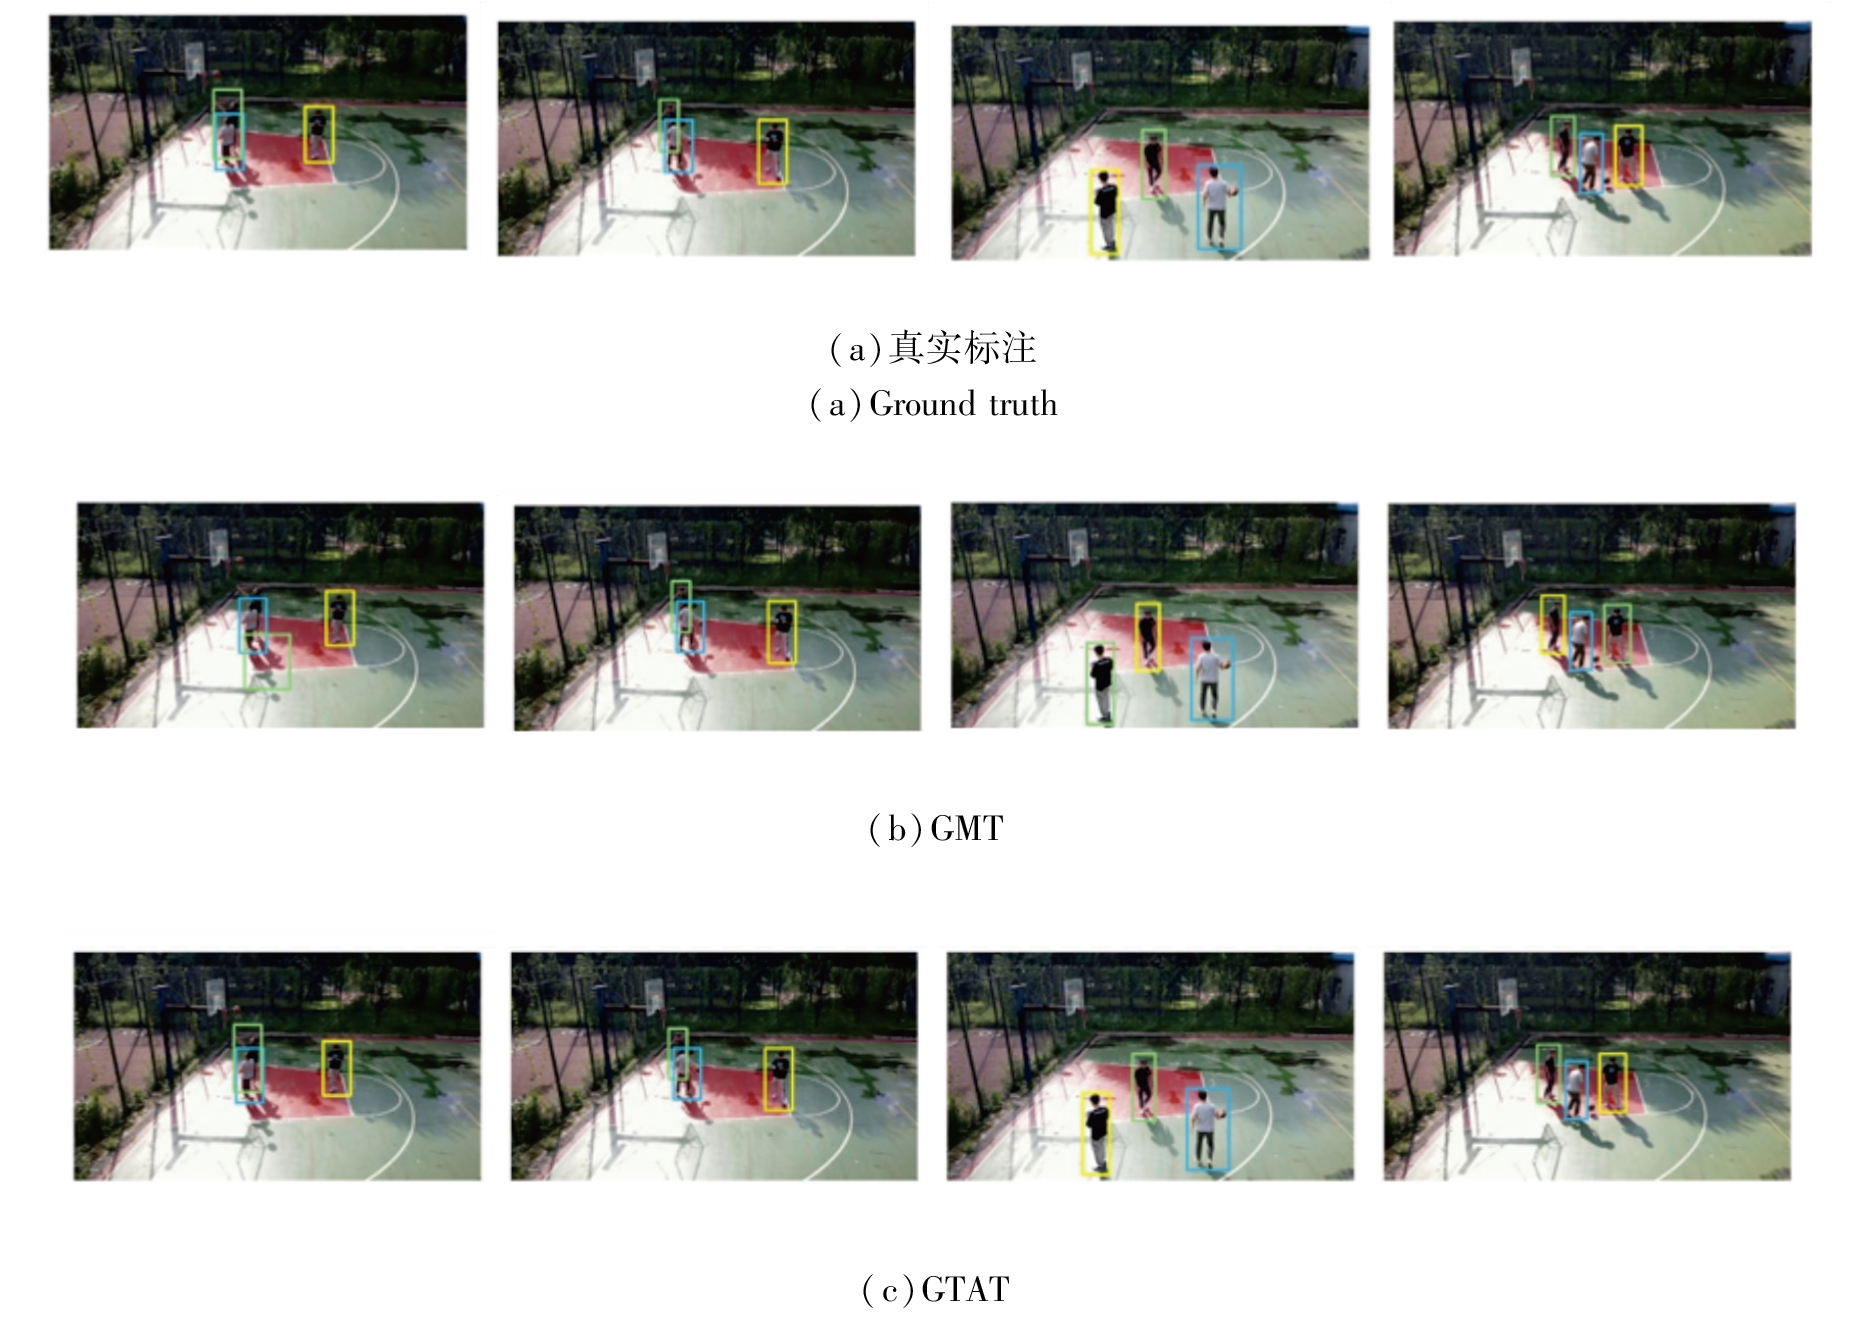 | 图3 各方法在VisionTrack数据集0018court1场景中的可视化结果Fig.3 Visualization results of different methods in 0018court1 scene of VisionTrack dataset |
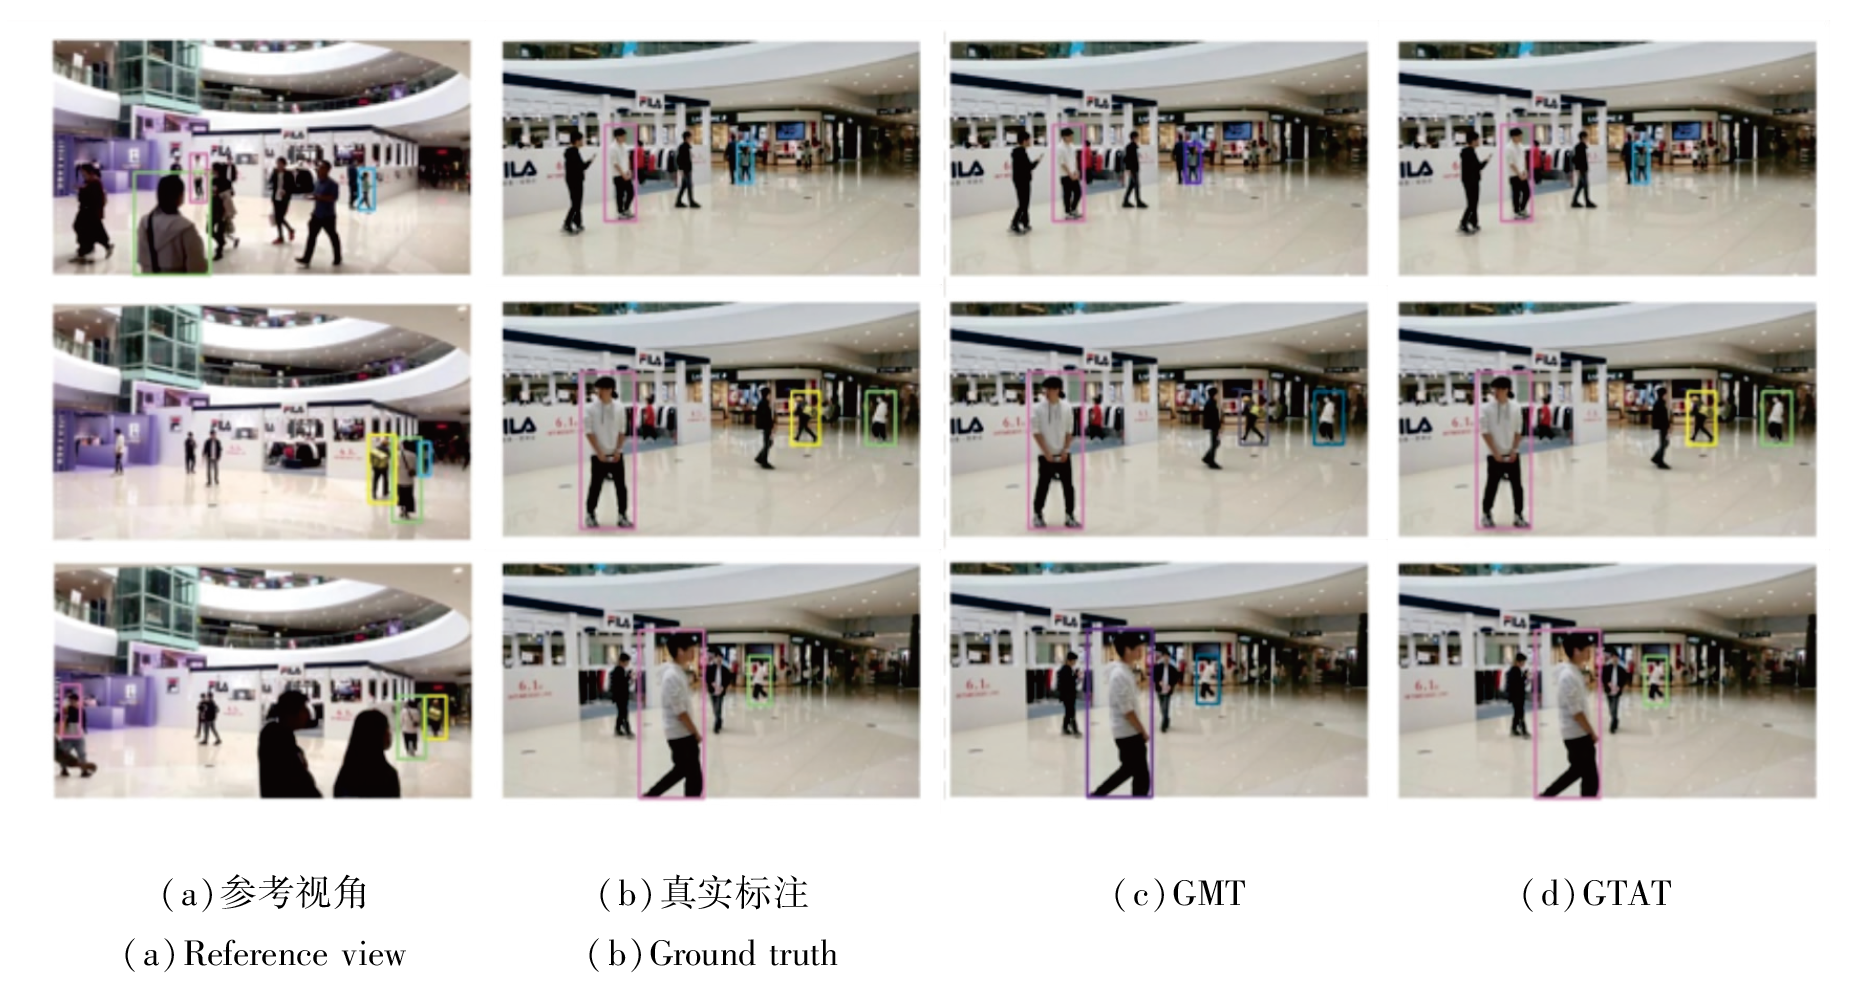 | 图4 各方法在DIVOTrack数据集SHOP场景中可视化结果Fig.4 Visualization results of different methods in SHOP scene of DIVOTrack dataset |
由图3可见, 在00018court1场景中, 相似目标干扰和遮挡同时存在时, GMT出现ID交换, 并将影子产生的误检错误关联至已有轨迹, 而GTAT能降低该误检对轨迹身份关联的干扰, 并保持较稳定的目标关联.
由图4可见, 在SHOP场景中, GMT的跨视角关联结果不够稳定, 而GTAT能更有效地应对外观差异与尺度变化带来的挑战, 实现更准确的跨视角匹配, 整体效果优于GMT.
为了明确多相机在线场景中的统计口径, 在VisionTrack推理配置下对比GMT和GTAT的参数量、浮点运算量和推理速度.输入图像缩放至1 280× 720, 设置摄像头数C=2, 时间窗口T=60, 全局时间总步数Tg=118, 特征维度D=1 152.考虑到在线关联开销随目标和轨迹规模动态变化, 覆盖Vision-Track数据集上全部22个测试序列, 并从每个序列的早期、中段和末段分别采样一个包含80帧的片段.去除窗口预热后, 每个片段保留21个稳定样本, 即每个序列保留63个样本, 共获得1 386个样本.再对各序列的统计结果进行帧数加权.最终得到完整时间窗口内的目标特征数U=1 213.6, 历史窗口内轨迹数量J=18.1.
在上述统计条件下, 全局轨迹语义编码模块(GTSE)对J条历史轨迹分别进行自注意力编码, 复杂度为O(J(TgD2+T
按照与GMT相同的有效推理模块统计口径, GTSE、GTAE参数量为18.6 M, 加上GMT原先46.0 M的参数量, 最后GTAT的总参数量为64.6 M.在VisionTrack的统计条件下, GTSE、GTAE分别产生17.8 G和9.9 G的浮点运算量, 相比GMT的227.6 G, GTAT增加27.7 G的浮点运算量, 总浮点运算量为255.3 G.推理速度由GMT的14.6帧/秒降至12.0帧/秒.
WildTrack数据集上目标分布密集、视角数量多、遮挡频繁、场景难度高.为了直观验证GTAT中各模块的实际作用, 在该数据集上开展消融实验.基线方法为GMT, 再分别引入全局轨迹感知模块(GTAM)和全局轨迹一致性损失(GTC), 移除掩码约束.相应消融实验结果如表4所示.
| 表4 各模块在WildTrack数据集上的消融实验结果 Table 4 Ablation experiment results of different modules on WildTrack dataset % |
由表4可见, 仅引入GTAM后, 跨视角跟踪性能得到明显提升, CVMA指标提升5.1%, CVIDF1指标提升2.4%, 充分表明将全局轨迹级信息注入关联特征的有效性.在此基础上引入GTC, 单视角与跨视角关联性能均获得进一步提升, IDF1指标提升0.9%, CVIDF1指标提升0.7%, 验证通过额外约束轨迹级表征与目标级关联特征的匹配关系, 能有效实现全局轨迹信息的跨时间、跨视角监督, 学习判别性更强的关联特征.移除掩码约束后, 单视角与跨视角跟踪性能均出现明显下降, 表明掩码机制能筛选有效样本、过滤无效监督噪声, 保证仅基于可观测、可匹配的样本开展学习, 是提升跟踪稳定性的关键约束之一.
为了验证GTC有助于学习更具有判别性的关联特征, 单独将GTC加入GMT, 在WildTrack数据集上的消融实验结果如表5所示.由表可见, GTC通过显式监督轨迹级表示与目标级关联特征的匹配关系, 直接强化关联特征与对应轨迹的对齐度, 提升目标特征在跨视角、跨时间匹配任务中的判别能力, 减少身份混淆.
| 表5 GTC对GTAT性能的影响 Table 5 Effect of GTC on GTAT performance % |
为了验证GTAE中分视角交叉注意力增强设计的有效性, 在DIVOTrack数据集上, 将其与未分视角的交叉注意力增强方案开展对比实验, 结果如表6所示.
| 表6 分视角交叉注意力增强对GTAT性能的影响 Table 6 Effect of view-specific cross-attention enhancement on GTAT performance % |
由表6可见, 采用分视角交叉注意力增强后, 各项指标均获得一定提升, 表明视角信息的解耦利用较重要:未分视角的交叉注意力会将不同视角的特征直接混合, 容易引入视角间噪声与干扰; 分视角设计能保留各视角的上下文信息, 使目标特征更精准地感知轨迹级身份语义, 强化跨视角关联能力.
为了验证GTSE使用可学习的全局轨迹令牌对全局轨迹语义编码的有效性, 在DIVOTrack数据集上对比轨迹平均池化与注意力池化, 结果如表7所示.由表可见, 相比静态单层注意力池化和无差别平均池化, 动态参与序列交互的全局轨迹令牌能建模更精准的全局轨迹表征.
| 表7 全局轨迹聚合策略对GTAT性能的影响 Table 7 Effect of global trajectory aggregation strategies on GTAT performance % |
为了验证推理时间窗口长度对GTAT的影响, 在VisionTrack数据集上进行实验, 设定时间窗口长度为50、60、70, 相应结果如表8所示.由表可见, 随着时间窗口长度由50增至60, 各项性能均有所提升, 说明适当增加时间窗口长度能提供更充分的历史观测, 改善跟踪性能.当时间窗口长度进一步增至70时, CVIDF1指标保持不变, 其余指标均出现小幅下降.这可能是因为更长的时间窗口引入更多的冗余历史观测和更大的外观变化, 同时增加计算开销.综合关联性能与计算效率, 本文最终将推理时间窗口长度设为60.
| 表8 时间窗口长度对GTAT性能的影响 Table 8 Effect of window length on GTAT performance % |
现有全局跟踪方法GMT仅对历史时间窗口内的关联特征进行自注意力编码, 同时将全局轨迹简单当作历史目标特征集合, 缺乏对轨迹级身份语义的显式建模与一致性约束.针对该问题, 本文提出基于全局轨迹感知的多相机多目标跟踪方法(GTAT).首先, 设计全局轨迹感知模块(GTAM), 先依托全局轨迹语义编码模块(GTSE), 聚合每条全局轨迹对应的轨迹级表示, 再设计全局轨迹感知增强模块(GTAE), 按视角对时间窗内的目标级关联特征完成交叉注意力增强.然后, 将融入全局轨迹语义的关联特征输入全局轨迹关联模块(GTA), 实现具备全局轨迹感知能力的多相机多目标跟踪.最后, 构建全局轨迹一致性损失(GTC), 聚焦轨迹与目标之间的匹配关系, 对全局轨迹表示进行显式约束, 有效提升全局轨迹表示的身份一致性建模能力与关联特征的判别能力.在6个公开多相机多目标跟踪数据集上的实验表明, GTAT在引入一定参数与计算开销的情况下, 各项指标取得一定提升.
虽然GTAT有效挖掘全局轨迹语义, 但多相机多目标跟踪场景中的轨迹级信息仍有待进一步挖掘.本文研究以全局轨迹级语义建模为核心, 尚未充分挖掘不同视角独有的轨迹语义特征.事实上, 不同视角下的目标轨迹在可视范围、运动规律、外观形态及遮挡状态等方面往往存在一定差异, 这类视角专属轨迹信息可进一步为跨视角目标关联提供有效约束.因此, 构建全局轨迹语义与视角专属轨迹语义的高效协同建模机制, 使模型在保障跨视角身份一致性的前提下, 自适应利用不同视角的数据特性, 是未来值得关注的重要研究方向.
本文责任编委 高隽
Recommended by Associate Editor GAO Jun
| [1] |
|
| [2] |
|
| [3] |
|
| [4] |
|
| [5] |
|
| [6] |
|
| [7] |
|
| [8] |
|
| [9] |
|
| [10] |
|
| [11] |
|
| [12] |
|
| [13] |
|
| [14] |
|
| [15] |
|
| [16] |
|
| [17] |
|
| [18] |
|
| [19] |
|
| [20] |
|
| [21] |
|
| [22] |
|
| [23] |
|
| [24] |
|
| [25] |
|
| [26] |
|
| [27] |
|
| [28] |
|
| [29] |
|
| [30] |
|
| [31] |
|
| [32] |
|
| [33] |
|
| [34] |
|