

面向数字取证的可溯源生成方法
[林国凯1  , 孙媛媛
1 , 郭弘2 , 帕尔哈提·吐拉江1 , 杨亮1 , 林鸿飞1 ]
, 孙媛媛, 郭弘, 帕尔哈提·吐拉江, 杨亮, 林鸿飞]
|
|


作者简介:
林国凯, 博士研究生,主要研究方向为数字取证、信息检索、数据挖掘、自然语言处理.E-mail:13906017038@mail.dlut.edu.cn.
郭 弘, 硕士,高级工程师,主要研究方向为声像资料鉴定、电子数据鉴定、知识产权鉴定.E-mail:guoh@ssfjd.cn.
帕尔哈提·吐拉江, 博士研究生,主要研究方向为信息检索、自然语言处理.E-mail:prht@mail.dlut.edu.cn.
杨 亮, 博士,副教授,主要研究方向为自然语言处理、情感分析、大语言模型.E-mail:liang@dlut.edu.cn.
林鸿飞, 博士,教授,主要研究方向为自然语言处理、情感计算、社会计算.E-mail:hflin@dlut.edu.cn.
针对多源异构电子证据场景中证据边界易被破坏、来源与定位信息难以保留、生成结果缺乏可核验支撑等问题,文中提出面向数字取证的可溯源生成方法(Traceable Evidence-Centric Generation, TEC-Gen).首先,统一解析聊天记录、文件记录、通话记录和系统日志等多源取证数据,并以原始记录为基本单元构建证据元组.在每个证据元组中,联合建模原始记录文本与来源文件、定位信息、时间戳及关键实体等元数据,保留原始证据边界及其定位锚点.然后,围绕案件分析查询组织候选证据,并在检索相关记录的同时保留来源文件、定位信息和关键实体等结构属性,为后续生成与核验提供统一证据基础.在生成阶段,候选证据与引用规则被共同注入提示模板,并要求大语言模型在关键事实类陈述后附加来源标记.最后,在生成阶段,输出引用被解析并与候选证据中的有效原始位置进行匹配,建立生成陈述与原始证据之间的显式回链关系.实验表明,TEC-Gen在不同大语言模型基座上均优于闭卷生成方法和通用检索增强生成方法,并在文本对齐、关键事实覆盖和结果可溯源性方面优势稳定,可为数字取证场景中的案情摘要生成、证据定位和辅助研判提供方法支撑.
About Author:
LIN Guokai, Ph.D. candidate. His research interests include digital forensics, information retrieval, data mining and natural language processing.
GUO Hong, Master, senior engineer. Her research interests include forensic examination of audio-visual materials, digital evidence forensics, and intellectual property identification.
Paerhati TULAJIANG, Ph.D. candidate. His research interests include information retrieval and natural language processing.
YANG Liang, Ph.D., associate professor. His research interests include natural language processing, sentiment analysis and large language models.
LIN Hongfei, Ph.D., professor. His research interests include natural language processing, affective computing and social computing.
To address the problems of vulnerable evidence boundaries, difficulty in preserving source and location information, and insufficient verifiable support for generated results in multi-source heterogeneous electronic evidence scenarios, a traceable evidence-centric generation method for digital forensics(TEC-Gen) is proposed. First, multi-source forensic data, including chat records, file records, call records and system logs, is parsed in a unified manner. Original records are regarded as the basic units to construct evidence tuples. Within each evidence tuple, the original record text and metadata, including source files, location information, timestamps and key entities, are jointly modeled to preserve the original evidence boundary and its location anchor. Then, candidate evidence is organized according to a case analysis query. Relevant records are retrieved while structural attributes, including source files, location information and key entities, are preserved, providing a unified evidence basis for subsequent generation and verification. In the generation stage, the candidate evidence and citation rules are jointly incorporated into the prompt template, and a large language model is required to attach source markers after key factual statements. Finally, the output citations are parsed and matched with valid original positions in the candidate evidence. Explicit back-links between generated statements and original evidence are established. Experimental results show that TEC-Gen outperforms closed-book generation method and standard retrieval-augmented generation method on different large language model backbones. Stable advantages are observed in text alignment, key fact coverage, and result traceability. Methodological support is provided for case summary generation, evidence localization, and assisted analysis in digital forensics.
近年来, 随着数智经济的快速发展与网络犯罪的常态化, 电子数据已成为当前司法实践中占比最高的证据类型, 在大数据时代, 电子证据已成为新一代证据之王[1].
相比传统证据, 数字取证数据具有来源复杂、结构异构、规模庞大和时序分散等特点, 它们既包括短信、通话记录和即时通信内容, 也包括应用日志、交易流水及附件文件等多种类型[2].在实际办案中, 单个案件往往涉及多终端、多平台和多时段数据, 关键行为线索与资金往来链条分散于不同文件和记录片段之中, 如果仅依赖人工逐条筛查与交叉比对, 那么不仅成本较高、效率较低, 而且容易造成关键证据遗漏和结论复核困难[3].
现阶段大语言模型(Large Language Model, LLM)在文本理解、信息整合和自然语言生成方面表现出强大能力, 为数字取证智能分析提供新的技术条件[4].检索增强生成(Retrieval-Augmented Genera-tion, RAG)通过引入外部证据, 在一定程度上缓解闭卷生成中的事实缺失与内容幻觉问题, 已在知识问答和专业文档分析等任务中取得较优效果.然而, 通用RAG直接应用于数字取证场景时仍存在明显不足:一方面, 取证记录高度依赖原始结构及元数据信息, 通用文本切块方式容易破坏证据边界, 削弱来源文件、定位信息和时间属性在后续分析中的作用; 另一方面, 司法应用不仅要求生成结果内容合理, 还要求关键结论能回溯至原始证据位置, 满足核验、复查和质证等实际需求[5, 6].通用RAG缺乏针对证据边界、定位属性及结果回链机制的专门设计, 因此难以满足数字取证场景对可核验性与可追溯性的要求.
现有数字取证智能分析方法在复杂案件场景中仍存在三方面不足.
1)已有研究分别从取证流程追踪、本体建模和大模型辅助分析等角度推进取证自动化[2, 7], 但主要面向流程记录、知识组织或特定分析环节, 对跨平台、跨终端、跨时段证据的统一表示与案情归纳支持有限.
2)通用RAG通常以文档切分、相关内容检索和上下文拼接为基本流程[8, 9], 当该范式直接用于数字取证时, 可能弱化原始记录边界及其来源、定位和时间等元数据, 难以稳定支撑生成结果的证据回链.
3)司法鉴定相关研究强调大模型应用中的可信约束与人工复核[10, 11], 数字取证实验也表明, 大模型辅助分析和报告的生成仍可能产生事实偏差[12, 13].
因此, 司法分析不仅要求生成内容具有相关性, 还要求关键陈述能回溯至可审查的原始证据位置.如何面向多源异构数字证据构建兼顾结构保留、候选组织与结果回链的统一生成框架, 成为数字取证智能分析中的关键问题之一.
针对现有数字取证智能分析方法在多源异构证据组织与结果核验方面的不足, 本文提出面向数字取证的可溯源生成方法(Traceable Evidence-Centric Generation, TEC-Gen).不同于面向开放域问答的通用RAG范式, TEC-Gen围绕数字取证场景中的证据边界保留、来源定位锚定与关键结论可核验三个核心需求展开设计.首先, 对多源异构取证记录进行统一解析, 构建融合文本内容与来源元数据的证据元组表示.然后, 围绕案件分析查询组织保留定位信息的候选证据.最后, 在生成阶段引入引用约束与溯源校验机制, 使生成文本中的关键陈述能与原始文件及行号级证据建立显式对应关系.
数字取证自动化长期围绕证据提取、事件重建、时间线分析和关系建模等任务展开.早期方法主要依赖规则匹配、事件关联和本体建模等技术, 对日志、通信记录及文件系统痕迹进行结构化整理, 以此支持案件行为还原和时序分析[7].这类方法在特定数据类型和特定分析环节中具有一定效果, 但通常依赖明确规则与领域先验, 难以适应来源分散、结构异构且规模庞大的真实数字取证场景.随着案件数据类型的不断扩展, 单一规则或单一数据类型驱动的方法在跨来源证据整合和复杂案情归纳方面逐渐显现出局限性.
随着人工智能技术被引入数字取证分析流程, 相关研究开始从传统的规则匹配和结构化整理, 进一步扩展至实体抽取、时间线整理、关系发现和辅助分析等任务[14].王素等[10]分析生成式AI赋能电子数据鉴定的范式变革, 指出可信约束是相关技术落地应用的关键.李冰等[11]对“ AI+司法鉴定” 模式进行系统性讨论, 认为新一代人工智能技术能在证据处理和鉴定辅助中提升工作效率.
总之, 现有数字取证自动化研究主要关注证据提取、局部结构化处理和特定分析任务的效率提升, 对跨来源、跨平台、跨时段证据的统一组织仍然支持不足.尤其是在司法分析场景中, 系统输出不仅需要形成可读的案情描述, 还需要保留原始证据边界、来源文件和定位信息, 以便支持后续核验、复查与质证.现有方法在证据组织与结果回链之间尚未形成统一机制.
检索增强生成(RAG)技术引入外部证据约束模型输出, 可有效降低幻觉问题, 现已成为当前该领域最通用的技术路径之一[8].现有研究通常将RAG视为“ 检索-生成” 耦合范式, 并围绕检索源优化、索引优化和查询优化等方向展开.王鑫林等[9]指出, RAG的有效性不仅取决于是否引入检索, 还取决于检索对象的组织方式、上下文的构造方式以及生成阶段对外部证据的利用方式.
在具体实现上, 已有研究从文本切分、滑动窗口、查询重写和多查询机制等方面改进通用RAG框架, 提升长文档场景中的信息保留能力和检索相关性[15].这类方法通常将外部文档处理为文本片段, 并通过上下文拼接的方式为生成模型提供补充信息, 对于一般文档问答和知识密集型任务具有较优效果.
然而, 数字取证场景中的证据并不是普通文本片段, 而是带有来源文件、定位信息、时间戳和关键实体等属性的原始记录单元.通用RAG方法侧重于提升检索命中率和上下文利用率, 容易忽略证据边界和元数据在司法核验中的作用.若直接采用文本切块和上下文拼接方式, 可能导致来源定位信息被弱化, 进而影响生成结果的可复查性.罗文培等[16]从大模型增强检索的角度探索跨模态图文检索方法, 进一步拓展RAG技术在多模态场景中的应用边界.
围绕LLM的可信生成问题, 近年来研究重点逐步从“ 提升答案正确性” 扩展至“ 增强答案可验证性” .Manakul等[17]提出SelfCheckGPT, 多次采样一致性检测幻觉, 为黑箱模型的零资源事实校验提供通用手段.Gao等[18]进一步提出RARR(Retrofit Attri- bution Using Research and Revision), 实现错误事实的可解释修订.
上述研究表明, 为模型输出提供引用、证据片段或外部来源, 有助于提升生成结果的可验证性.但是, 在高风险应用场景中, 仅给出引用并不等同于实现可靠归因.若引用与陈述之间缺乏稳定对应, 或者引用只能指向宽泛文档而不能定位到具体证据位置, 生成结果仍难以满足核验和责任追踪要求[12].
这一问题在数字取证与司法分析场景中尤为突出.Scanlon等[13]评估ChatGPT在数字取证中的应用潜力, 指出生成内容的严谨性难以直接满足司法采信要求.Michelet等[19]通过实验验证, 大模型辅助取证报告撰写仍可能产生事实偏差.Villegas-Ch等[20]进一步使用统计分析法进行实证研究, 显示仅不到15% 的现有AI技术满足Daubert标准.对于此类任务, 系统输出不仅需要语义相关和表达通顺, 更需要将关键陈述明确关联到可审查的原始证据位置.林哲旭等[21]构建基于Hyperledger Fabric的数据可信共享平台, 从数据来源可信与过程可追溯层面提供底层技术支撑.
因此, 现有可信生成和带引用生成研究虽然为降低幻觉和提升可验证性提供重要保障, 但面向数字取证场景时仍存在如下不足:1)缺少对多源异构证据边界和定位属性的专门建模; 2)候选证据组织与生成引用之间缺乏统一结构; 3)生成结果与原始证据位置之间的回链关系仍不够明确.
面向数字取证场景中的案情分析任务, 本文提出可溯源生成方法(TEC-Gen).给定案件查询q和原始证据集合E作为输入, 系统输出带有来源标记的案情分析文本.
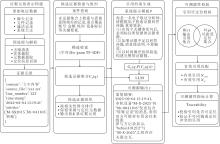
TEC-Gen整体流程包括证据元组表示构建、候选证据检索与组织、引用约束生成和可溯源性校验4个阶段.TEC-Gen整体框架如图1所示.
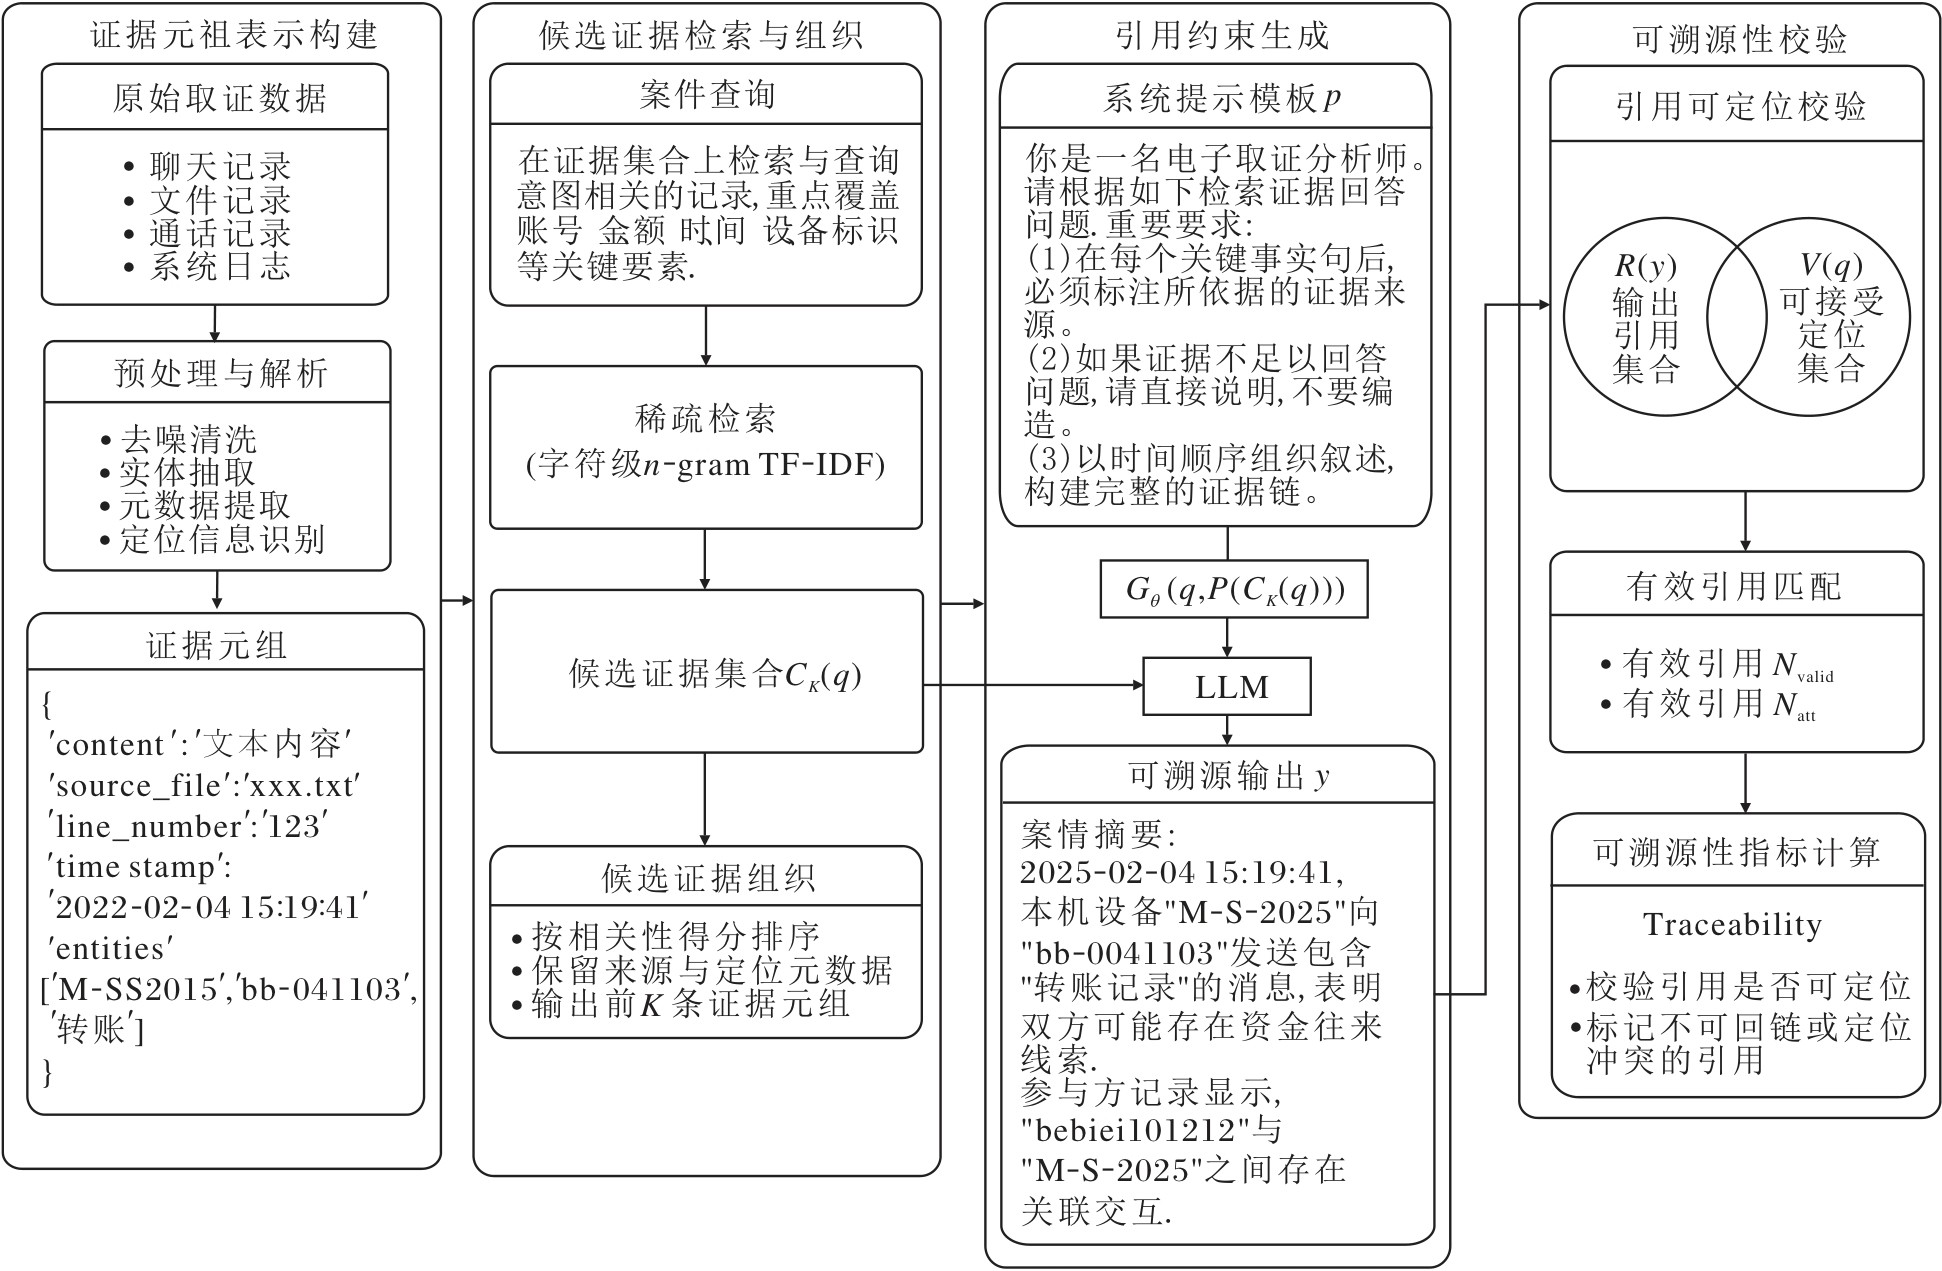 | 图1 TEC-Gen整体框架Fig.1 Overall architecture of TEC-Gen |
证据元组表示构建阶段首先对多源异构取证记录进行预处理与解析, 并构造统一的证据元组表示, 以此保留原始记录的文本内容、来源文件、定位信息及关键实体等属性.
候选证据检索与组织阶段围绕案件分析查询, 从证据元组集合中组织与问题相关的候选证据, 并保留来源与定位元数据.
引用约束生成阶段将候选证据与引用规则共同注入提示模板, 驱动LLM生成带有来源标记的案情分析结果.
可溯源性校验阶段对输出引用进行解析与匹配, 检查其能否定位到候选证据中的有效原始位置.需要说明的是, 该校验解决的是引用定位与证据回链问题, 不判断被引内容是否在语义上充分支持相应陈述, 也不等同于对陈述事实正确性的自动验证.陈述的证据支持程度仍需结合被引原文、上下文及相关证据链进行实质审查.
TEC-Gen的目标并不只是提升生成结果与查询的相关性, 而是在案情分析结果的可读性与可核验性之间建立统一约束.通过上述过程, 系统输出不仅能组织案件中的实体、事件及其关系, 还能为关键陈述提供可回链的证据位置, 从而支持鉴定人员开展后续复查与实质核验.
设原始数字取证证据集合E={ei
y={(uj, rj)
其中, M表示生成结果中需要进行溯源校验的关键陈述总数, uj表示第j条关键陈述, rj表示与该陈述对应的来源引用信息, 本文采用统一的引用形式
rj=(source_ file, line_number), (1)
source_ file表示源文件, line_number表示定位行号.
数字取证数据具有来源复杂、结构异构和粒度不同等特点, 若直接将原始记录作为非结构化文本输入后续模块, 容易破坏证据边界, 使来源文件和定位信息难以在生成阶段与校验阶段继续使用.为此, 本文将每条原始记录表示为证据元组.对于任意原始取证记录ei, 构造其对应的证据元组:
ti=(xi, mi),
其中, xi表示该条记录的可读文本内容, mi表示与该记录绑定的元数据.
进一步地, 本文将元数据表示为
mi=(doci, loci, zi).
其中:doci表示来源文件; loci表示定位信息; zi表示可选辅助属性, 如, timei表示标准化时间戳, enti记录包含的关键实体集合, 包括账号、手机号、金额、时间及设备标识等案件分析中高频出现的实体要素.
证据元组表示的作用在于保留原始证据单元的边界及其定位锚点, 使候选证据检索与组织阶段、引用约束生成阶段和可溯源性校验阶段共享同一证据基础.相比通用文本切块方式, 这种表示更符合数字取证场景对来源可追溯和结果可核验的要求.
在证据元组集合T={ti
综上所述, 本文采用基于稀疏检索的候选证据组织策略.对于任一证据元组ti, 其与查询q之间的匹配分数定义如下:
si=cos(v(q), v(xi)),
其中v(· )表示基于n-gram TF-IDF的文本向量化函数.
系统依据si对证据元组进行排序, 并选取前K条证据构成候选证据集合:
CK(q)=
在实践中, 低相关记录不进入候选集合, 目的是抑制弱相关噪声; 候选结果同时保留来源文件和定位信息, 为后续引用生成与溯源校验提供统一证据锚点.本文采用字符n-gram TF-IDF, 主要考虑账号、手机号、金额和时间戳等精确事实锚点的匹配需求, 以及检索结果的可核查性、可复现性和部署成本.该配置是本文主实验中的受控实现, TEC-Gen本身不依赖特定检索器, 稠密检索或混合检索均可替换该模块, 该设计能增强对表述变体和隐含语义关联的召回能力.
给定候选证据集合CK(q)后, 系统将候选证据摘要与引用规则共同注入提示模板, 驱动LLM生成案情分析结果.与仅将检索文本直接拼接为上下文的通用RAG不同, TEC-Gen将引用要求显式纳入生成目标中, 即关键事实类陈述需附带来源标记.生成阶段采用式(1)所示的统一引用格式.据此, 系统输出表示如下:
y=Gθ (P(q, CK(q), Icite)),
其中, P(· )表示提示构造器, q表示案件分析查询, CK(q)表示候选证据集合, Icite表示引用约束规则, Gθ (· )表示生成模型.该过程将案件查询、候选证据及引用约束共同组织为提示输入, 生成带有来源标记的案情分析结果.当前采用提示约束和后置评估的方式, 即模型在统一提示条件下完成生成, 若输出中存在引用缺失或格式不合规时, 则在后续评测中作为错误样本统计.
仅有引用并不足以保证结果可核验, 因此本文在生成后对输出中的引用进行可溯源性校验.由于候选证据集合CK(q)中每个证据元组ti的元数据
mi=(doci, loci, zi),
因此候选证据中的可接受定位集合定义为
VK(q)={(doci, loci)|ti=(xi, mi),
mi=(doci, loci, zi), ti∈ CK(q)}.
如前所述, 生成结果中需要进行溯源校验的关键陈述数为M, 第j条关键陈述对应的引用为rj.当该陈述引用缺失或引用格式不合规时, rj=Ø .定义能被解析并定位到候选证据有效位置的引用数:
Nvalid=
其中, 1[· ]表示指示函数, 当括号内条件成立时取1, 否则取0.由此得到可溯源性指标:
Traceability=
其中Nall=M表示生成结果中需要进行溯源校验的关键陈述总数.若某条关键陈述未附引用, 或其引用格式无法解析、来源文件不存在、定位信息与候选证据不一致, 则该陈述计入Nall, 但不计入Nvalid.对于不输出显式来源引用的方法, 不计算该指标, 记为N/A.
Traceability指标刻画关键陈述所附引用的定位有效比例, 即引用能否为后续复查提供可访问的原始证据位置.该指标既不评价被引内容与相应陈述之间的语义蕴含程度, 也不判断证据是否充分、陈述是否真实.即使某条引用能准确定位, 仍可能存在断章取义、上下文缺失或基于弱相关证据做出过度推断等问题.因此, 在数字取证场景中, 位置有效仅构成实质性证据审查的技术前提, 鉴定人员仍需结合被引原文、上下文及完整证据链, 进一步核验陈述的真实性、关联性和支持程度.
TEC-Gen从证据元组表示构建、候选证据检索与组织、引用约束生成、可溯源性校验4个阶段建立统一流程, 使生成结果中的关键陈述能对应可检查的原始证据位置.本文所称可溯源与可核验, 主要指结果具备明确的证据回链路径和人工复查入口, 而不表示系统已经自动完成陈述-证据语义支持性判断.
本文在已经脱敏处理的自建数字取证证据库上开展实验.该证据库由大连理工大学信息检索研究室团队在合作数字取证实验与司法鉴定实践场景中建立, 共覆盖14个案件, 包含2 739 634条原始取证记录.实验仅保留文本内容、来源文件、定位信息、时间戳和关键实体等研究所需字段, 不包含可识别自然人身份或案件敏感信息.证据来源具有明显的多源异构特征, 主要体现在3个方面.
1)来源平台多样, 涉及不同取证工具、业务平台与终端设备.
2)数据格式异构, 既包括结构化记录或半结构化记录, 也包括需经解析后才能转化为可读文本的原始取证条目.
3)证据粒度不一致, 不同来源记录在时间表达、字段组织和定位方式上存在显著差异.
上述异构性使得同个案件中的行为线索、通信关系和资金往来往往分散在不同来源和不同粒度的记录中, 给统一检索、交叉核验和结果回链带来困难.
为了适配本文提出的可溯源生成任务, 实验预处理阶段对原始取证记录进行统一解析与结构化整理, 形成包含文本内容、来源文件、定位信息、时间戳和关键实体等字段的证据表示, 为后续候选证据组织、引用约束生成和结果回链提供基础.
在查询构建方面, 采用正式查询集作为统一评测输入, 共包含120条查询.查询内容面向数字取证场景中的典型案情分析需求, 覆盖实体检索、时序行为分析和案件摘要生成3类任务, 每类查询数量均为40条.该设置兼顾数字取证场景中精确证据定位、跨记录行为分析和案情整体归纳等不同层次的分析需求.
为了保证实验过程的可比性和数据边界的清晰性, 查询集划分如下:训练集包含60条查询, 6个案件; 验证集包含30条查询, 4个案件; 测试集包含30条查询, 4个案件.主实验默认在测试集上进行, 即以30条测试查询作为评测输入.对于给定查询, 仅在其所属案件的证据子集中完成候选证据组织与生成, 从而避免跨案件信息泄漏, 使实验设置更符合实际办案场景.
为了验证TEC-Gen的有效性, 在统一数据划分和实验协议下, 选取3类具有代表性的生成范式进行对比, 分别对应无外部证据支撑、通用检索增强生成和本文提出的结构化证据约束可溯源生成.
1)Vanilla LLM(Vanilla Large Language Model):采用闭卷生成(Closed-Book Generation)[23]设定, 仅输入案件分析查询, 由LLM基于参数中内化知识直接生成结果, 不引入任何外部证据, 用于考察无检索支撑条件下的基础表现.
2)Standard RAG(Standard Retrieval-Augmented Generation)[24].采用通用检索增强生成范式, 先根据查询从证据集合中组织相关文本片段作为候选证据, 再将候选证据拼接为上下文输入生成模型, 但不显式要求输出来源引用, 也不对生成结果进行溯源校验.
本文采用ROUGE-L(Recall-Oriented Understudy for Gisting Evaluation-Longest Common Subsequence)、实体准确率(Entity Precision, P)、实体召回率(Entity Recall, R)、实体 F1 值(Entity F1-Score, F1)、可溯源性(Traceability)评价方法性能.上述指标分别从文本对齐、关键事实覆盖和结果可溯源性这3个方面刻画系统在数字取证场景中的生成能力.
ROUGE-L衡量生成结果与参考答案在序列层面的重合程度, 计算公式如下:
ROUGE-L=
其中,
PLCS=
X表示生成文本, m表示生成文本长度, Y表示参考文本, n表示参考文本长度, LCS(X, Y)表示二者的最长公共子序列长度, β 表示超参数.ROUGE-L指标用于衡量生成文本与参考答案的整体对齐程度.
在数字取证场景中, 关键实体通常构成案件行为链、时间链和资金链的基础锚点.若关键实体遗漏, 即使生成文本整体通顺, 也可能影响案情分析的完整性; 若实体表达错误, 可能进一步影响后续证据定位和事实判断.因此, 本文同时报告实体准确率(P)、实体召回率(R)、实体F1值(F1), 评估生成结果对关键实体的识别与覆盖情况.本文所称关键实体主要指数字取证案情分析中具有判别作用的事实要素, 如账号、手机号、金额、时间和设备标识等.上述指标计算公式如下:
P=
R=
F1=
其中, TP表示实体识别中的真阳性数量, FP表示实体识别中的假阳性数量, FN表示实体识别中的假阴性数量.P用于衡量生成结果中关键实体表达的准确程度, R用于衡量对关键信息的覆盖能力, F1综合反映实体识别结果在准确性与完整性之间的平衡.
Traceability指标衡量生成结果中关键陈述所附引用的定位有效比例, 即来源引用能否被解析并对应到候选证据中的有效原始位置, 定义见式(2).该指标反映生成结果的可回链性和可复查性, 但不衡量陈述-证据之间的语义蕴含程度, 也不等同于事实正确率或证据充分性.一个位置有效的引用仍可能由于上下文缺失、证据关联较弱或模型过度推断而无法充分支持相应陈述.因此, 被引内容是否构成充分支持, 仍需由鉴定人员结合原始记录及其上下文进行实质核验.对于不输出显式来源引用的方法, 不计算该指标, 记为N/A.
本文所有实验均在统一的数据划分与实验协议下进行.对于给定查询, 首先依据其所属的数据划分选取评测样本, 再根据查询对应的案件范围限制证据组织空间, 仅在允许案件集合内加载和处理相关证据, 避免跨案件信息泄漏.
在候选证据组织方面, Standard RAG和TEC-Gen均基于查询从证据集合中组织候选证据.其中, Standard RAG直接采用文本内容作为候选输入, 不显式保留来源元数据; TEC-Gen以证据元组为基本组织单位, 在候选阶段保留文本内容与来源文件、定位信息及关键实体等结构信息.设置候选证据数量K=8.
在检索实现上, Standard RAG和TEC-Gen均采用字符n-gram TF-IDF计算查询与证据记录之间的相关性, 保证两种方法使用相同的检索配置.该设置主要面向账号、手机号、金额、时间戳、设备标识和来源文件名等精确事实锚点, 设置候选证据数K=8.
在生成设置方面, 所有方法均在统一提示与调用协议下运行.实验采用按时间顺序组织的提示模板, 温度参数设为0.2, 最大生成长度设为768个Token.不同方法之间的主要差异在于是否接入结构化候选证据以及是否施加引用约束.
在大语言基础模型方面, 本文采用DeepSeek-V3.2[25]、GLM-5[26]和Qwen3.5-Plus[27]进行实验.所有方法均在相同数据划分、相同候选证据配置和相同评测协议下运行, 考察方法在不同生成后端上的稳定性.
不同基础模型下各方法的指标值如表1所示.由表可见, TEC-Gen在DeepSeek-V3.2、GLM-5、Qwen3.5-Plus这3个基础模型上均表现出一致趋势:在指标值上均优于Vanilla LLM和Standard RAG, 说明TEC-Gen能在提升案情分析文本整体对齐程度的同时, 显著增强结果与原始证据之间的显式对应关系.相比仅依赖闭卷生成的Vanilla LLM, 引入外部候选证据有助于改善生成结果的事实支撑.在此基础上, 进一步引入证据元组表示、引用约束生成和可溯源性校验后, TEC-Gen在文本质量、关键事实覆盖和结果核验性方面表现出更明显优势.
 | 表1 不同基础模型下各方法的指标值 Table 1 Metric values of different methods under different base models % |
从Vanilla LLM到Standard RAG的性能提升表明, 引入外部候选证据能有效缓解闭卷生成中的信息缺失问题. Standard RAG到TEC-Gen的进一步性能提升则说明在数字取证场景中, 仅采用“ 检索-拼接-生成” 的通用流程仍不足以充分满足任务需求.以DeepSeek-V3.2为例, 相比Vanilla LLM, Standard RAG的ROUGE-L值提升10.93%, 在Standard RAG的基础上, TEC-Gen的ROUGE-L值进一步提升17.91%.在F1指标上, 相比Standard RAG, TEC-Gen提升16.11%.在GLM-5和Qwen3.5-Plus上的实验结果也呈现出相同趋势.这表明, TEC-Gen获得的性能增益不能简单归因于外部证据的引入, 而是来自结构化证据表示、引用约束生成和结果回链机制的协同作用.
上述增益首先体现在文本对齐质量和关键事实覆盖能力上.相比Standard RAG, TEC-Gen在3个基础模型上的ROUGE-L和F1指标均得到同步提升, 说明结构化证据表示增强候选证据的完整性和可利用性.对于数字取证任务, 生成模型所需的不仅仅是数量更多的文本片段, 还包括具有明确来源的文件、定位信息和关键实体的证据单元.证据元组表示能保留原始记录边界及其结构属性, 使生成模型更稳定地识别和利用候选证据中的核心事实, 从而同时改善生成文本与参考答案的对齐程度以及关键事实的表达能力.
相比文本对齐和实体覆盖指标, Traceability指标主要反映TEC-Gen与通用RAG在结果回链机制上的差异.由于Vanilla LLM和Standard RAG均不输出显式来源引用, Traceability指标记为N/A.TEC-Gen在3个基础模型上的Traceability值均超过94%, 在DeepSeek-V3.2上达到96.82%.这意味着, 在需要进行溯源校验的关键陈述中, 96.82%的引用能被正确解析, 并定位至候选证据中的有效原始位置.该结果表明, TEC-Gen能较稳定地为生成陈述提供明确的证据回链路径和人工复查入口.
总之, TEC-Gen的性能提升主要来自如下两个方面.一方面, 证据元组表示提高候选证据与数字取证查询之间的匹配质量, 使输入生成模块的证据更贴近任务需求; 另一方面, 引用约束生成和后置校验将证据支撑关系显式引入生成过程, 使系统输出不再停留于内容相关的要求, 而能进一步满足结果可核验的要求.这说明, 数字取证场景中的生成任务不能简单等同于一般文本生成, 其核心不只在于回答是否通顺, 更在于关键结论是否能被原始证据支撑和复查.
为了进一步分析各组成模块对端到端案情分析任务的具体贡献, 在DeepSeek-V3.2上开展消融实验.设置3种变体:去除引用约束生成(without Citation Instruction, w/o CI)、去除证据元组表示(without Evidence Tuple, w/o ET)、去除稀疏相关性排序(without Sparse Ranking, w/o SP).其中, w/o SP 移除字符n-gram TF-IDF 相关性排序, 并采用固定随机种子从查询所属案件中随机选取相同数量的证据元组.上述变体分别对应可核验生成能力、结构化证据表示能力和当前候选证据组织机制, 能从模块层面解释主实验结果的原因.因此, 消融实验不仅用于分析TEC-Gen内部模块贡献, 也从证据元组表示、引用约束生成和候选证据组织三个角度与不同简化变体进行对比.
各模块消融实验结果如表2所示.由表可见, 去除引用约束生成(w/o CI)后, ROUGE-L值由48.73%降至33.84%, F1值由41.41%降至27.53%, 同时无法提供Traceability值.该结果表明, 引用约束生成不仅影响结果是否携带来源信息, 还直接约束生成过程, 使方法更依赖候选证据而非自由归纳.
| 表2 各模块消融实验结果 Table 2 Ablation results of different modules % |
去除证据元组表示(w/o ET)后, ROUGE-L、F1指标分别降至29.46%和23.85%, Traceability指标由96.82%降至72.14%.由此说明若仅使用普通文本片段, 难以有效利用原始记录的来源与定位信息, 从而同时影响文本质量与结果可核验性.相比之下, 去除稀疏相关性排序(w/o SP)后, ROUGE-L、F1指标分别降至24.18%和19.50%, 说明围绕查询组织相关候选证据是后续生成的重要基础之一.该结果仅反映当前稀疏相关性排序的作用, 不能据此推断稀疏检索优于稠密检索或混合检索.
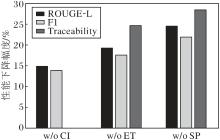
图2进一步给出不同消融配置下ROUGE-L、F1、Traceability指标的相对退化幅度.由图可看出, w/o SP在各项指标上的退化最明显, w/o ET次之, 而w/o CI的影响主要集中在可核验性缺失和文本质量下降上.该结果与表2中的绝对结果一致, 进一步说明候选证据组织、证据元组表示和引用约束生成在系统中承担不同但相互依赖的作用.
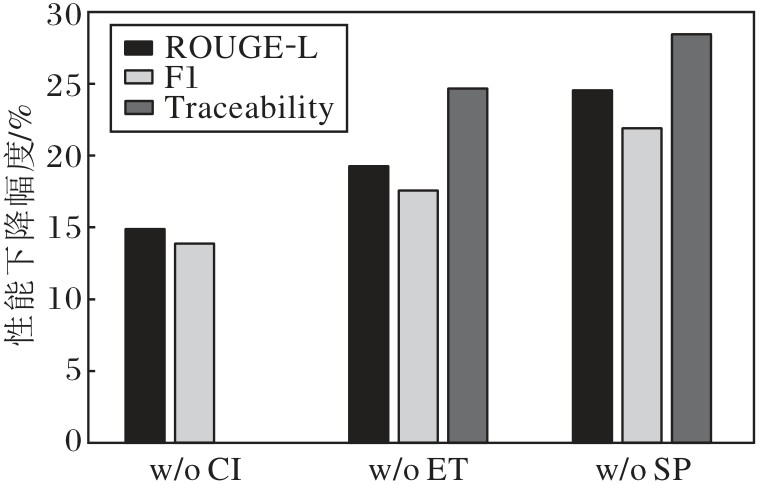 | 图2 不同消融配置下的性能下降情况Fig.2 Performance degradation under different ablation configurations |
综合表2和图2可看出, 不同模块作用的侧重点存在差异:引用约束生成主要影响结果回链能力, 证据元组表示影响候选证据的结构完整性, 基于查询的候选证据组织为后续生成提供有效证据基础.
候选证据数K决定生成阶段可见证据的覆盖范围, 并直接影响上下文噪声水平.过小的K可能导致关键信息缺失, 过大的K可能引入冗余证据, 干扰方法对核心事实的利用.为了分析K对系统性能的影响, 定义K=4, 8, 12, 在DeepSeek-V3.2上进行实验, 结果如表3所示.从表可看出, TEC-Gen性能随K的变化呈现先提升后趋于稳定的趋势, K=8时在ROUGE-L、F1、Traceability指标上均取得最优值.相比之下, K=4时性能明显偏低, 说明候选证据覆盖不足会限制生成结果对关键事实的表达能力.当K=12时, 虽然证据覆盖有所增加, 但整体性能未继续提升, 反而略有下降.这一现象表明, 在数字取证场景中, 候选证据并非越多越好.过小的K可能导致证据覆盖不足, 限制生成结果对关键事实的表达效果; 过大的K会引入冗余证据, 干扰生成阶段对关键信息的聚焦, 并削弱引用约束的作用效果.因此, 候选证据数量需要在证据覆盖与上下文噪声之间取得平衡.实验表明, 将K设为8时能在两者之间取得较优折衷.
| 表3 K对TEC-Gen性能的影响 Table 3 Effect of K on TEC-Gen performance |
为了进一步说明TEC-Gen在数字取证场景中的实际作用, 选取一条真实查询进行用例核查.所选查询同时包含关键词定位、人物识别、交互模式归纳和线索判断等需求.TEC-Gen先围绕查询组织候选证据, 再将候选记录表示为包含文本、来源文件和行号信息的证据元组, 再通过引用约束生成带有来源标记的案情分析结果, 并对引用位置进行校验.
选取案件2025XXX-000-00X中的查询作为分析对象.
Query:在案件中检索涉及“ 支付” 的记录, 概括相关参与方与交互情况, 并分析现有记录是否足以支持存在交易或推广行为的判断.
该查询同时包含关键词定位、人物识别、交互模式归纳和线索判断等多层需求, 具有较强的数字取证案情分析代表性.对于此类问题, 系统不仅需要定位与“ 支付” 相关的原始记录, 还需要在多条证据基础上组织案情描述, 并尽可能将关键结论落实到可检查的原始证据位置.
为了更直观地展示不同方法的差异, 表4给出同一查询下3种方法的输出结果对比.由表可看出, Vanilla LLM在缺少外部证据支撑的情况下, 直接推测存在转账、资金往来或推广互动, 相关判断无法回到原始记录进行核查.Standard RAG虽然利用检索结果, 但未建立关键陈述与具体来源位置之间的显式对应关系, 其关于“ 交易或推广线索” 的概括同样超出现有记录能直接支持的范围.TEC-Gen为通信时间、参与方和消息内容等事实附加来源与行号, 使鉴定人员能逐句回到原始记录进行复查.
| 表4 各方法在同一案例上的输出结果 Table 4 Outputs of different methods on the same case |
为了检验引用定位有效与语义支持充分之间的差异, 本文对表4中的TEC-Gen输出进行案例级人工逐句核查.核查结果表明, 账号、时间、参与方和消息文本能由对应证据直接确认, 但“ 可以” 的具体含义及相关记录是否代表真实交易、资金往来或推广行为, 不能仅由当前被引片段确定.因此, 修订后的输出仅保留可直接观察的通信事实, 并将交易性质和行为意图明确列为需要结合上下文及其它证据进一步核实的事项.该案例说明, Traceability指标能提供可靠的证据复查入口, 并帮助发现潜在的过度推断, 但不能替代对陈述-证据语义支持性的实质判断.
该案例同时反映当前方法的适用边界:当关键事件分散于多个来源和时段时, 候选证据覆盖不足可能导致证据链不完整; 实体别名或多重标识可能影响跨记录归并; 弱相关记录即使具有有效引用, 也不足以单独支持身份、意图、因果关系或交易性质等判断.因此, TEC-Gen的输出应作为证据定位和辅助研判的支撑, 由鉴定人员结合完整原始记录进行复核, 不应直接替代司法鉴定意见.
针对数字取证场景中证据来源复杂、结构异构且结果需具备可核验性的特点, 本文提出面向数字取证的可溯源生成方法(TEC-Gen).该方法通过构建证据元组表示, 将原始记录内容与来源文件、定位信息和关键实体进行统一组织, 并在生成阶段引入引用约束与结果校验机制, 使生成文本中的关键陈述能与原始证据位置建立对应关系.
在经过脱敏处理的自建数字取证证据库上的实验表明, 与闭卷生成和通用检索增强生成方法相比, TEC-Gen在文本质量、关键事实覆盖和结果可溯源性方面均取得稳定提升.在DeepSeek-V3.2、GLM-5、Qwen3.5-Plus这3个基础模型上, ROUGE-L、实体F1指标均显著优于对比方法, 同时生成结果能稳定回链至原始证据位置.消融实验进一步表明, 证据元组表示、候选证据组织方式及引用约束机制均对TEC-Gen性能具有重要影响.敏感性分析则说明候选证据数量需要在证据覆盖与上下文噪声之间取得平衡.上述结果表明, 在数字取证场景中, 仅依赖通用RAG范式难以满足任务需求, 而结合结构化证据表示与生成约束能有效提升结果质量与可核验性.
尽管TEC-Gen取得较优性能, 但仍存在一定局限.当关键证据分散或候选覆盖不足时, 长时间跨度事件链的组织可能不完整; 实体别名及多重标识也可能影响跨记录归并.此外, 本文的Traceability指标仅衡量引用能否定位至有效原始位置, 不能自动判断被引内容是否充分支持相应陈述, 也不能替代对证据真实性、关联性和证明力的实质审查.因此, 本文的“ 可溯源性” 和“ 可核验性” 主要指生成结果具备明确的证据回链路径和人工复查入口, 并不意味着系统能保证陈述的事实正确性或证据充分性.
后续将研究面向数字取证语料的稀疏-稠密混合检索, 在保留精确标识匹配、结果可解释性和过程可复现性的同时, 增强对别名、同义改写及隐含语义关联的召回能力.后续研究还将结合实体归一化、时间一致性、跨记录关联和陈述-证据语义支持性校验, 完善人工评价与鉴定人员复核机制, 进一步提升复杂证据链场景中的分析可靠性.
本文责任编委 马少平
Recommended by Associate Editor MA Shaoping
| [1] |
|
| [2] |
|
| [3] |
|
| [4] |
|
| [5] |
|
| [6] |
|
| [7] |
|
| [8] |
|
| [9] |
|
| [10] |
|
| [11] |
|
| [12] |
|
| [13] |
|
| [14] |
|
| [15] |
|
| [16] |
|
| [17] |
|
| [18] |
|
| [19] |
|
| [20] |
|
| [21] |
|
| [22] |
|
| [23] |
|
| [24] |
|
| [25] |
|
| [26] |
|
| [27] |
|