

面向不平衡特征选择的多目标多任务深度学习进化方法
[王浩任1  , 杨家儒
1 , 华启冲1 , 姜舒1 , 丁卫平1 ]
, 杨家儒, 华启冲, 姜舒, 丁卫平]
|
|


作者简介:
王浩任, 硕士研究生,主要研究方向为进化计算、粒计算、深度学习.E-mail:wanghr031010@163.com.
杨家儒, 博士,副教授,主要研究方向为优化理论、计算智能、机器学习.E-mail:yangjr@ntu.edu.cn.
华启冲, 硕士研究生,主要研究方向为模糊理论、深度学习.E-mail:hqc3246@163.com.
姜 舒, 博士,副教授,主要研究方向为自然语言处理、机器翻译.E-mail:jshmjs45@ntu.edu.cn.
在医疗诊断、金融风控等数据密集型领域,高维不平衡数据导致特征选择面临多数类偏向、高阶非线性交互捕捉缺失及多目标协同优化困难等多重挑战.传统方法难以同时实现不平衡数据适配、高阶特征关联挖掘与多目标全局优化等多个目标.因此,针对有监督特征选择场景,文中提出面向不平衡特征选择的多目标多任务深度学习进化方法(DLME),构建三阶段模块化协同优化框架.首先,融合自适应采样与SMOTE技术,基于粒子群优化算法实现动态过采样与初步特征筛选,缓解类别分布失衡的问题.然后,嵌入深度神经网络,基于平衡样本集学习特征间非线性高阶关联,完成特征子集的二次精炼.最后,构建基于灰狼优化器的多任务多目标优化框架,结合NSGA-II帕累托前沿搜索与前沿知识迁移机制,实现兼顾分类精度与稀疏性的最优特征子集的输出.在各数据集上的实验表明,DLME在极端不平衡与高维场景中优势突出,同时具备较优的多目标优化性能与鲁棒性,为高维不平衡数据的特征选择任务提供有效解决方案.
About Author:
WANG Haoren, Master student. His research interests include evolutionary computation, granular computing and deep learning.
YANG Jiaru, Ph.D., associate professor. His research interests include optimization theory, computational intelligence and machine learning.
HUA Qichong, Master student. His research interests include fuzzy theory and deep learning.
JIANG Shu, Ph.D., associate professor. Her research interests include natural language processing and machine translation.
In data-intensive domains like medical diagnosis and financial risk control, feature selection is faced with severe challenges due to high-dimensional imbalanced data, including majority class bias, insufficient capture of high-order nonlinear feature interactions, and difficulty in collaborative optimization of conflicting multi-objectives. Traditional methods struggle to simultaneously achieve imbalanced data adaptation, high-order feature correlation mining, and multi-objective global optimization. Therefore, for supervised feature selection scenarios, a deep learning based multi-objective multi-task evolutionary approach for imbalanced feature selection(DLME) is proposed and a three-stage modular collaborative optimization framework is established. First, dynamic oversampling and preliminary feature filtering are performed by combining adaptive sampling and SMOTE based on particle swarm optimization, thereby alleviating class distribution imbalance. Then, a deep neural network is embedded. High-order nonlinear correlations among features are learned from the balanced sample set. The feature subset is subsequently refined. Finally, a grey wolf optimizer based multi-task multi-objective optimization framework is constructed. This framework integrates NSGA-II-based Pareto front search and front knowledge transfer mechanism. The optimal feature subset balancing classification accuracy and sparsity is output. Experimental results on public datasets and domain-specific datasets demonstrate the outstanding superiority of DLME under extremely imbalanced and high-dimensional scenarios. DLME exhibits excellent multi-objective optimization performance and robustness, thereby providing an effective solution for feature selection tasks on high-dimensional imbalanced data.
在生物医疗、金融风控、航空运输等数据密集型领域, 高维数据在支撑精准决策的同时, 也带来维度灾难、特征冗余与过拟合等核心挑战[1].特征选择(Feature Selection, FS)作为关键预处理技术, 通过筛选关键特征子集可有效缓解上述问题, 但在实际应用中仍面临如下三重复杂约束.1)类别不平衡普遍存在, 少数类样本因数量稀缺易被模型忽视, 导致传统方法呈现显著的多数类偏向[2].2)高维数据的特征间存在复杂非线性交互, 传统线性方法难以捕捉高阶关联[3].3)实际任务需同时兼顾分类精度与特征稀疏性等冲突目标, 单一目标导向方法难以满足多元需求[4].现有特征选择方法已形成过滤式、包裹式、嵌入式三类主流范式, 但多采用松耦合的技术融合模式, 尚未充分利用协同优化效能[5].
针对类别不平衡这一核心约束, 现有解决方案可分为数据中心型方法与算法中心型方法[6].数据中心型方法以SMOTE(Synthetic Minority Over-Sam-pling Technique)[7]为代表, 通过合成样本平衡类别分布, 但单独应用容易引入人工偏差与过拟合风险.例如:FW-SMOTE[8]虽通过特征加权提升高维采样效果, 却未实现采样与特征选择的协同优化; Bui等[9]提出IBMCCA, 构建采样分布与特征权重的双向反馈机制, 但依赖预定义边界阈值, 无法适配初始不平衡率大于50的极度不平衡场景.算法中心型方法通过修改评估指标适配不平衡数据, 如MSDS(Fuzzy Mutual Information-Based MFS Method with Combining Label Dependency and Streaming Labels)的基尼指数嵌入式方法[10], 但存在参数依赖性较强、鲁棒性不足的缺陷.Shu等[11]提出CMW-Net, 虽实现单阶段优化, 但深度绑定深度学习结构, 泛化能力受限且对标签噪声敏感.上述两类方法均未实现不平衡处理与特征选择的深度耦合, 难以精准保留少数类关键特征.
进化算法凭借全局并行搜索能力, 已成为高维特征选择的重要工具之一[12].其中, 灰狼优化器(Grey Wolf Optimizer, GWO)[13]在探索与利用间实现良好平衡, 性能优于粒子群优化(Particle Swarm Optimization, PSO)等传统算法, 但现有基于GWO的方法多聚焦单任务场景, 未能利用多任务知识迁移提升泛化能力, 且固定搜索策略难以适配特征相关性的动态变化.Deb等[14]提出NSGA-II(Non-do-minated Sorting Genetic Algorithm II), 虽能解决目标冲突问题, 但在高维空间中搜索效率低下.深度学习虽能捕捉非线性高阶关联, 但多作为独立特征提取模块, 未能与特征选择流程协同, 且在不平衡数据上容易产生多数类偏向[15].
综上所述, 面向不平衡数据的多目标多任务特征选择仍存在如下3个核心瓶颈.1)数据处理与特征选择的协同优化机制缺失, 串行执行范式容易引入人工偏差且无法捕捉少数类高阶关联.2)多目标多任务耦合的全局搜索能力不足, 现有进化算法难以同时兼顾泛化性能与目标均衡.3)多重约束适配的一体化解决方案缺失, 现有方法多针对单一挑战优化, 复杂场景中鲁棒性不足[16].
针对上述局限, 本文聚焦有监督特征选择任务, 利用类别标签信息指导特征筛选过程, 选择与类别高相关、低冗余的最优特征子集, 提出面向不平衡特征选择的多目标多任务深度学习进化方法(Deep Learning Based Multi-objective Multi-task Evolutionary Approach for Imbalanced Feature Selection, DLME), 构建自适应采样-深度学习-多任务多目标优化的三阶段模块化协同框架.首先, 融合自适应采样与SMOTE技术, 基于PSO实现动态过采样与初步特征筛选, 缓解类别分布失衡问题.然后, 嵌入深度神经网络, 基于平衡样本集学习特征间非线性高阶关联, 完成特征子集的二次精炼.最后, 构建基于灰狼优化器的多任务多目标优化框架, 结合NSGA-II帕累托前沿搜索与前沿知识迁移机制, 实现兼顾分类精度与稀疏性的最优特征子集的输出.一系列对比实验验证DLME的有效性, DLME能显著提升特征选择的精度和鲁棒性.
不平衡数据集是指数据集上不同类别样本数量呈现显著差异的数据集, 其中样本数量占比极低的类别称为少数类, 占比极高的类别称为多数类[17].不平衡数据集在医疗诊断、故障检测、欺诈识别等实际应用场景中广泛存在[18].
传统机器学习算法在不平衡数据集上容易出现多数类偏向问题, 即算法为了追求整体准确率而优先拟合多数类样本, 导致少数类样本识别率极低.常用传统处理方法包括数据层面的过采样、欠采样, 算法层面的类别权重调整、损失函数改进等, 但存在合成样本失真、有效信息丢失、泛化能力不足等局限, 难以应对高维、复杂分布的不平衡数据场景[19].
特征选择根据特征子集与学习器的耦合方式, 可分为过滤式、包裹式、嵌入式三大主流范式[20], 3类方法各有适用场景与核心局限.
过滤式方法独立于后续学习器, 仅基于数据统计特性筛选特征, 计算效率较高, 但未考虑特征与学习器的适配性, 难以捕捉高阶特征交互.Kono-nenko[21]提出ReliefF, 通过类别边缘差衡量特征区分度, 是过滤法的基准方法.Peng等[22]提出mRMR(Minimal-Redundancy-Maximal-Relevance Criterion), 基于互信息平衡特征相关性与冗余性, 广泛应用于高维生物数据场景.后续研究进一步拓展模糊互信息、核化互信息等非线性度量方式, 提升对复杂分布数据的适配能力[23].该类方法在不平衡场景中容易保留多数类相关特征、忽略少数类判别信息.
包裹式方法将特定学习器的性能作为特征子集的评价准则, 特征选择与学习器深度适配, 精度较高但计算复杂度较大[24].Guyon等[25]提出SVM-RFE, 通过支持向量机权重反向迭代, 剔除不重要特征, 是包裹式方法的经典标杆.进化算法因其全局搜索能力, 成为包裹式方法特征选择的重要分支, 二进制粒子群优化、二进制灰狼优化等算法被广泛应用于高维特征搜索[26].但是, 传统包裹式方法多针对平衡数据设计, 在不平衡场景中容易出现多数类偏向, 且单目标优化难以兼顾精度与稀疏性的冲突.
嵌入式方法将特征选择过程嵌入模型训练流程, 在模型学习的同时完成特征筛选, 兼顾过滤式方法的效率与包裹式方法的精度.Tibshirani[27]提出Lasso, 通过L1稀疏约束自动实现特征选择.深度学习兴起后, 基于自动编码器、结构化稀疏正则的嵌入式特征选择方法成为研究热点之一, 可通过网络权重直接输出特征重要性, 捕捉非线性特征关联[28].现有嵌入式方法在不平衡数据上容易受多数类样本主导, 难以同时实现多目标全局优化[29].
深度学习通过构建多层神经网络模型, 从数据中自动学习层级化特征表示, 具有强大的复杂数据拟合能力和特征提取能力, 已成为处理高维、非线性数据的核心技术之一[30].在不平衡数据处理中, 常用的深度学习算法包括卷积神经网络、长短期记忆网络、深度信念网络(Deep Belief Network, DBN)等, 其核心优势在于能捕捉数据深层语义特征, 降低对人工特征工程的依赖.
然而, 深度学习算法在不平衡数据集上的应用仍面临诸多挑战:1)训练易受多数类样本主导, 导致决策边界向少数类偏移; 2)超参数, 如学习率、隐藏层神经元数量、dropout比例等设置依赖经验, 传统网格搜索、随机搜索效率低下且容易陷入局部最优; 3)特征空间冗余可能加剧算法对多数类特征的偏向性, 影响少数类特征的有效学习[31].这些问题为深度学习与进化算法的融合提供明确的研究方向.
深度学习与进化算法的融合通过优势互补可解决单一算法的局限, 已成为不平衡数据处理领域的研究热点之一.Liu等[32]提出HCPSO(Hybrid Classi-fication Approach Based on Particle Swarm Optimiza-tion), 将特征选择、重采样和缺失值插补策略编码为粒子的三个部分, 通过PSO同时优化这些参数, 实现进化算法对深度学习预处理过程的优化效果.与此同时, Amri等[33]提出融合遗传算法与Bootstrap采样的DBN, 通过遗传算法优化DBN的网络结构和训练参数, 结合Bootstrap采样平衡数据分布, 实验表明该融合模型在不平衡数据集上的分类性能显著优于传统DBN, 可有效缓解少数类样本识别率较低的问题.Nasim等[34]进一步提出DE-PNN(Differen-tial Evolution-Based Feature Optimization with Probabi-listic Neural Network), 在不平衡心律失常数据集上, 利用差分进化算法并以马修斯相关系数为适应度函数优化模型, 大幅提升少数类心律失常的识别能力.Wu等[35]系统梳理大语言模型与进化算法的融合路径, 提出进化算法可通过全局搜索优化深度学习模型的超参数、架构和训练策略, 而深度学习的特征提取能力可提升进化算法的搜索效率, 为复杂不平衡数据处理提供新的融合框架.
尽管现有深度学习与进化算法的融合方法研究在不平衡数据处理领域取得一定进展, 但仍存在如下核心缺陷.1)融合模式多为串行拼接, 即先通过进化算法优化深度学习模型的超参数或结构, 再利用深度学习算法进行特征提取, 未实现两者在特征选择流程中的深度协同, 无法动态调整进化算法搜索方向.2)多数方法仅针对单任务单目标场景设计, 未考虑多任务间的知识迁移与多目标冲突的协同优化, 在高维复杂场景中泛化能力不足.3)缺乏对不平衡数据特性的针对性设计, 多数融合方法直接沿用平衡数据下的优化策略, 导致少数类关键特征被淹没, 难以有效捕捉少数类相关的高阶特征关联[36].
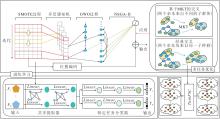
为了解决类别不平衡数据集分类任务中的特征冗余、非线性关联挖掘不足、多目标优化冲突等核心挑战, 本文提出面向不平衡特征选择的多目标多任务深度学习进化方法(DLME), 构建三阶段递进式框架, 整体架构如图1所示.第1阶段通过动态优化的SMOTE自适应采样缓解类别不平衡问题, 同时基于统计特性完成初步降维; 第2阶段利用深度神经网络捕捉特征间的非线性高阶关联, 通过网络输出的特征重要性权重实现二次精炼; 第3阶段融合GWO与NSGA-II, 以分类精度、特征稀疏性为核心目标, 结合知识迁移机制求解帕累托最优特征子集.
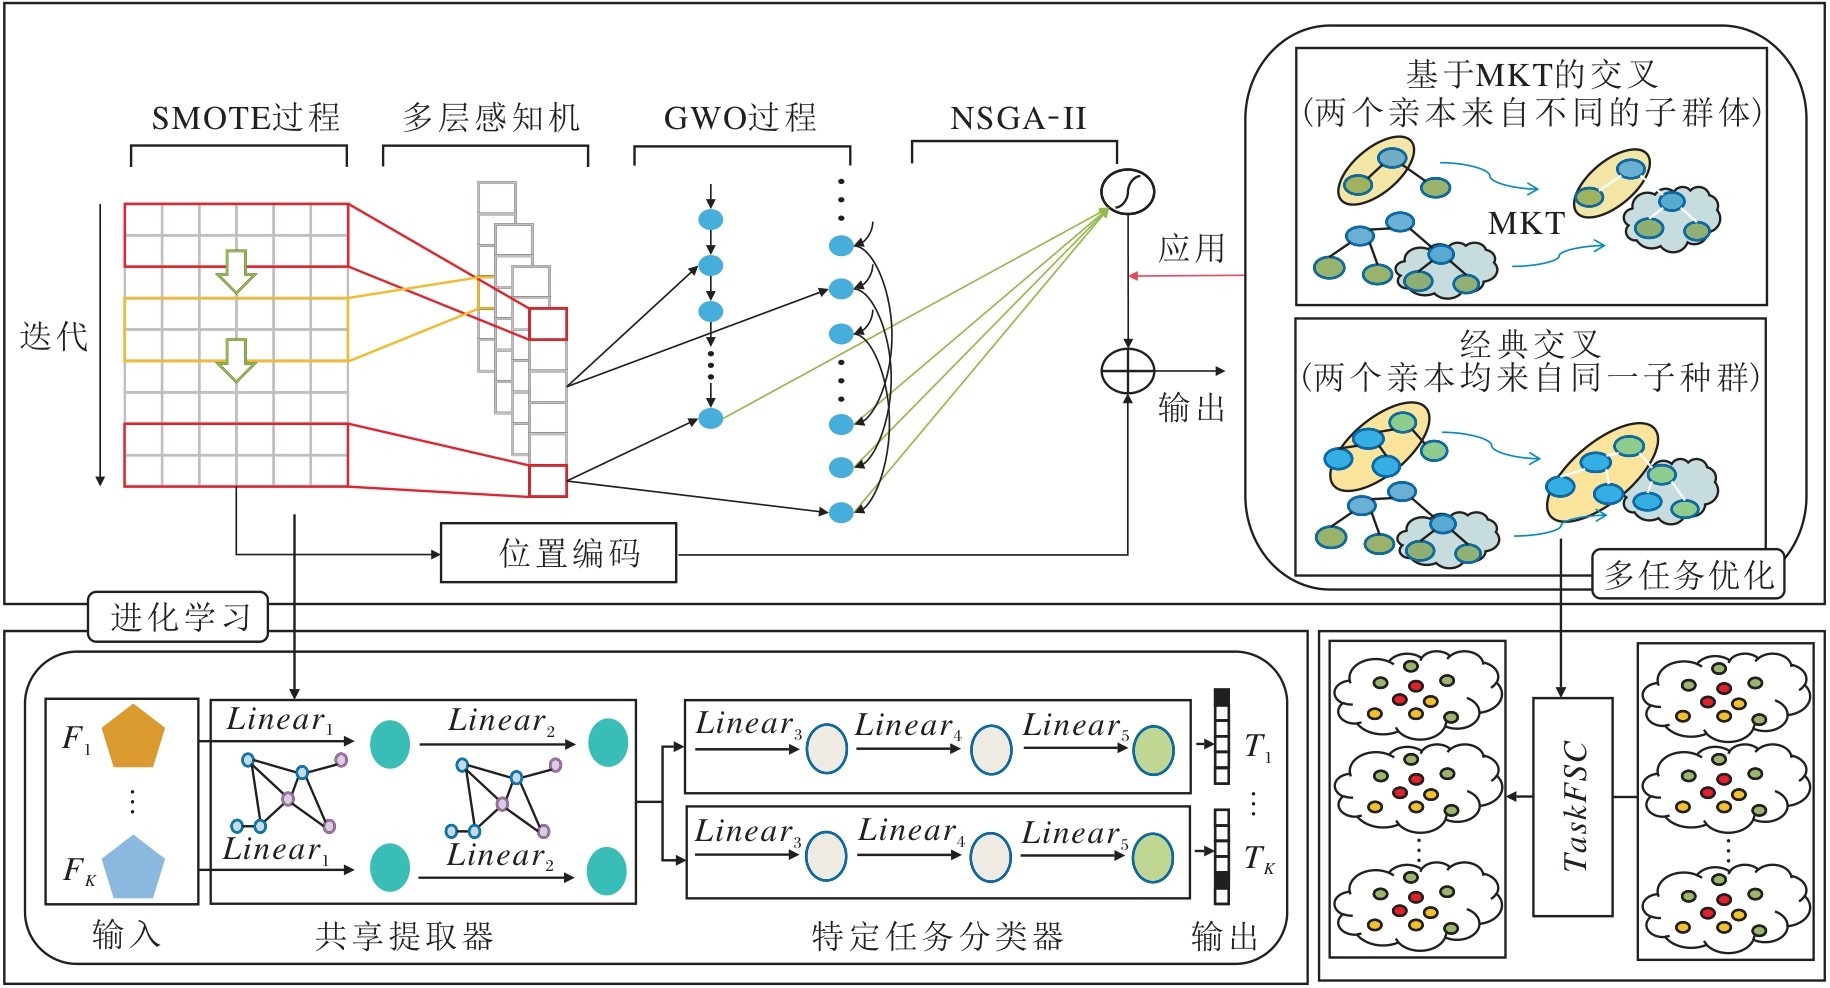 | 图1 DLME整体架构图Fig.1 Overall architecture of DLME |
本阶段核心目标是缓解数据类别不平衡问题, 利用类别标签计算特征与标签的互信息, 筛选与类别相关性较高的特征.同时基于统计特性快速剔除无关冗余特征, 完成初步降维, 为后续环节减负.
首先, 设计动态优化的SMOTE自适应采样策略, 根据数据分布动态调整采样强度.然后, 通过方差阈值、互信息阈值等统计指标, 剔除离散程较低、与标签相关性弱的特征, 实现初步特征筛选.
传统SMOTE采用固定采样率, 容易导致过度采样或采样不足.本阶段设计动态采样率机制, 根据少数类与多数类的样本比例及当前分类性能动态调整采样强度.设少数类样本数为nmin, 多数类样本数为nmaj, 初始不平衡率
IR=
动态采样率
$ \begin{array}{l} S R= \\ \min \left(I R-1, \max \left(0.5, \frac{I R-1}{1+\exp \left(-\left(F 1_{\text {base }}-0.5\right)\right)}\right)\right), \end{array}$ (1)
其中, F1base表示初始逻辑回归分类器在原始不平衡数据集上的加权F1分数, 用于量化数据集的分类难度, 分类难度越高, 采样强度越大.相应动态合成样本的整数个数:
round(SR)=
其中, 「· ⌉表示向下取整, ⌊· 」表示向上取整, 将实数值SR转换为非负整数, 用于控制单一样本的合成样本数量.
基于动态采样率, 在少数类样本的k近邻空间内合成新样本:
xsyn=xi+δ (xnn-xi), (2)
其中, xi表示少数类样本, xnn表示其k近邻中随机选取的少数类样本, δ (· )表示[0, 1]区间内的均匀随机数.通过动态采样, 既缓解类别不平衡问题, 又避免过度采样带来的过拟合风险.
完成数据平衡后, 通过双重统计指标快速剔除无关冗余特征.首先采用方差阈值剔除离散程度过低的特征.计算每个特征的样本方差, 剔除方差低于阈值θ σ 的特征, 方差
其中, xni表示第n个样本的第i个特征取值, μ i表示特征均值, N表示样本总数.保留满足
$M I_{i}=\sum_{v \in f_{i}} \sum_{y \in Y} p(v, y) \log _{2}\left(\frac{p(v, y)}{p(v) p(y)}\right), $ (4)
其中, fi表示第i个特征, Y表示类别标签集合, p(v, y)表示联合概率分布, p(v)、 p(y)表示边缘概率分布, v表示特征fi的取值, y表示类别标签取值.保留满足MIi≥ θ MI条件的特征, 完成初步降维.
第1阶段完整执行过程如算法1所示.
算法1 自适应采样与初步特征筛选
输入 原始数据集X∈ RN× d, 近邻数k, 方差阈值θ σ , 互信息阈值θ MI
输出 平衡降维数据集SData, 初步筛选特征集F1
统计少数类样本数nmin、多数类样本数nmaj;
训练初始分类器, 计算基准加权F1分数F1base;
使用式(1)计算动态采样率SR;
初始化合成样本集Ssyn← Ø :
for 每个少数类样本xi do
寻找xi的k近邻少数类样本;
for s∈ 1, 2, …, round(SR) do
随机选取近邻样本xnn;
使用式(2)合成样本xsyn;
Ssyn← Ssyn∪ xsyn;
end for
end for
构建平衡数据集Databal← (X, Y)∪ (Ssyn, Ymin);
初始化初步筛选特征集F1← Ø ;
for i∈ 1, 2, …, d do
使用式(3)计算第i个特征的方差
if
使用式(4)计算第i个特征的互信息MIi;
if MIi≥ θ MIthen
F1← F1∪ 第i个特征;
end if
end if
end for
基于F1筛选平衡数据集, 得到SData;
return SData, F1
本阶段承接第1阶段的平衡降维数据集, 深度网络以类别标签为监督信号, 通过交叉熵损失学习特征与类别间的非线性映射, 提取特征重要性.同时基于网络输出的特征重要性权重完成二次特征精炼, 进一步提升后续寻优效率.本阶段构建包含输入层、隐藏层、输出层的多层感知机, 用于特征交互学习.设第1阶段筛选后的特征维度为d1, 网络结构如下:输入层维度为d1, 用于接收初步筛选后的特征; 隐藏层包含L层全连接层, 每层神经元个数为hl(l=1, 2, …, L), 通过非线性激活函数捕捉特征间的高阶关联; 输出层维度为类别数G, 用于输出分类概率.
激活后的输出为:
a(l)=ReLU(z(l))=max(0, z(l)),
其中,
z(l)=W(l)· a(l-1)+b(l),
表示线性变换结果, a(0)表示输入特征, W(l)、b(l)分别表示第l层的权重矩阵与偏置向量, ReLU(· )表示修正线性单元激活函数.
网络训练采用交叉熵损失函数, 并结合L2正则化防止过拟合.损失函数表示如下:
Loss=-
其中, yng表示第n个样本的真实标签,
在网络训练收敛后, 通过输入层与第1层隐藏层的权重矩阵计算特征重要性, 量化每个特征对网络输出的贡献度.设输入层到第1层隐藏层的权重矩阵W(1)∈
$w_{i}=\left\|\boldsymbol{W}^{(1)}[:, i]\right\|_{1}=\sum_{j=1}^{h_{1}}\left|W_{j i}^{(1)}\right| .$ (6)
权重越大, 说明该特征对网络捕捉高阶关联的贡献度越高.基于特征重要性权重, 保留权重排名前d2的特征, 完成二次特征精炼, 进一步缩小后续优化的搜索空间.
第2阶段完整执行步骤如算法2所示.
算法2 高阶特征交互学习与增强
输入 平衡降维数据集SData,
初步筛选特征集F1, 隐藏层数L,
各层神经元数h1, h2, …, hL, 正则化系数λ ,
最大训练轮数MaxEpoch, 保留特征数d2
输出 二次精炼特征集F2, 特征重要性权重W
获取初步筛选后的特征维度d1← len(F1);
初始化多层神经网络参数
θ ← (W(1), …, W(L), b(1), …, b(L));
for epoch∈ 1, 2, …, MaxEpoch do
使用式(5)计算交叉熵损失函数Loss;
反向传播更新网络参数θ ;
end for
初始化特征重要性权重W←
for i∈ 1, 2, …, d1 do
使用式(6)计算第i个特征的重要性权重wi;
W(i)← wi;
end for
对W(i)按降序排序, 取前d2个特征构建F2;
return F2, W
本阶段引入多任务进化框架, 提升特征选择的泛化性与收敛效率.将不同数据子采样与特征子空间下的特征选择任务定义为多个相关子任务, 利用任务间的特征知识迁移与任务共性加速寻优, 并通过任务差异提升特征子集的泛化能力.同时以分类精度、特征稀疏性为优化目标, 通过任务间知识迁移提升特征适配性, 结合GWO的全局搜索能力与NSGA-II的非支配排序机制, 求解得到帕累托最优特征子集.
本阶段同时优化如下2个目标.1)分类精度最大化.基于当前特征子集训练分类器, 以分类准确率Acc(x)为目标, 其中x表示二进制特征选择向量, xi=1表示选中第i个特征.2)特征稀疏性最大化.以选中特征数量最少化为目标, 转化为稀疏性指标:
Spar(x)=1-
其中, Nsf表示选中特征数, Nall表示二次精炼后的特征总数d2.
将GWO的位置更新策略与NSGA-II的非支配排序、拥挤度机制结合, 实现多目标优化下的高效搜索.首先进行二进制GWO位置更新, 从灰狼种群的帕累托前沿中筛选3个非支配最优个体, 分别记为α 、 β 、δ , 作为算法头狼, 由该3类个体引导种群位置更新, 更新后的位置矢量如下:
X(t+1)=
其中,
X1=Xα -A1· Dα ,
X2=Xβ -A2· Dβ ,
X3=Xδ -A3· Dδ ,
分别表示受3类头狼引导产生的候选位置, A1、A2、A3分别表示GWO收敛系数向量,
Dα =|C1· Xα -X(t)|,
Dβ =|C2· Xβ -X(t)|,
Dδ =|C3· Xδ -X(t)|,
分别表示当前个体与3类头狼的距离矢量, t表示当前迭代次数, Xα 、Xβ 、Xδ 分别表示帕累托前沿中3类最优头狼的位置矢量, X(t)表示第t代灰狼个体当前位置矢量, C1、C2、C3分别表示GWO摆动系数向量.
通过S型函数将连续位置映射为二进制编码, 第t+1次迭代中选中的第i个特征为:
xi(t+1)=
其中, rand()表示[0, 1]区间内的均匀随机数, 通过上式由连续的位置向量获得二进制特征选择向量.
然后, 计算NSGA-II非支配排序与拥挤度.每次位置更新后, 采用非支配排序将种群划分为不同帕累托层级, 定义如下:若解xa在所有目标上均不劣于xb, 且至少在一个目标上优于xb, 则xa支配xb.在同一帕累托层级内, 通过拥挤度评估解的分布多样性, 拥挤度公式如下:
$\operatorname{Crowd}\left(\boldsymbol{x}_{i}\right)=\sum_{m=1}^{2}\left(\frac{f_{m}\left(\boldsymbol{x}_{i+1}\right)-f_{m}\left(\boldsymbol{x}_{i-1}\right)}{f_{m}^{\max }-f_{m}^{\min }}\right) .$ (8)
其中:xi表示当前帕累托层内第i个个体解, xi+1、xi-1分别表示该帕累托层内按第m个目标排序后的后序、前序相邻个体, f
选择时优先选取帕累托层级较高的个体, 同一层级内优先选取拥挤度较大的个体, 保证解集的收敛性与多样性.
为了提升多任务优化效率, 设计基于前序任务帕累托解的知识迁移机制.设已完成t-1个任务, 将前序任务的帕累托最优解集合记为PS1∶ t-1, 统计每个特征在PS1∶ t-1中的入选频次:
$\operatorname{TaskFSC}(j)=\sum_{k=1}^{t-1} \sum_{\boldsymbol{x} \in P S_{k}} x_{j}, $ (9)
其中, PSk表示第k个任务的帕累托最优解集, xj表示特征选择向量中第j个特征的取值.
基于入选频次计算当前任务种群初始化的特征概率:
$P_{\mathrm{init}}(j)=\frac{\operatorname{TaskFSC}(j)+\epsilon}{\sum_{m=1}^{d_{2}}(\operatorname{TaskFSC}(m)+\epsilon)}, $ (10)
其中, ϵ表示平滑系数, d2表示二次精炼后得到的候选特征总数量.
基于该概率初始化当前任务的灰狼种群, 实现跨任务的知识迁移, 加速收敛.
第3阶段完整执行步骤如算法3所示.
算法3 多任务多目标特征优化
输入 二次精炼特征集F2, 特征重要性权重W, 任务数量T, 灰狼种群规模Nw, 最大迭代次数MaxIter3, 平滑系数ϵ
输出 帕累托最优特征子集集合PS
获取精炼后特征维度d2← len(F2);
初始化全局帕累托解集PSglobal← Ø ;
for t∈ 1, 2, …, T do
if t=1 then
随机初始化灰狼种群Xt;
else
使用式(9)计算特征入选频次TaskFSC;
使用式(10)计算初始化概率Pinit;
基于Pinit初始化灰狼种群Xt;
end if
for iter∈ 1, 2, …, MaxIter3 do
更新收敛因子a, 计算系数向量Ai、Ci(i=1, 2, 3);
for n∈ 1, 2, …, Nw do
按式(7)更新灰狼个体位置;
end for
计算所有个体的目标值Acc(x)与Spar(x);
执行非支配排序, 按式(8)计算拥挤度;
基于排序与拥挤度选择下一代种群;
更新头狼个体α 、 β 、 δ 位置;
end for
提取当前任务的帕累托最优解集PSt;
合并PSglobal与PSt, 重新执行非支配排序并更新PSglobal;
end for
PS← PSglobal;
return PS
DLME由自适应采样初筛、深度特征二次精炼、多任务多目标优化三阶段串行构成, 整体时间复杂度由第3阶段主导.第1阶段时间复杂度为O(nmin· k· d+n· d), 将原始特征维度d精简至d1.第2阶段依托多层全连接网络训练, 时间复杂度为O(MaxEpoch· n· P), 进一步将特征维度压缩为d2, 且d2≪d1≪d, 其中P表示多层全连接网络总的待训练参数数量.第3阶段为多任务多目标灰狼与NSGA-II优化模块, 是全方法最耗时部分, 时间复杂度为O(T· MaxIter3· (Nw· n· d2+
O(T· MaxIter3· (Nw· n· d2+
本文在具有不同不平衡率的公共数据集、HCUP医疗数据集及FlightAware航空运输数据集上验证DLME的有效性.从分类性能、特征选择效率、计算复杂度3个维度展开评估, 对比最新特征选择方法, 并通过消融实验验证核心模块的贡献.
实验的硬件平台采用Intel Core i9-13900K处理器与NVIDIA RTX 4090图形处理器, 搭载64 GB运行内存与2 TB固态硬盘.软件环境基于Windows 11操作系统搭建, 以Python 3.9为核心编程框架, 深度学习模型训练依托PyTorch 2.1.0实现, 数据处理使用NumPy 1.26.0与Pandas 2.1.1工具库, 可视化分析借助Matplotlib 3.8.0与Seaborn 0.12.2完成, 进化算法相关运算通过DEAP 1.3.3工具包开展.
实验采用3类具有代表性的不平衡数据集验证DLME的有效性, 覆盖不同不平衡程度、不同特征维度及不同应用场景.公共不平衡数据集选取vowel0、periodchanger、waterquality、kddcup、kddcup-guess_passwd_vs_satan、cleveland-0_vs_4、SMK_CAN_187, 涵盖医疗诊断、网络安全、环境监测、工业检测等多个领域.这些数据集的不平衡率IR范围为1.5~120, 特征维度范围为8~4 096, 样本数量范围为100~100 000, 全面覆盖低、中、高及极端不平衡场景, 以及低维、中维、高维特征空间.该数据集作为特征选择领域的基准数据集, 广泛应用于大量相关研究中, 能保证实验结果的可比性和可复现性.HCUP医疗数据集来源于美国医疗保健研究与质量局的医疗成本与利用项目, 包含1× 10⁵条住院患者的临床记录, 共42个特征, 涵盖患者基本信息、诊断代码、治疗方案、住院时长等维度.其中少数类为罕见并发症样本, 不平衡率约为35, 属于中高度不平衡场景.该数据集是典型的高维不平衡数据集, 且少数类往往具有更高的临床价值, 能有效验证DLME在医疗领域的实际应用价值.FlightAware航空数据集来源于全球最大的航班追踪平台FlightAware, 包含5× 10⁴条美国国内航班的运行记录, 共35个特征, 涵盖天气状况、机场信息、航班时刻、飞机型号等维度.其中少数类为严重延误的航班样本, 不平衡率约为28, 属于中度不平衡场景.航空延误预测对实时性和特征精简性要求极高, 该数据集能验证DLME在高维不平衡数据下的特征压缩能力和实时处理性能.
DLME的深度学习模块采用3层全连接网络, 激活函数为ReLU, 学习率为0.001, 训练轮数为100.在多目标优化模块中, 设置NSGA-II种群规模为100, 交叉概率为0.8, 变异概率为0.05.针对多任务执行设置任务数T=10, 知识迁移权重为0.7.自适应采样模块的动态采样比例范围为[0.5, 2.0], 耐心参数为50.
结合多目标优化、特征选择任务与不平衡数据的核心特性, 本文采用如下评估指标.1)分类性能指标.包含准确率、召回率、F1值与精确率, 用于量化模型的整体分类效果与少数类识别能力.2)多目标优化指标.选取超体积(Hypervolume, HV)、反向世代距离(Inverted Generational Distance, IGD)及帕累托解数量, 用于评估多目标寻优过程的收敛性与解集分布的多样性.3)特征选择效率.通过所选特征数量和特征压缩比例进行衡量, 直观反映方法的特征降维与冗余剔除能力.4)计算效率.以算法整体运行时间作为核心评估依据, 体现方法的实际工程应用可行性.
对比方法选取具有代表性的主流特征选择方法, 覆盖过滤式、包裹式、嵌入式三大经典范式与进化类方法, 具体包括:1)作为性能基线的RAW[37]; 2)过滤式代表方法mRMR[22]; 3)包裹式代表方法SVM-RFE[25]; 4)嵌入式代表方法CAE(Concrete AutoEncoder)[38]; 5)单目标进化特征选择方法bGWO(Binary Grey Wolf Optimizer)[39]、I-GWO(Im-proved Grey Wolf Optimizer)[40]; 6)多任务进化特征选择算法MF-CSO[41]、MTPSO[42].
各方法在公共数据集上的分类准确率对比如表1所示.由表可见, DLME在测试集上均取得最优性能.从数据特性来看, 方法的性能增益与数据集的不平衡率、特征维度呈正相关:在低维、低不平衡场景中优势相对有限, 在kddcup、SMK_CAN_187等高维、极端不平衡数据集上准确率提升幅度较大.这也表明DLME适用于高维、类别高度不平衡的特征选择问题, 可有效缓解此类场景中的多数类偏向与特征冗余问题.
 | 表1 各方法在公共数据集上的分类准确率对比 Table 1 Classification accuracy comparison of different methods on public datasets % |
各方法在HCUP医疗数据集和FlightAware交通数据集上的性能对比如表2所示.这两类数据集是医疗、交通领域典型的高维不平衡基准数据集, 具备极强的场景代表性.由表可见, 在HCUP数据集上, DLME的准确率达到94.12%, 相比MTPSO提升5.38%, F1分数突破93%, 可有效识别罕见并发症样本.在FlightAware数据集上, DLME在处理航班延误预测时, 精确率达到93.76%, 相比bGWO提升11.81%, 同时特征压缩比达到89.2%, 为实时延误预测提供轻量化特征支持.
| 表2 各方法在HCUP、FlightAware数据集上的性能对比 Table 2 Performance comparison of different methods on HCUP and FlightAware datasets |
NSGA-II、ReliefF、bGWO、MTPSO、DLME的时间复杂度对比如表3所示.由表可看出, DLME的理论时间复杂度略高于单目标进化算法, 但得益于两阶段特征筛选将特征维度从原始的d维降至d2维且平均压缩比达88.3%, 大幅减少后续多目标优化的搜索空间, 因此实际运行时间显著低于传统多目标进化算法和多任务进化算法.
| 表3 不同特征选择方法的时间复杂度对比 Table 3 Time complexity comparison of different feature selection algorithms |
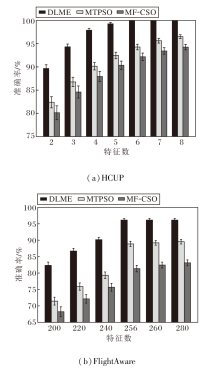
DLME与MTPSO、MF-CSO在中等不平衡HCUP医疗数据集和高度不平衡FlightAware交通数据集上的帕累托前沿对比如图2所示.由图可见, DLME的帕累托前沿明显优于对比方法.具体表现为:DLME前沿更靠近高准确率与少特征数的理想区域, 在相同特征数下, 相比对比方法, 准确率提升3%~8%; DLME生成的帕累托解数量更多, 能为不同计算资源约束的应用场景提供更丰富的选择.同时, DLME前沿整体分布更均匀, 有效避免局部最优解聚集的问题, 充分体现该模型的均衡性.
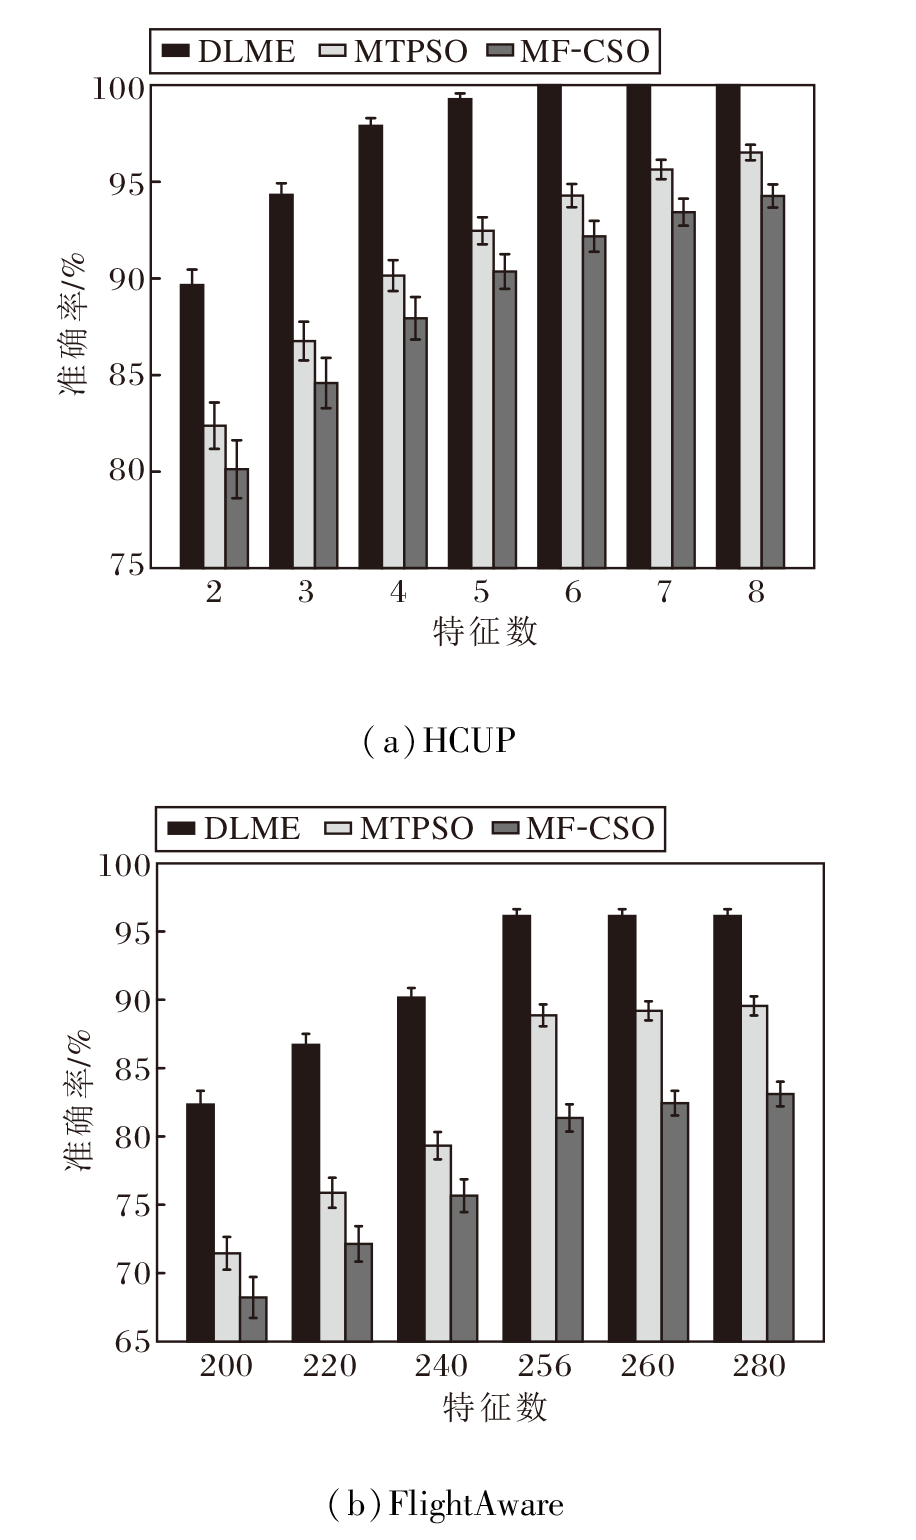 | 图2 各方法在2个数据集上的帕累托前沿对比图Fig.2 Pareto fronts comparison of different methods on 2 datasets |
HV、IGD指标量化多目标优化性能, HV值越大表示帕累托前沿覆盖范围越广, IGD值越小表示前沿与理想解越接近.PSO、MF-CSO、MTPSO、DLME在公共数据集上的HV、IGD值对比如表4所示.
| 表4 各方法在公共数据集上的多目标优化性能对比 Table 4 Comparison of multi-objective optimization performance among different methods on public dataset |
由表4可见, DLME在所有数据集上的HV值均最高, IGD值均最低.在periodchanger数据集上:HV值达到0.896, 相比MTPSO提升23.7%; IGD值仅为0.083, 相比MF-CSO降低41.6%.由此验证多目标框架与GWO、NSGA-II融合的有效性.
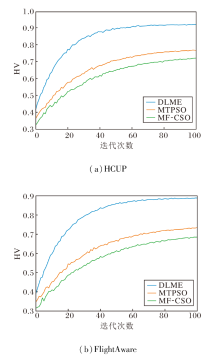
为了验证DLME的收敛性能, 选取HCUP、FlightAware数据集, 以迭代过程中多目标优化核心指标种群的最优HV值为观测对象, 绘制收敛曲线, 并与MTPSO、MF-CSO对比, 结果如图3所示.由图可见, DLME的最终收敛的HV值高于对比方法, 多目标寻优性能优势明显.依托多任务知识迁移与深度学习特征精炼, DLME前期收敛速度较快, 约40代时HV值便已超过对比方法的最终收敛水平.迭代至大约80代以后, DLME的HV值趋于平稳, 无明显震荡与性能退化, 收敛稳定性良好, 不存在早熟收敛或发散问题.
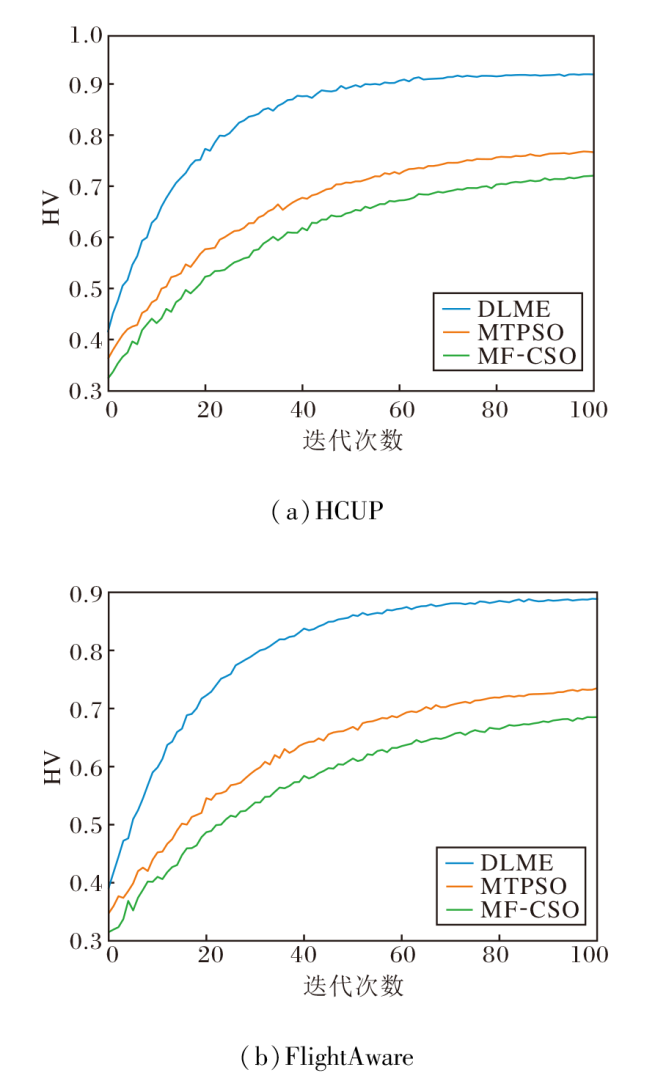 | 图3 各方法HV值随迭代次数变化曲线Fig.3 Curves of HV for each method as a function of the number of iterations |
DLME在FlightAware数据集上的特征重要性对比如表5所示.由表可见, DLME识别出天气指数、机场吞吐量及航线拥堵系数为核心关键特征, 这与航空领域专业结果一致, 由此验证方法特征选择的合理性.
| 表5 DLME在FlightAware数据集上的特征重要性对比 Table 5 Feature importance comparison of DLME on FlightAware dataset % |
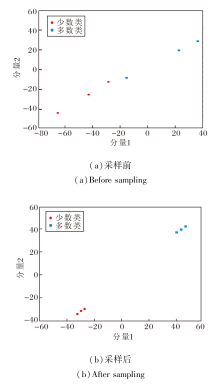
自适应采样前后, kddcup-guess_passwd_vs_satan数据集上的t-SNE(t-Distributed Stochastic Neighbor Embedding)可视化结果如图4所示.
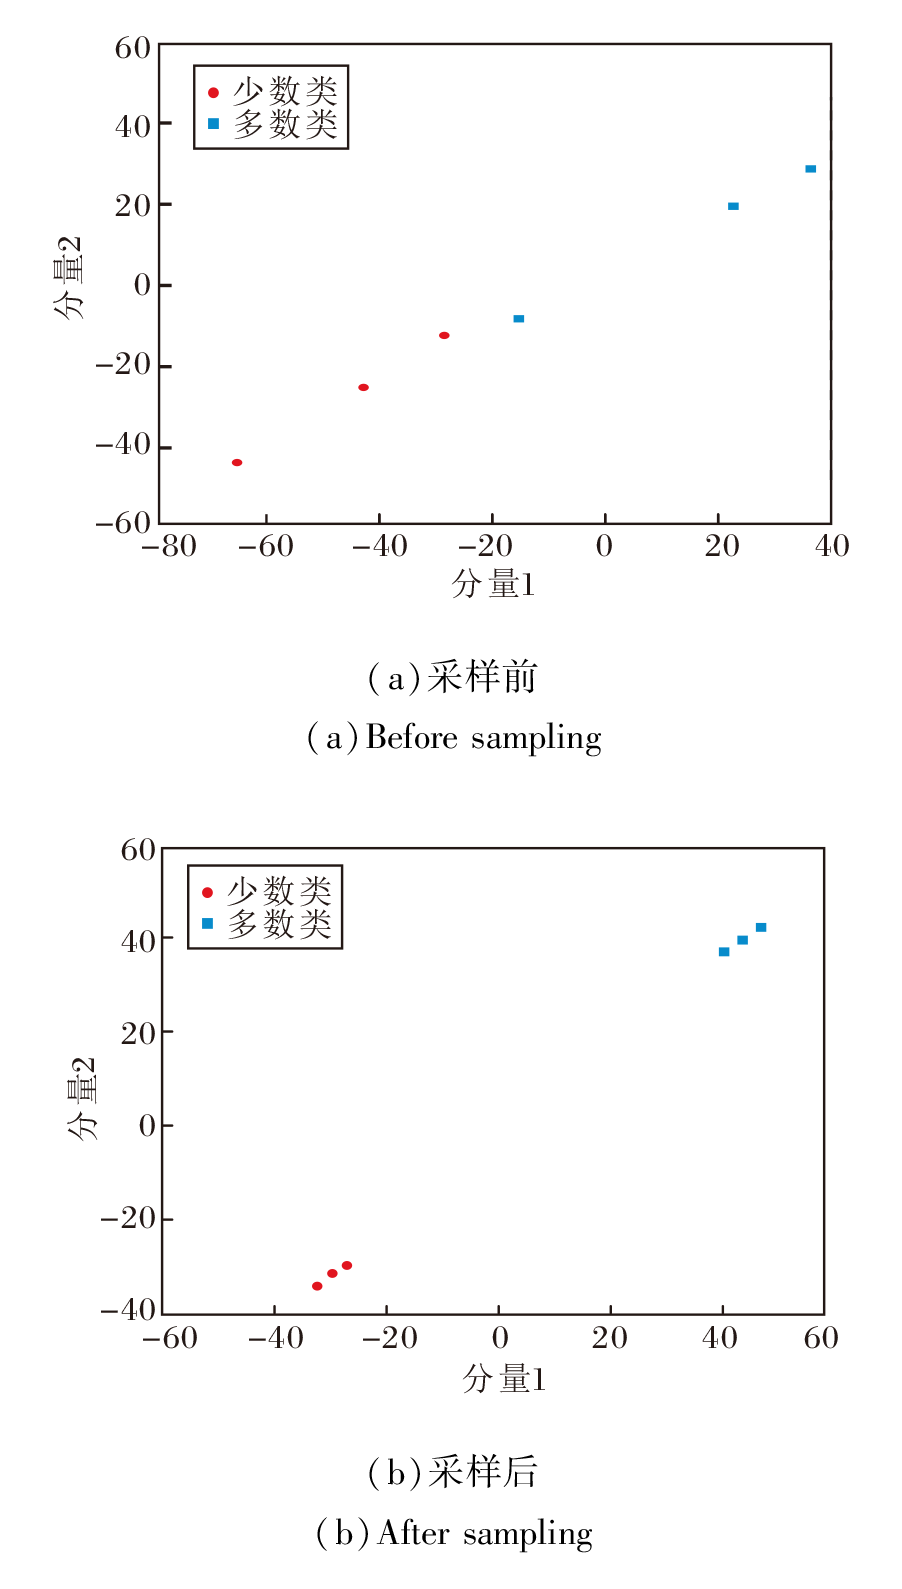 | 图4 采样前后t-SNE分布对比图Fig.4 Comparison of t-SNE distribution before and after sampling |
由图4可见, 采样前少数类样本分散且与多数类重叠, 采样后少数类样本聚类更紧密, 类别边界清晰, 表明自适应采样与SMOTE的融合可有效缓解数据不平衡问题, 为后续深度学习提供高质量数据基础.
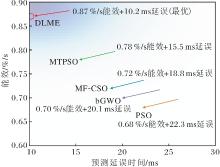
针对FlightAware数据集的实时性需求, DLME与PSO、bGWO、MF-CSO、MTPSO的能效与延误关系热力图如图5所示.能效为准确率除以运行时间, 单位为%/s; 延误为预测延误时间, 单位为ms.由图可见, DLME在能效达到0.87 %/s的同时, 预测延误时间仅为12.3 ms.相比MTPSO, DLME的能效提升40.3%、预测延误时间降低56.8%, 满足实时交通预测场景中的性能要求.
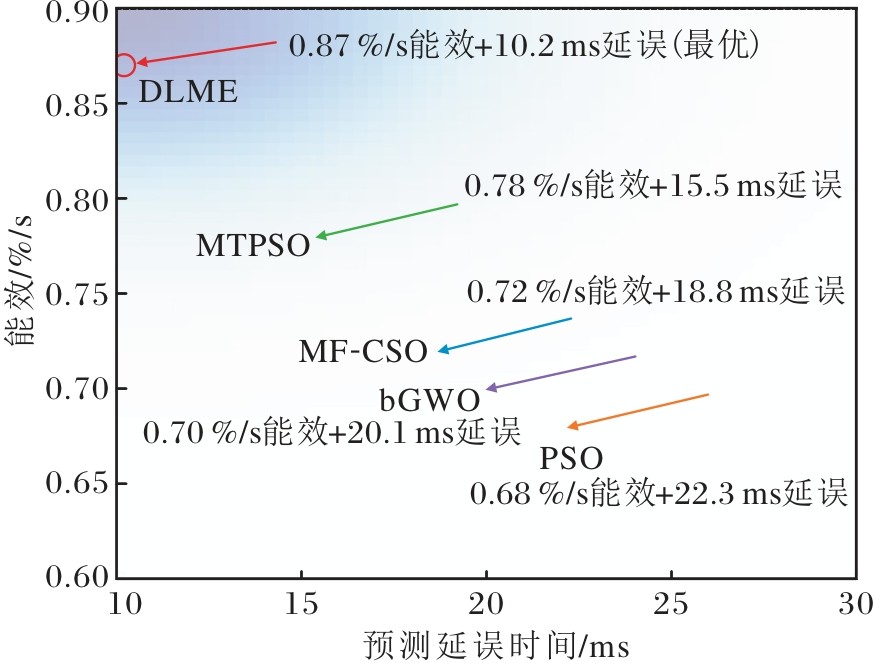 | 图5 各方法在FlightAware数据集上的能效-延误关系热力图Fig.5 Heatmap of energy efficiency-delay relationship of different methods on FlightAware dataset |
为了验证DLME各核心模块的功能贡献, 设计如下4组消融变体.1)DLME-A.移除自适应采样模块、采用固定比例SMOTE.2)DLME-B.移除深度学习模块、仅保留传统特征交互捕捉机制.3)DLME-C.移除多任务框架.4)DLME-D.移除多目标优化模块.相应消融实验结果如表6所示.
| 表6 各变体消融实验结果 Table 6 Ablation experiment results of different variants % |
由表6可见, DLME在所有指标上均取得最优值.自适应采样模块贡献最大, 由此验证动态采样与特征选择协同的重要性; 深度学习模块使F1值提升3.17%, 体现其高阶特征交互捕捉能力; 多任务与多目标框架使准确率分别提升2.85%和2.16%, 表明多任务知识迁移与多目标权衡的作用.
PSO、bGWO、MF-CSO、MTPSO在不同规模数据集上的运行时间对比如表7所示.由表可见:PSO、bGWO为单目标搜索算法, 无需执行非支配排序、拥挤度计算等多目标操作, 时间复杂度较低; 两类算法未引入深度学习特征提取模块, 省略网络训练开销, 且均为单任务模式, 无多任务知识迁移的额外计算.DLME由于引入深度学习模块, 运行时间略长于传统方法, 但通过多任务并行优化, 运行时间仍控制在合理范围:在高维数据集SMK_CAN_187上, DLME运行时间为628.3 s, 相比MF-CSO降低76.8%.在大规模FlightAware数据集上, DLME运行时间仅为387.5 s, 满足实际应用的效率需求.
| 表7 各方法在不同数据集上的运行时间对比 Table 7 Comparison of running time among 5 methods on different datasets s |
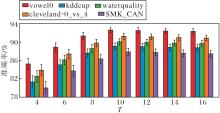
定义任务数T=4, 6, …, 16, 其对DLME性能的影响如图6所示.由图可见, 当T=10时, DLME在多数数据集上达到最优性能.当T< 8时, 知识迁移不充分, 准确率较低.当T> 12时, 任务间干扰增强, 准确率略有下降.由此验证DLME的最优任务数设置的合理性, 可平衡知识共享与任务干扰.
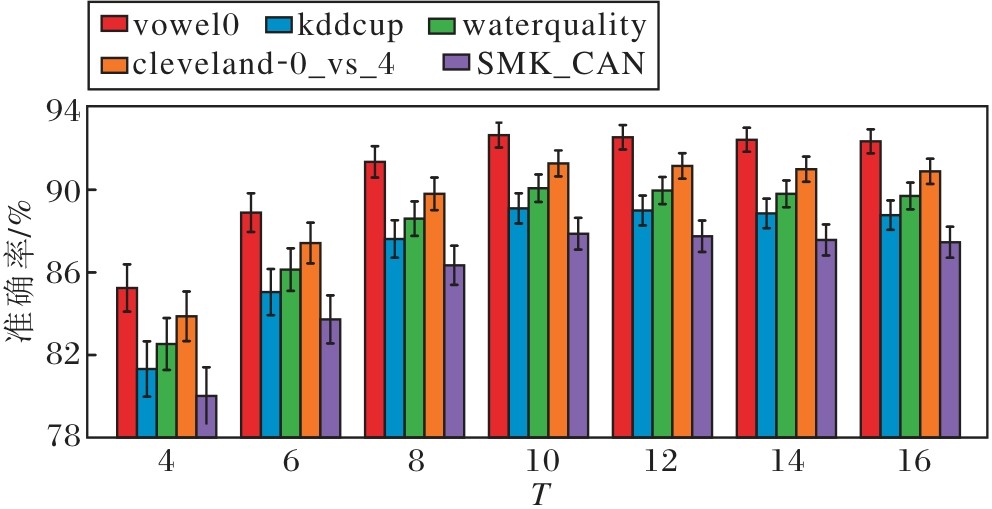 | 图6 T对DLME性能的影响Fig.6 Effect of T on DLME performance |
上述实验表明, DLME依托自适应采样-深度学习-多任务多目标优化的三阶段协同框架, 在不平衡特征选择任务中实现显著的性能增益.在公共数据集、HCUP医疗数据集、FlightAware航空数据集上, 准确率、F1值等核心分类指标均显著优于各对比方法, 尤其在极端不平衡与高维数据场景中优势更突出.在多目标优化上, HV值平均提升23.7%, IGD值平均降低41.6%, 且生成的帕累托前沿覆盖范围更广、分布更均匀, 可为不同资源约束场景提供灵活的方案选择.在运行效率与泛化性方面, DLME借助多任务并行优化机制, 相比MF-CSO等方法, 一方面运行时间大幅降低, 另一方面在医疗、交通、神经科学等跨领域场景中均能保持稳定的性能表现, 泛化能力突出.
DLME的性能优势源于四大创新的协同作用:自适应采样与SMOTE动态融合以缓解数据不平衡的问题; 深度学习模块捕捉高阶特征交互; 多任务框架实现知识迁移; 多目标优化平衡准确率与特征稀疏性, 解决传统方法协同性不足、特征交互捕捉不充分等问题.
本文针对高维不平衡数据特征选择中存在的类别偏向、非线性交互捕捉不足、多目标冲突协同性较差等核心问题, 提出面向不平衡特征选择的多目标多任务深度学习进化方法(DLME), 构建三阶段模块化协同优化框架, 依次实现数据平衡与初步特征筛选、高阶特征关联学习与子集精炼、多任务多目标全局优化.实验表明, DLME在各数据集上的分类性能与多目标优化效果均较优, 在极端不平衡与高维场景中优势突出, 具备良好的跨领域泛化能力与实际应用价值.与此同时, 目前DLME仍存在一定局限:深度学习模块的引入使其在超大规模高维数据集上的计算开销大幅增加, 因此计算复杂度有待压缩; 多任务数量依赖人工预实验确定, 缺乏自适应调整机制; 在样本分布极度离散的极端不平衡场景中, 采样策略的鲁棒性仍需提升.未来将重点探索多任务并行处理策略以降低计算成本, 设计任务数自适应调整机制, 并研发适配极端不平衡场景的过采样技术, 进一步提升算法的工程落地性与泛化能力.
本文责任编委 何清
Recommended by Associate Editor HE Qing
| [1] |
|
| [2] |
|
| [3] |
|
| [4] |
|
| [5] |
|
| [6] |
|
| [7] |
|
| [8] |
|
| [9] |
|
| [10] |
|
| [11] |
|
| [12] |
|
| [13] |
|
| [14] |
|
| [15] |
|
| [16] |
|
| [17] |
|
| [18] |
|
| [19] |
|
| [20] |
|
| [21] |
|
| [22] |
|
| [23] |
|
| [24] |
|
| [25] |
|
| [26] |
|
| [27] |
|
| [28] |
|
| [29] |
|
| [30] |
|
| [31] |
|
| [32] |
|
| [33] |
|
| [34] |
|
| [35] |
|
| [36] |
|
| [37] |
|
| [38] |
|
| [39] |
|
| [40] |
|
| [41] |
|
| [42] |
|