
面向遥感路径规划的神经符号协同方法
[杨铭1, 2  , 周植
1 , 张晨曦1, 2 , 田时雨1, 2 , 于坤杨1, 2 , 李宇峰1, 2 ]
, 周植, 张晨曦, 田时雨, 于坤杨, 李宇峰]
|
|


作者简介:
杨 铭, 硕士研究生,主要研究方向为神经符号计算、多模态学习.E-mail:yangm@lamda.nju.edu.cn.
周 植, 博士研究生,主要研究方向为神经符号计算、测试时适应学习.E-mail:zhouz@lamda.nju.edu.cn.
张晨曦, 硕士研究生,主要研究方向为神经符号计算、大语言模型数据选择.E-mail:zhangcx@lamda.nju.edu.cn.
田时雨, 博士研究生,主要研究方向为神经符号计算、空间推理.E-mail:tiansy@lamda.nju.edu.cn.
于坤杨, 硕士研究生,主要研究方向为神经符号计算、表格机器学习.E-mail:yuky@lamda.nju.edu.cn.
面向任务的遥感路径规划需要同时理解开放式语义约束并精细感知复杂地表环境,现有依赖高精地图、道路网络、车载传感器或人工规则的方法难以适应此类场景.为此,文中提出面向遥感路径规划的神经符号协同路径规划器(Neuro-Symbolic Collaborative Route Planner, NSCRP).首先,利用多模态大语言模型,将自然语言任务解析为结构化可通行规则与偏好表示,集成多个语义分割模型,构建稳定的地表语义图.然后,将语义约束与环境感知结果统一映射为像素级代价图,并通过启发式搜索在预测代价图上生成累计代价最小的可解释路径.NeSy-Route基准上的实验表明,NSCRP在约束满足、路径质量和整体规划能力方面均较优.
About Author:
YANG Ming, Master student. His research interests include neuro-symbolic computation and multimodal learning.
ZHOU Zhi, Ph.D. candidate. His research interests include neuro-symbolic computation and test-time adaptation.
ZHANG Chenxi, Master student. Her research interests include neuro-symbolic computation and data selection of large language models.
TIAN Shiyu, Ph.D. candidate. His research interests include neuro-symbolic computation and spatial reasoning.
YU Kunyang, Master student. His research interests include neuro-symbolic computation and tabular machine learning.
Task-oriented route planning from remote sensing imagery requires understanding of open-ended semantic constraints and fine-grained perception of complex land-cover environments. Existing methods relying on high-definition maps, road networks, vehicle-mounted sensors, or manually specified rules struggle to adapt to such scenarios. A neuro-symbolic collaborative route planner(NSCRP) for route planning in remote sensing is proposed. First, a multimodal large language model is utilized to translate natural-language tasks into structured traversability rules and preference representations. A stable semantic land-cover map is constructed by integrating multiple semantic segmentation models. Then, semantic constraints and environmental perception results are uniformly mapped into a pixel-level cost map. An interpretable path with the minimum accumulated cost is generated via heuristic search on the predicted cost map. Experiments based on NeSy-Route show that NSCRP outperforms existing approaches in constraint satisfaction, path quality, and overall planning ability.
遥感(Remote Sensing, RS)影像具有大范围观测和周期性更新等特点, 广泛应用于灾害响应[1]、农业管理[2]、生态环境调查与测绘[3]等领域, 相关研究还逐步拓展到地理空间基础模型的系统评测[4]与城市治理分析[5]中.随着遥感应用需求不断提升, 面向任务执行的空间决策逐渐成为遥感智能的重要发展方向.在应急救援[6]、野外通行[7]和复杂地形穿越[8]等场景中, 系统不仅需要识别地表环境, 还需要结合任务目标与约束条件生成可执行的行动方案.因此, 如何基于遥感观测实现面向任务的路径规划(Route Planning, RP), 已成为遥感智能化研究中的关键问题之一.
与一般视觉理解任务不同, 路径规划不仅要求系统识别地表中不同区域的语义类别, 还要求综合考虑通行性、用户偏好和目标位置等多种因素, 在全局范围内生成满足约束条件的可执行路径.该任务同时涉及环境建模、约束满足和搜索优化等多个环节, 能较完整地反映系统从感知到推理再到决策的综合能力.因此, 路径规划对于推动遥感智能系统由环境理解迈向任务决策具有重要支撑作用.
在遥感感知与多模态理解方面, 相关研究已覆盖场景分类[9]和目标检测[10]领域.在此基础上, Lee等[11]构建细粒度目标检测数据集KFGOD.Mei等[12]系统评测遥感分类与检测模型的鲁棒性.在语义分割方面, Wang等[13]设计LoveDA(Land-Cover Domain Adaptive Semantic Segmentation)数据集, 关注跨域地表覆盖分割.Boguszewski等[14]设计Land-Cover.ai(Land Cover from Aerial Imagery), 提供建筑、林地、水体和道路标注.Xia等[15]设计Open-EarthMap Dataset, 面向全球高分辨率地表覆盖制图.在视觉语言理解方面, Li等[16]设计VRSBench(Ver-satile Vision-Language Benchmark), 构建多任务评测数据.Luo等[17]提出SkySenseGPT, 通过细粒度指令调优增强遥感图文理解.相关工作还拓展至多步推理[18]、空间关系理解[19]和变化检测[20]领域.Wang等[21]提出XLRS-Bench, 引入路径规划任务, 但采用候选答案选择的封闭式评测, 将连续空间规划简化为离散判别, 难以充分评估开放场景中的路径生成、约束满足和空间一致性建模能力.Yang等[22]提出NeSy-Route, 进一步对开放约束路径规划进行分层评估, 并利用量化指标分析模型在约束理解、环境感知和路径生成等环节的性能瓶颈.
近期, 通用多模态大语言模型(Multimodal Large Language Model, MLLM)持续发展:Gemini[23]和GPT-5[24]作为闭源模型在多模态理解与推理方面取得代表性进展; Qwen3-VL[25]、LLaVA-OneVision-1.5[26]、InternVL3.5[27]、Qwen3.5[28]等开放模型推动可复现多模态体系的发展.这些模型在跨模态对齐和复杂推理方面表现出较强能力, 并具备一定的空间定位和坐标输出能力.遥感影像在视角、尺度和纹理分布上不同于自然图像, 通用模型缺乏充分的领域知识.同时, 路径规划不仅要求理解任务约束, 还需要构建精细的通行区域表示并保持长程空间一致性, 因此直接依赖端到端生成难以保证结果稳定性.
在遥感专用多模态模型中, SkySenseGPT[17]通过细粒度指令调优增强遥感图文理解, GeoChat[29]进一步强化遥感图像中的目标定位与对话能力.相关基准也在不断扩展, VRSBench[16]覆盖多种遥感视觉语言理解任务, XLRS-Bench[21]关注超大高分辨率影像理解.这些领域化模型与基准促进遥感问答等任务的发展, 但现有工作仍主要集中于识别、理解和问答, 缺少面向连续路径的优化求解能力.特别是在序列决策任务中, 现有模型通常未接受相应形式的数据训练, 难以稳定完成从开放约束解析到稠密路径生成的全过程.因此, 现有MLLM尚不足以独立支撑遥感场景中的开放约束路径规划.
通用分割架构Mask2Former(Masked-Attention Mask Transformer)[30]为统一语义解析提供基础.SegEarth-OV[31]进一步将开放词汇分割拓展到遥感影像.SegFormer[32]则以高效Transformer结构支持精细分割.上述方法能对多种地表类别进行有效识别, 为环境建模、区域属性分析和可通行区域提取提供精细的空间语义表示.然而, 语义分割模型本质上属于感知模型, 只能描述环境中的地表类别, 不能理解开放任务约束, 也无法在给定任务偏好下生成路径.
现有路径规划方法已广泛应用于许多领域[33, 34].$A^{*}$[35]通过启发式函数搜索最小代价路径.$Theta^{*}$[36]进一步面向栅格环境, 实现任意角度路径规划.这类启发式搜索方法可解释性强、求解稳定, 但大多建立在结构化环境的假设之上, 通常依赖高精地图、道路网络、车载传感器或预定义代价图.在真实开放遥感环境中, 场景结构和空间形态更复杂, 地面采集与人工更新的周期较长、成本较高, 难以适应快速变化场景.同时, 实际规划目标往往包含丰富的自然语言语义约束, 传统搜索方法无法自行完成约束理解与任务相关环境建模.
综上所述, MLLM擅长开放指令理解, 但难以独立承担精细像素级环境建模和稠密路径搜索.语义分割模型能提供地表感知结果, 却无法解析任务约束.传统搜索方法具有可控性和可解释性, 但依赖预定义的环境表示与代价.面向遥感开放约束路径规划需要将高层语义解析、细粒度环境感知和显式优化搜索组织到统一的结构化求解过程中.
为此, 本文提出面向遥感路径规划的神经符号协同路径规划器(Neuro-Symbolic Collaborative Route Planner, NSCRP).首先, 利用多模态大模型联合分析用户文本指令与遥感图像, 将开放式任务需求转化为结构化规划约束.然后, 调用多个语义分割模型感知相关地表类别, 并通过集成策略构建更鲁棒的地表语义表示.在此基础上, 将不同土地类别映射为差异化通行代价, 形成代价地图, 并结合A* 完成预测代价图上的累计代价最小路径搜索.NSCRP结合大模型的高层语义解析能力、专用感知模型的细粒度环境建模能力及经典搜索算法的稳健求解能力, 为复杂遥感场景的路径规划提供一种兼顾灵活性、准确性与可解释性的解决方案.
给定一幅遥感图像I、一条自然语言约束指令Q、起点S和终点E, 路径规划目标是在图像对应的空间网格上生成一条满足约束条件的路径序列.设遥感图像I∈ Rh× w× 3, 其中, h、w分别表示图像的高度和宽度.设起点S=(xs, ys), 终点E=(xe, ye), 则路径τ ={p1, p2, …, pn}, 其中, pi∈ N2 表示路径上的第 i 个位置点, 并满足p1=S, pn=E.自然语言约束指令Q用于描述当前任务中的通行规则, 包括可通行土地类别及不同类别的优先级偏好.土地类别集合C={c1, c2, …, cL}, 其中, ci表示第i类土地覆盖类别, L表示土地类别总数.根据Q, 可进一步解析得到可通行向量Vtrav∈ {0, 1}L.在此基础上, 得到偏好向量Vpref∈ {0, 1, …, k}L.其中:Vtrav(i)=1表示第i类地表可通行, Vtrav(i)=0表示该类别不可通行; Vpref(i)表示地表在当前任务中的优先级, 数值越大表示优先级越高.
设M(p)表示位置p处的土地类别标记, 则任意位置p的代价
W(p)=
其中, f(· )表示将类别优先级映射为通行代价的函数, 并满足优先级越高、代价越低.在此基础上, 路径规划问题可形式化为如下优化问题:
τ * =arg
上式表示在满足起点和终点约束的前提下, 寻找一条累计代价最小的路径.最优路径不仅需要避开不可通行区域, 还需优先经过更符合任务需求的土地类型, 以此评估模型感知和约束求解的能力.由此, 路径规划可视为融合语义约束解析、环境建模与路径搜索的联合优化问题.
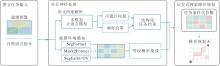
本文提出面向遥感路径规划的神经符号协同路径规划器(NSCRP), 由语义约束解析、遥感环境感知和启发式搜索路径规划3个阶段组成, 具体框架如图1所示.
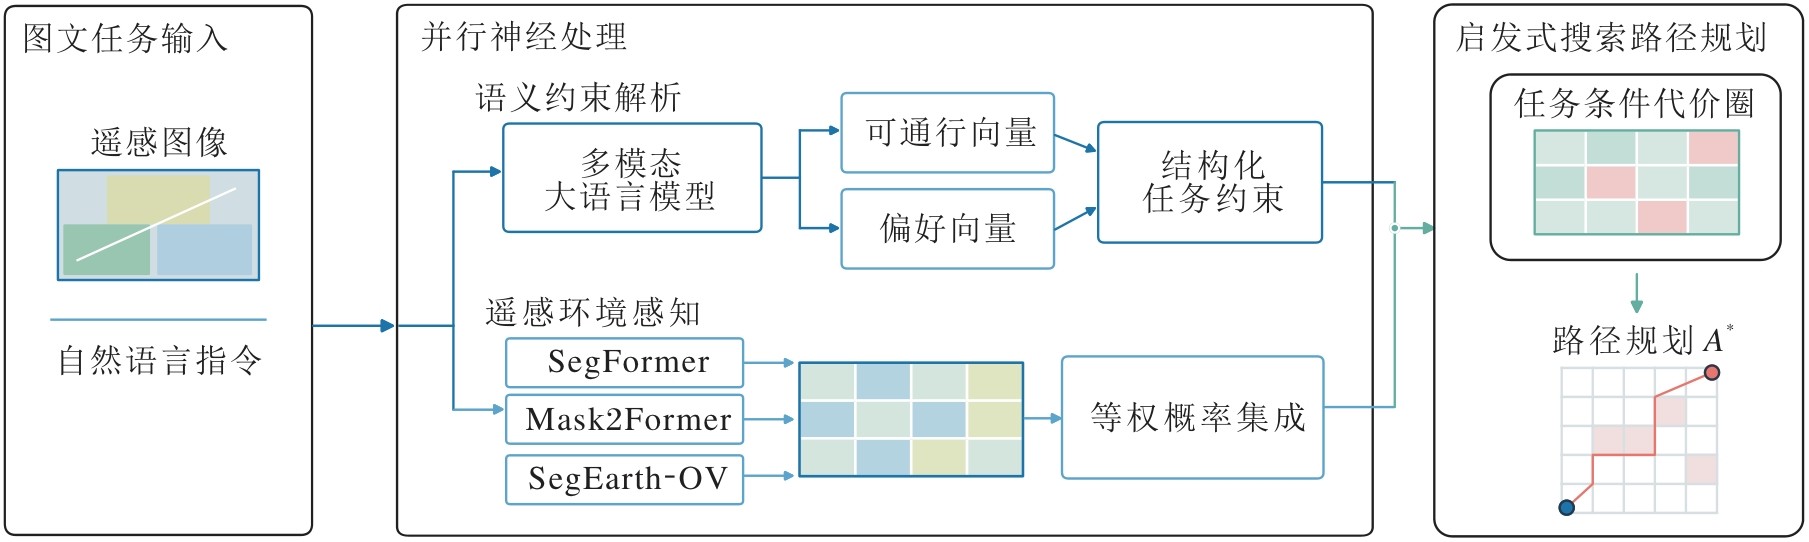 | 图1 NSCRP框架图Fig.1 Architecture of NSCRP |
从整体上看, NSCRP可理解为一种任务条件下的代入式结构化决策过程.多模态大模型与分割模型分别估计任务约束和环境状态, 代价映射将上述估计转化为任务相关的像素级规划代价, A* 在预测代价图上完成确定性搜索.因此, 任务条件代价图构成神经感知与符号优化之间的显式接口, 各模块围绕累计规划代价最小这一目标发挥不同作用.
需要说明的是, 本文的多模态大模型与分割模型并非前后依赖的串行关系, 而是分别从任务语义和环境状态两个方面进行并行建模, 且其输出在任务条件代价图中汇合.多模态大模型负责将开放指令转化为可计算约束, 分割模型负责提供像素级地表表示, A* 再依据融合后的代价图完成显式搜索.这种能力分工将任一单一模块难以独立完成的复合任务转化为可计算、可解释和可执行的结构化规划问题.
路径规划问题的一个关键难点在于:自然语言约束通常以开放形式给出, 如智能体的类型、允许通行的地表类别、优先通行区域及避障偏好等, 这类信息若直接保留为文本形式, 难以被后续搜索算法直接利用.因此, 本文首先利用多模态大模型对任务描述Q和遥感图像I进行语义约束解析, 将其转化为结构化的符号表示:
ftext∶ Q, I→ (Vtrav, Vpref),
其中, Vtrav∈ {0, 1}L, Vpref∈ {0, 1, …, K}L.
上述表示使得原本以自然语言表达的约束条件被映射为有限维离散向量, 便于与后续视觉感知对齐.
MLLM实际上需要在更高层语义上完成规则映射.例如:对于步行任务, 水体和建筑属于不可通行类别; 对于船只任务, 可通行类别会发生显著变化.
语义约束解析阶段的本质是将智能体能力、任务目标和地表类别之间的关系显式编码为后续可调用的符号约束.
值得注意的是, NSCRP并不要求MLLM输出最终路径, 而是仅要求其给出结构化约束表示.这样设计有如下两方面考虑:1)多模态大模型在开放式语言理解和语义归纳方面具有优势, 适合承担高层任务解析工作; 2)连续路径生成本质上是一个带约束的空间优化问题, 若完全依赖端到端生成, 往往难以保证结果的稳健性和可解释性.
获得结构化语义约束后, 需要从遥感图像中提取可供规划使用的符号验证环境.本文采用分割模型集成对环境进行细粒度环境感知, 构建实例分割图.
设第m个分割模型记为f
Z(m)=f
Z(m)(p, l)表示第m个模型在像素位置p处对第l类土地覆盖类别cl∈ C的概率取值.本文对模型的输出施加softmax变换, 得到第m个分割模型在像素位置p处判定为类别cl的预测概率:
P(m)(p, l)=
由于不同分割模型在网络结构、特征表达方式和类别敏感性方面存在差异, 因此它们的输出往往具有较强的互补性.为了降低单一模型误差对后续规划的影响, 本文不直接对各模型的离散预测标签进行投票, 而是在概率层面对多个模型的softmax输出进行加权概率平均.具体而言, 设第m个模型对应的融合权重为am, 则像素位置p处对类别cl的融合概率为:
P(p, l)=
上式中各融合权重均为非负数且总和为1.本文集成3个分割模型, 并将3个权重均设为1/3.在此基础上, 可通过最大后验概率得到土地类型, 即位置p最终土地类别标记:
M(p)=arg
从作用上看, M(p)给出图像空间中每个位置对应的语义类别, 从而建立从像素空间到地表语义空间的映射.采用集成而非单一分割模型的主要原因在于:复杂遥感场景中的地表类别往往具有边界模糊、尺度变化显著、局部纹理相似及类间分布不均衡等特点, 单一模型容易在局部区域产生误分割或漏分割.若直接基于单一模型结果构造代价图, 这类误差会被进一步传递并放大, 从而影响最终路径质量.集成策略可有效提升构造代价图的稳健性.
在NSCRP中, 路径搜索关键思想是将语义约束解析阶段得到的符号表示与遥感环境感知阶段得到的像素级语义地图进行融合, 构造可供经典搜索算法求解的显式代价表示, 后续路径规划则在该符号空间内完成.首先, 若位置p对应的地表类别不可通行, 即
Vtrav(M(p))=0,
其代价赋为无穷大.若该位置可通行, 其代价由偏好值决定.代价函数采用如下形式:
max(Vpref)-Vpref(M(p))+1.
根据上式, 分割模型集成通过最大后验决策得到像素级土地类别图, 可通行向量和偏好向量决定不同类别的通行状态与偏好代价, 二者通过类别代价映射形成任务条件代价图.对于同一土地类别图, 不同任务约束会形成不同的代价图和规划路径.因此, 符号约束作用于代价建模与路径决策层, 而不是直接反向更新分割网络参数.
在满足通行性的基础上, 搜索过程优先经过更符合任务目标的地表类别.从神经符号协同的角度看, Vtrav和Vpref是由多模态大模型从自然语言中抽取得到的符号约束, M(p)是由分割模型集成得到的神经感知结果, 而W(p)是二者融合后的符号化中间表示.代价图将原本分散在语言模态和视觉模态中的信息统一到可计算的像素代价空间内, 从而为后续经典规划算法提供明确的优化目标.在构造代价图后, 本文在像素空间上采用A* 进行路径求解, 总代价函数为:
f(p)=g(p)+h(p),
其中, g(p)表示从起点S到当前位置p的累计实际代价, h(p)表示从当前位置p到终点E的启发式估计代价.本文启发函数的计算采用欧氏距离, 即
h(p)=‖ p-E‖ 2.
g(p)反映路径已消耗的真实代价, 而h(p)用于估计未来到达终点的剩余代价.欧氏距离不依赖具体地表类别, 仅依赖当前位置与终点之间的几何距离.由于本文对所有可通行位置均赋予正代价, 即W(p)≥ 0, 因此欧氏距离不会高估从当前位置到终点的实际代价, 满足启发函数的可采纳性要求.由于欧氏距离满足三角不等式, 而相邻像素之间的移动代价始终为非负数值, 因此该启发函数也满足一致性要求.基于上述论述, A* 能在当前预测代价图下求得累计代价最小的路径τ * .需要说明的是, 这里的最优性仅针对当前预测代价图, 如果分割结果存在误差, 预测代价图可能与真实环境不完全一致, 因此不代表真实环境中的全局最优.
本文将路径生成问题显式拆解为语义约束解析、遥感环境感知和启发式搜索路径规划3个阶段.这样做的优势在于多模态大模型负责高层语义理解, 避免直接承担复杂的长程空间优化, 充分发挥神经网络的语义理解能力; 专用分割模型负责细粒度环境建模, 提升地表识别的可靠性, 发挥专有模型的领域专家能力; 启发式搜索算法在预测代价图上求解累计代价最小的路径, 保证规划结果的可解释性与稳定性.
本文在NeSy-Route[22]基准上验证NSCRP的有效性.在给定遥感图像、自然语言约束、起点和终点条件下, 生成满足约束的路径点序列.
NSCRP由3个部分组成.语义约束解析阶段采用Qwen3-VL-235B-A22B[25]解析自然语言约束, 生成可通行向量和偏好向量.遥感环境感知阶段采用未在OpenEarthMap数据集[15]上训练过的Mask2-Former[30]、SegEarth-OV[31]、SegFormer[32]语义分割模型对遥感图像进行地表语义分割, 体现数据神经符号协同框架的有效性, 并以相同权重对3个模型的概率输出进行平均, 构建统一的土地类别图.依据语义约束和分割结果构造代价图, 并采用A* 生成最终路径.
实验将NSCRP与当前主流多模态大模型进行对比.对比方法采用与NeSy-Route基准一致的任务输入形式, 即同时输入遥感图像、自然语言约束、起点和终点, 并要求模型输出路径点序列.所有方法在统一数据划分下对比.NeSy-Route路径规划基准共包含10 821个样本, 并按照场景复杂度划分如下:easy场景6 492个样本、medium场景2 705个样本、hard场景1 624个样本.
实验服务器配备4张NVIDIA A800 80 GB图形处理器(Graphics Processing Unit, GPU).为了分析计算开销, 分别统计语义约束解析阶段和启发式搜索路径规划阶段的运行时间.Qwen3-VL-235B-A22B语义约束解析阶段的平均输出长度约为361个token, 结合该模型的公开推理基准, 单样本语义约束解析耗时约为10~25 s, 典型样本耗时约为15 s.在启发式搜索路径规划阶段, 10 821个测试样本上的A* 平均耗时为0.448 s, 中位数为0.436 s, 第95百分位数(95th percentile, P95)耗时为0.828 s.结果表明, 当前流程的主要时间开销来自多模态大模型的语义约束解析阶段, 而代价图上的启发式搜索路径规划阶段耗时相对较低.
本文采用NeSy-Route的4项评估指标量化评估路径质量, 包括约束遵循率(Adherence Rate, AR)、约束违反率(Violation Ratio, VR)、代价比率(Cost Ratio, CR)和倒角距离(Chamfer Distance, CD).
AR指标用于衡量模型生成的路径是否整体满足可通行约束, 即预测路径能否始终在可通行区域内, 数值越高表示路径的约束遵循能力越强.VR指标统计违反约束的路径落入不可通行区域比例, 数值越低表示路径违反约束的程度越小.CR指标用于评估预测路径相对于参考最优路径的累计代价比值, 数值越低说明生成路径在代价意义下越接近最优解.CD指标衡量预测路径与参考最优路径之间的几何距离差异, 数值越低表示预测路径在空间形状上越接近参考轨迹.总之, AR指标反映路径的约束满足能力, VR指标刻画路径的约束违反程度, CR指标衡量路径的代价最优性, CD指标反映预测路径与真实轨迹之间的几何一致性.
在NeSy-Route基准任务上, 选择如下多种主流多模态大语言模型进行对比:Qwen3-VL-8B[25]、Qwen3-VL-30B-A3B[25]、Qwen3-VL-32B[25]、LLaVA-OneVision-1.5[26]、InternVL3.5-8B[27]、Qwen3.5-27B[28], 相应指标值如表1所示.表中黑体数字表示最优值, 斜体数字表示次优值.
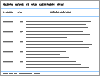 | 表1 各模型在3个场景中的指标值 Table 1 Metric values of different models under 3 scenarios |
从整体平均结果来看, NSCRP在4项指标上均取得最优或次优的综合表现.具体而言, NSCRP在AR指标上显著高于所有对比模型, 同时在平均VR、CR、CD指标上均保持或接近最优水平.该现象表明NSCRP在约束满足能力、路径代价最优性及几何一致性方面具有较强的整体优势, 说明神经符号协同范式能有效解决遥感场景中的路径规划问题.
从基于不同难度的结果来看, 随着任务难度递进, 所有模型的性能均出现下降, 但NSCRP在3个难度等级上始终保持领先, 尤其在Medium、Hard场景中的优势更明显.相比之下, 现有多模态大模型在简单场景中尚能取得一定效果, 但在复杂地表及约束条件下, 指标值明显下降.这一现象说明, 现有端到端多模态大模型在复杂场景中难以同时保持稳定的约束理解能力和路径生成能力, 而NSCRP由于引入显式环境建模和符号搜索机制, 在高难度任务中表现出更好的鲁棒性与泛化能力.
从路径输出形式来看, 现有多模态大模型并不能直接生成稠密、连续的轨迹.路径规划任务要求模型在较长空间范围内保持坐标序列的一致性, 而MLLM在长上下文建模方面仍存在明显局限, 因此其输出通常为较稀疏的路径点.与之不同, NSCRP是在像素级代价图上直接进行显式搜索, 可生成稠密、连续的完整轨迹.这一现象说明, 当前MLLM在路径规划任务上仍主要停留在稀疏点级别的粗粒度生成阶段, 而NSCRP能输出更具可执行性的连续路径, 因此在规划完整性和空间一致性上更具优势.
需要特别指出的是, CR和CD的评测方式实际上对MLLM方法更有利.对于满足约束的MLLM输出, 其原始结果通常只是稀疏路径点, 因此在计算CR、CD指标时, 需要先在真实标注的代价图上利用A* 将这些稀疏点重新连接为稠密轨迹, 再在真实代价图中计算路径代价和几何距离.相比之下, NSCRP的完整路径是在自身生成的代价图上直接搜索得到的, 然后才统一在真实代价图中进行评估.这说明对于CR、CD指标, MLLM实际是借助真实环境信息完成后进行处理, 而NSCRP是在更严格的设定下完成路径生成与评估.即便如此, NSCRP在CR、CD指标上仍优于现有MLLM, 这进一步表明NSCRP的有效性及整体规划框架的优越性.
部分多模态大模型在简单场景中的单一指标上取得较优结果, 如某些模型在CD指标上与NSCRP接近.当场景复杂度提升后, 这种局部优势迅速减弱, 而NSCRP在各项指标上仍保持较稳健的领先表现.这说明端到端MLLM在简单场景中可能依靠较强的视觉语言对齐能力生成看似合理的路径点, 但其结果缺乏稳定的环境建模与全局搜索支撑, 因此难以在更复杂任务中持续保持性能优势.
总之, NSCRP在满足通行约束的同时可兼顾路径质量, 并在预测代价图上获得累计代价最小的路径, 体现神经符号协同框架在路径规划中的综合优势.
为了进一步分析各组成模块对整体性能的影响, 将Qwen3-VL-235B-A22B作为语义约束解析模型, 对比仅使用MLLM(Qwen3-VL-235B-A22B)、MLLM分别结合单个分割模型(Mask2Former[30]、SegEarth-OV[31]、SegFormer[32])及NSCRP完整集成框架的指标值, 结果如表2所示.表中黑体数字表示最优值, 斜体数字表示次优值.
| 表2 各变体消融实验结果 Table 2 Ablation experiment results of different variants |
首先, 从仅使用MLLM与“ MLLM+单个分割模型” 的对比可看出, AR指标显著提升, VR、CR指标大幅下降.这表明, 仅依赖MLLM难以完成稳定的环境建模与路径规划, 而显式引入地表语义感知后, 能获得更可靠的语义表示, 提升路径质量.
其次, 从不同单个分割模型与MLLM的组合及NSCRP的结果可看出, SegEarth-OV、SegFormer和Mask2Former在不同难度和不同指标上各有优势, 但NSCRP整体上始终表现最优.这说明不同分割模型在复杂遥感场景中具有互补性, 集成策略能有效缓解单模型误分割带来的不稳定性, 并进一步提升后续代价图构建和路径搜索的可靠性.
总之, 消融实验验证NSCRP中的两个关键设计:1)遥感环境感知阶段是路径规划不可或缺的组成部分; 2)分割模型集成能进一步增强环境表示的鲁棒性, 带来更优的规划性能.
表2还反映NSCRP中的能力互补与误差传递关系:地表类别估计会影响像素级代价图, 代价图质量进一步影响路径搜索结果.相比单独使用MLLM, NSCRP将平均AR值由27.80升至47.21, VR值由37.30降至26.71, CR值由8.70降至1.20.这一结果并非简单来自模块数量增加, 而在于补足单一模块的能力边界:MLLM难以同时承担精细环境建模和稠密路径搜索, 分割模型不能理解开放任务约束, 经典搜索也不能自行生成任务相关代价.三类能力通过任务条件代价图组合后, 形成从开放指令和遥感观测到可执行路径的完整求解链路.
本文针对遥感场景中面向任务的路径规划问题, 提出神经符号协同路径规划器(NSCRP).NSCRP通过多模态大模型解析任务描述, 获得结构化可通行规则与偏好表示, 同时集成多个语义分割模型的结果构建地表语义图.在此基础上将语义约束与环境感知结果统一映射为像素级代价图, 从而在预测代价图上生成累计代价最小的路径.相比依赖高精地图、道路网络、车载传感器等人工标注数据或基于知识规则的既有方法, NSCRP能更好地适应具有开放式语义约束的复杂遥感任务场景.
在NeSy-Route基准上的实验表明, NSCRP在约束满足能力、路径质量和整体规划性能方面均较优, 由此验证神经符号协同框架在遥感路径规划任务中的有效性.本文研究表明, 遥感路径规划不仅依赖环境感知能力, 也依赖对任务语义约束的建模与融合能力.本文通过将语义解析、环境感知与符号规划统一至同一框架中, 为遥感智能决策问题提供具有稳健性和可解释性的解决思路.未来可进一步面向更复杂的场景约束、更大规模的数据条件及更强的模型协同机制展开研究.例如:开展多轮协同研究时可结合外部环境验证或人机反馈, 将路径执行中的结构化失败信息返回MLLM, 用于重新解析任务约束并重建代价图.
本文责任编委 吴飞
Recommended by Associate Editor WU Fei
| [1] |
|
| [2] |
|
| [3] |
|
| [4] |
|
| [5] |
|
| [6] |
|
| [7] |
|
| [8] |
|
| [9] |
|
| [10] |
|
| [11] |
|
| [12] |
|
| [13] |
|
| [14] |
|
| [15] |
|
| [16] |
|
| [17] |
|
| [18] |
|
| [19] |
|
| [20] |
|
| [21] |
|
| [22] |
|
| [23] |
|
| [24] |
|
| [25] |
|
| [26] |
|
| [27] |
|
| [28] |
|
| [29] |
|
| [30] |
|
| [31] |
|
| [32] |
|
| [33] |
|
| [34] |
|
| [35] |
|
| [36] |
|