

基于原型图对比学习的恶意软件检测
[韩彤1  , 王田丰
1 , 徐成成2 , 郭世泽1, 3 , 潘志松1 ]
, 王田丰, 徐成成, 郭世泽, 潘志松]
|
|


作者简介:
韩 彤,博士研究生,主要研究方向为恶意软件检测、数据挖掘.E-mail:dolphin_han@aeu.edu.cn.
王田丰,博士,讲师,主要研究方向为数据挖掘、机器学习.E⁃mail:tianfengw97@163.com.
徐成成,博士研究生,主要方向为数据挖掘、自监督学习.E⁃mail:ccxu_ccxu@163.com.
潘志松,博士,教授,主要研究方向为机器学习、人工智能.E⁃mail:panzhisong@aeu.edu.cn.
图对比学习方法能有效捕捉行为图中复杂的结构依赖关系,现已成为恶意软件检测领域的重要工具.然而,现有方法在训练中无差别对待所有样本或过度侧重于难样本,导致模型训练震荡、收敛缓慢.为了解决此问题,文中提出基于原型图对比学习的恶意软件检测方法,将课程学习从单样本选择扩展至样本对层级,联合锚点与负样本的典型性,定义软件语义的对比难度.设计双阈值动态调度器,实现从典型到边缘的渐进式对比训练.同时,引入历史导向的困难锚点强化机制,追踪并重加权学习不充分的困难锚点,增强对难样本的表征能力.在4个公开的恶意软件数据集上的实验表明,文中方法可显著提升训练稳定性与收敛速度.
About Author:
HAN Tong, Ph.D. candidate. Her research interests include malware detection and data mining.
WANG Tianfeng, Ph.D., lecturer. His research interests include data mining and machine learning.
XU Chengcheng, Ph.D. candidate. His research interests include data mining and self-supervised learning.
PAN Zhisong, Ph.D., professor. His research interests include machine learning and artificial intelligence.
Graph contrastive learning can effectively capture the complex structural dependencies in behavior graphs, and now it is an important tool for malware detection. However, existing methods treat all samples indiscriminately or overemphasize hard samples during training, leading to training oscillation and slow convergence. To address this issue, a prototype-based graph contrastive learning method for malware detection is proposed. Curriculum learning is extended from the instance-selection level to the sample-pair level, and the contrastive difficulty of software semantics is defined by jointly considering the typicality of anchors and negative samples. A dual-threshold dynamic scheduler is designed to enable progressive contrastive training from typical cases to edge cases. Furthermore, a history-guided anchor enhancement mechanism that tracks and reweights insufficiently learned hard anchors is introduced, thereby enhancing the representation capability for hard samples. Experiments on four public malware datasets demonstrate that the proposed method significantly improves training stability and convergence speed.
恶意软件的指数级增长与持续演进, 使其成为网络空间最严峻的威胁之一.为了应对层出不穷的新型变种, 研究者致力于挖掘其中本质、一般性的结构性表征.基于图神经网络(Graph Neural Network, GNN)的分析和检测方法能自然刻画代码执行流程与模块间交互模式, 在恶意软件检测领域具有内在优势[1].有监督GNN方法[2, 3]具有强标签依赖性, 在恶意标签稀疏场景中性能受限.相比之下, 图对比学习方法(Graph Contrastive Learning, GCL)[4]不依赖标签信息, 而是通过构建正负样本对, 将语义相似的恶意软件图映射至嵌入空间中的相近位置, 在恶意软件检测领域展现出巨大潜力.
然而, 现有GCL在恶意软件检测中的训练范式存在如下显著局限.1)样本无差别训练问题.当前方法默认所有训练样本对模型学习具有同等贡献, 或单纯侧重于难样本挖掘, 忽略恶意软件家族内部天然的谱系结构— — 从结构清晰的典型恶意软件到行为模式分散或经加壳、代码注入等对抗手段处理后的边缘恶意软件[5].Wu等[6]提出IFDroid, 虽通过同家族正样本对提升Android恶意软件家族分类的鲁棒性, 但训练过程仍将批次内所有样本无差别混合对比.Liu等[7]提出A2-CLM(Self-Supervised Graph Contrastive Learning Few-Shot Malware Detec- tion Framework with Adversarial Heterogeneous Graph Augmentation), 针对少样本场景, 引入对抗增强技术, 构造正样本, 将批次内其它实例均作为负样本, 但未考虑样本在家族谱系中的位置.上述研究中样本无差异化的训练策略使方法在初始阶段便受到大量复杂、模糊样本的干扰, 严重影响其收敛性和检测精度.2)对比关系难度定义缺失问题.近期, 一些研究者尝试使用课程学习[8]调整模型训练顺序.Sho- kouhinejad等[9]在训练初期仅让模型学习结构简单的子图.Li等[10]提出MalTutor, 基于不确定性估计优先训练高置信度样本.然而, 上述方法依赖监督学习, 难度度量依据往往偏离模型训练的实际优化轨迹.在自监督GCL领域, 现有课程学习方法的难度定义主体仍局限于锚点[11]、负样本单侧[12]或增强视图[13], 未能充分建模对比学习中锚点和负样本联合构成的语义区分难度.这一问题在恶意软件检测中尤为突出, 因为包括混淆变种在内的难样本往往在特征空间中与大量负样本相似, 单侧难度定义难以准确刻画其判别难度.
人类分析师在鉴别未知恶意软件时, 一般先由结构清晰、未混淆的原始样本中提炼核心恶意行为链, 形成该家族的认知原型, 再以此为基础鉴别高度混淆的变种[14].这一人工鉴定范式可为对比训练提供一种先易后难的学习启发.
在图像领域, Lin等[15]已提出原型课程学习, 利用样本到原型的距离度量图像自身难度.由于GCL的核心优化对象是样本对之间的语义对比关系, 而非单个样本的表征难度, 因此原型课程学习无法直接迁移至GCL场景.如何将原型度量的样本典型性有效转化为对比对层级的难度定义, 并将课程学习从“ 样本选择” 提升为“ 对比关系选择” , 目前尚无相关研究.在对比学习的课程训练中, 单纯采用由易到难的渐进策略可能造成部分锚点无法在训练窗口内获得有效的判别信号.以高度混淆的恶意软件变种为例, 这类锚点本身结构复杂, 在特征空间中与大量负样本较相似[16], 在多轮训练后损失下降仍十分有限.由于困难锚点在简单阶段未被充分掌握, 进入困难阶段后又被持续误分, 形成难以修正的判别盲区.
基于上述缺陷, 本文提出基于原型图对比学习的恶意软件检测方法(Prototype-Based Graph Con-trastive Learning for Malware Detection, PGCL-MD), 将原型驱动的课程学习范式首次融入恶意软件自监督图对比学习任务中, 解决现有基于GCL的恶意软件检测方法对样本无差别训练的问题.通过样本到类别原型的距离度量其典型性, 构建从典型样本到边缘样本的渐进式学习路径.设计课程样本对采样器, 根据样本的典型性, 定义锚点-负样本对的难度, 提出双阈值动态调度器, 控制样本对由易到难进行训练.同时, 为了增强课程学习的自适应性, 引入历史导向的困难锚点强化机制, 跟踪对比损失, 标记困难锚点, 并在后续训练对其重加权, 有效提升对易混淆样本的判别能力.在公开的恶意软件图数据集上的实验表明, PGCL-MD能显著加速训练收敛, 在GCL中性能较优.
早期恶意软件检测工作大多采用静态分析或动态分析提取特征, 再结合传统机器学习算法进行分类[17].这类方法严重依赖特征工程, 鲁棒性较差.深度学习方法通常依赖恶意软件的单一属性或其序列表示[18], 不能完全反映恶意活动之间的关联.基于图的方法对恶意软件的复杂行为进行建模, 显著提升对恶意软件的检测性能[19, 20].
近期, 图对比学习方法已成为恶意软件检测的重要工具之一.Wu等[6]提出IFDroid, 利用对比学习缓解代码混淆带来的特征差异.Bu等[21]采用三元组损失优化控制流图的表征, 显著提升在少样本场景中的分类性能.Liu等[22]提出FewM-HGCL(Self-Supervised Few-Shot Malware Variants Detection Frame-work Based on Heterogeneous Graph Contrastive Lear-ning), 将对比学习用于异构图, 提高对新型恶意变种的检测能力.Gao等[23]利用节点掩码、边扰动等增强操作生成多视图CFG(Control-Flow Graph), 实现无标签条件下的恶意软件分类.Qian等[24]提出CLA-HG(Adversarial Contrastive Learning on Heteroge-neous Graph), 结合图对比学习与对抗训练, 提升对GitHub恶意代码仓库的检测能力.Liu等[7]提出A2-CLM, 设计多种对抗攻击方法, 生成更贴近真实威胁的对比样本, 增强模型的泛化性和鲁棒性.
上述图对比学习方法虽在恶意软件检测中取得良好效果, 但其训练过程默认所有样本对模型具有同等贡献, 或仅通过增强策略被动应对样本差异, 未能主动利用恶意软件家族内部的谱系结构.
课程学习根据样本的难易程度调整训练顺序, 核心难点在于设计样本难度度量策略和调度策略[25].难度度量主要包含图像目标数量、文本长度等静态度量指标和模型实时损失等动态指标[26].调度器在训练进度与数据难度分布之间进行映射, 常见策略包含预定义调度[8]和动态调度[27].
近年来, 已有研究者关注到课程学习与对比学习的结合运用.Tong等[28]提出DiGCL(Directed Graph Contrastive Learning), 在频谱空间, 通过调节拉普拉斯扰动强度生成难度递增的视图, 有效保留更多的有向图的原始结构特征.Chu等[29]提出CuCo(Graph Representation with Curriculum Contrastive Learning), 计算负样本与锚点图的相似度, 采样不同难度的负样本.Zeng等[30]提出CurGL(Clustering-Guided Curriculum Graph Contrastive Learning), 通过聚类熵量化数据不确定性, 并以此定义样本的学习难度.Zhao等[31]提出SpaICL, 根据空间邻接关系的强弱设定不同阶段对比任务的难度.上述方法通常采用线性函数、指数函数、阶梯函数、多项式函数等单调递增函数实现训练过程中的样本调度, 但均未能建模锚点与负样本联合构成的语义区分难度.
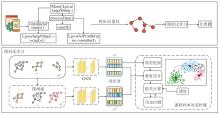
本文提出基于原型图对比学习的恶意软件检测方法(PGCL-MD), 整体框架如图1所示.
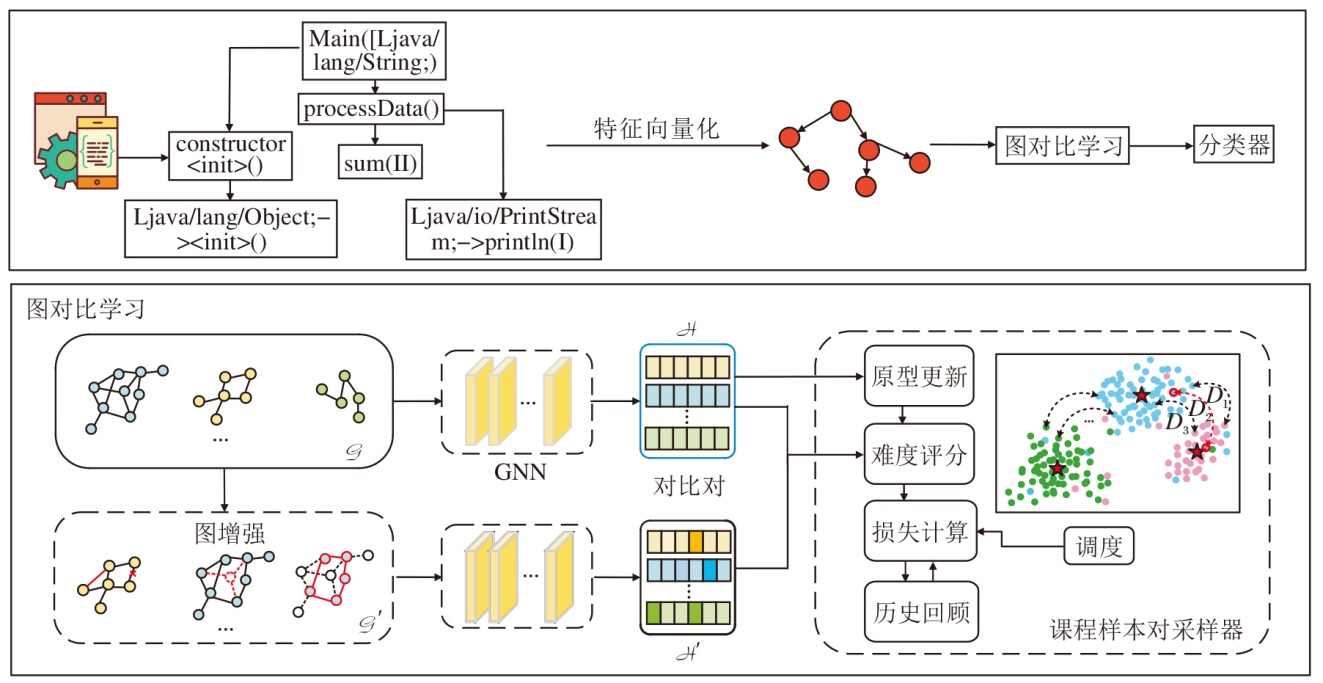 | 图1 PGCL-MD整体架构图Fig.1 Overall architecture of PGCL-MD |
软件样本表示为图数据集合$ \left\{\mathfrak{g}_{1}, \mathfrak{g}_{2}, \cdots, \mathfrak{g}_{M}\right\}$, 其中单个软件图$ g=(\nu, \varepsilon)$, $ \gamma=\left\{v_{1}, v_{2}, \cdots, v_{N}\right\}$表示节点集合, N表示节点数, $ \varepsilon \subseteq \nu \times \nu$表示边集合.软件图中的网络拓扑表示软件中的调用关系, 一般通过提取文件的CFG、FCG(Function Call Graph)等方式获取, 表示为A={0, 1}N× N, 其中, Aij=1表示节点i和节点j之间有边相连, Aij=0表示无边相连.基本块、基础函数或基础API(Application Programming Interface)经过预训练的文本编码器转化为节点属性X∈ RN× F, 其中, xi表示节点i的属性, F表示节点特征的维度.通过图对比学习模块优化图表示后, 再将图表示接入全连接分类器, 鉴别软件是否具有恶意.
图对比学习模块包含2个结构相同、参数独立的分支网络.将原始图集合$ \left\{\mathfrak{g}_{1}, \mathfrak{g}_{2}, \cdots, \mathfrak{g}_{M}\right\}$和增强图集合$ \left\{\mathscr{G}_{1}^{\prime}, \mathscr{G}_{2}^{\prime}, \cdots, \mathscr{G}_{M}^{\prime}\right\}$分别输入2个分支网络, 得到2组嵌入表示$ A=\left\{\boldsymbol{h}_{1}, \boldsymbol{h}_{2}, \cdots, \boldsymbol{h}_{M}\right\}$和$ d^{\prime}=\left\{\boldsymbol{h}_{1}^{\prime}\right.$, $ \left.\boldsymbol{h}_{2}^{\prime}, \cdots, \boldsymbol{h}_{M}^{\prime}\right\}$, 其中增强技术为随机选择节点丢弃、边扰动、属性掩码、子图采样增强, 编码器网络为GIN(Graph Isomorphism Network), 对于第u层, 节点v在第u层的特征向量为:
$\boldsymbol{h}_{v}^{(u)}=M L P^{(u)}\left(\left(1+\varphi^{(u)}\right) \boldsymbol{h}_{v}^{(u-1)}+\sum_{l \in N(v)} \boldsymbol{h}_{l}^{(u-1)}\right)$
其中,
为了获得整个图表示hi, GIN将各层节点表示求和再拼接, 即
$\boldsymbol{h}_{i}=\|_{u=0}^{U}\left(\sum_{v \in \nu} \boldsymbol{h}_{v}^{(u)}\right), $
其中, ‖ 表示向量拼接操作.
在对比学习过程中, 原始视图作为锚点视图, 增强视图作为正负样本视图.具体来说, 如果hi作为对比学习的锚点, 那么增强视图中的 h'i视为hi的正样本, 不同簇内的样本h'j视为hi的负样本.将H与H'构造的对比对输入课程样本对采样器中, 筛选当前训练状态下难度适宜的锚点-负样本对, 并计算对比损失.
课程样本对采样器包含3个关键模块.1)原型驱动的难度评估器, 获取表示各类别核心特征的原型向量, 为课程学习提供全局的难度度量依据.2)双阈值动态调度器, 依据当前训练进度与样本对难度分布自适应筛选参与训练的样本对.3)历史导向的困难锚点强化机制, 标记训练过程中难以充分学习的锚点, 并在后续训练阶段予以重点强化.
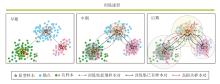
在整个训练进程中, 课程样本对采样器通过筛选样本对, 控制学习难度渐进的过程.整个过程如图2所示, 图中L1~L3和N1~N3分别表示锚点和负样本的典型性由高到低.随着训练阶段从早期向后期推进, 参与对比的锚点-负样本对组合依次从“ 典型-典型” 过渡至“ 典型-边缘/边缘-典型” , 最终进阶至“ 边缘-边缘” .这一递进式调度使得方法优先建立清晰的核心类别边界, 再逐步提升对易混淆变种的判别精度.
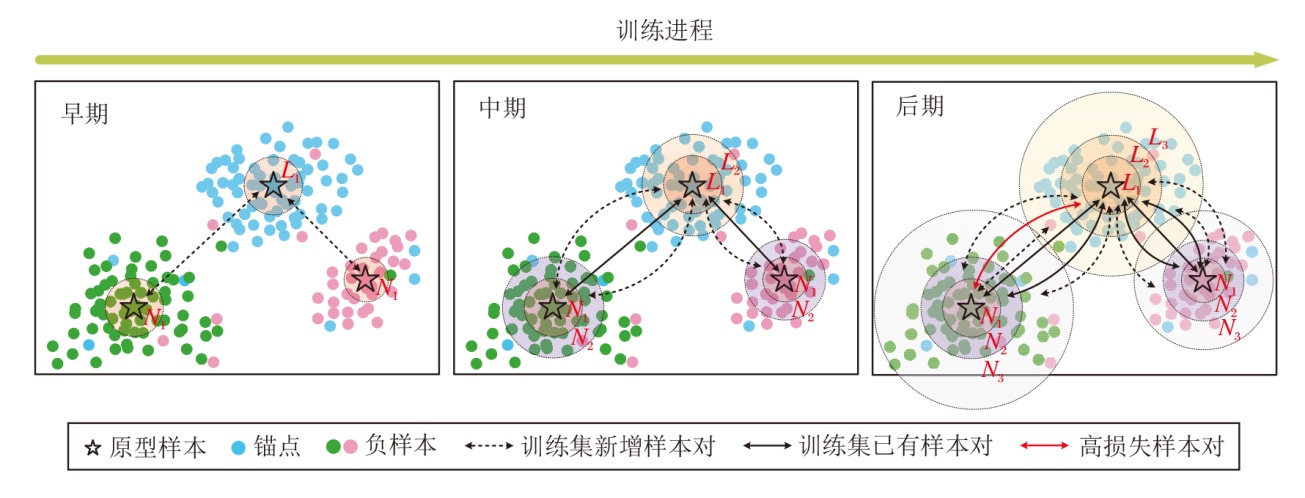 | 图2 课程样本对采样器训练难度递进图Fig.2 Progressive training difficulty of curriculum sample pair sampler |
原型样本[32]是指能代表某一类数据分布典型特征的样本或特征向量.假设训练过程中可获知类别数量, 但样本的真实标签未知, 本文采用无监督聚类的方式获取聚类中心, 并将聚类中心定义为该簇的原型.
具体地, 对当前所有的嵌入集合进行K-means聚类, 得到 K个簇{C1, C2, …, CK}.每簇对应的原型μ k定义为簇内所有样本嵌入的均值:
$\boldsymbol{\mu}_{k}=\frac{1}{\left|C^{k}\right|} \sum_{\boldsymbol{h}_{i} \in C^{k}} \boldsymbol{h}_{i} .$
每隔T0轮, 基于最新的嵌入重新执行聚类, 并更新原型$\left\{\boldsymbol{\mu}_{k}\right\}_{k=1}^{K}$.
在对比学习中, 样本对的难度存在显著差异.为了评估样本对的学习难度, 对锚点和负样本分别计算样本的典型性.基于软件的分布特性, 本文认为越靠近聚类原型(即类中心)的软件越具有该类别的典型特征, 与其它类别软件的差异也越明显.反之, 远离原型、位于类边界的样本则具有模糊性.因此, 对于簇k内的样本hi, 其典型性为:
$E\left(\boldsymbol{h}_{i}\right)=1-\tilde{d}\left(\boldsymbol{h}_{i}, \boldsymbol{\mu}_{k}\right), $
其中
$\bar{d}_{C^{k}}=\frac{1}{\left|C^{k}\right|} \sum_{\boldsymbol{h}_{j} \in C^{k}} d\left(\boldsymbol{h}_{j}, \boldsymbol{\mu}_{k}\right), $
得到相对偏离比:
$ r=\frac{d\left(\boldsymbol{h}_{i}, \boldsymbol{\mu}_{k}\right)}{\bar{d}_{C^{k}}} .$
为了将比值r映射至[0, 1]区间并抑制极端离群值的影响, 将r除以2后截断至[0, 1], 即
$\widetilde{d}\left(\boldsymbol{h}_{i}, \boldsymbol{\mu}_{k}\right)=\min \left(1, \frac{r}{2}\right) .$
通过归一化, 可使不同簇之间的样本难度具有可比性.
在构建锚点-负样本对时, 样本对的难度取决于锚点与负样本联合的典型性.典型锚点与典型负样本均具有较高的特征区分度, 由二者构成的样本对易于学习.若锚点和负样本均处于类别边界的边缘, 特征模糊, 二者构成的样本对难以学习.由此可见, 样本对的难度与锚点和负样本的典型性之和负相关.
基于上述分析, 给定锚点hi, 正样本h'i∈ Ck, 负样本h'j, 定义锚点-负样本对难度:
$D\left(\boldsymbol{h}_{i}, \boldsymbol{h}_{j}^{\prime}\right)=1-\frac{E\left(\boldsymbol{h}_{i}\right)+E\left(\boldsymbol{h}_{j}^{\prime}\right)}{2} .$
对于同一锚点, 有效负样本是指那些与正样本不属于同一簇的负样本.因此, 定义有效负样本掩码:
$M_{i j}=1_{\{i \neq j, c(i) \neq c(j)\}}, $
其中c(i)表示样本hi所属的簇标签.该难度评估机制可为后续的样本筛选、权重分配或课程学习策略提供量化依据.
双阈值动态调度器根据当前训练进度, 动态调整难度阈值, 控制参与训练的样本对分布.具体而言, 调度器维护一个难度阈值Bt, 其中t表示当前迭代轮次.在每轮训练中, 仅当样本对难度D≤ Bt时, 该样本对才会被纳入当前批次的训练.随着训练进行, 阈值Bt逐渐增大, 使模型可逐步学习难度更高的样本对.本文使用指数函数进行调度, 即
$B_{t}=B_{\min }+\left(B_{\max }-B_{\min }\right)\left(1-e^{-\beta_{T}^{t}}\right), $
其中, Bmin表示初始阈值, Bmax表示预设的最大阈值, β 控制增长速率, 常设为5.
不同于传统课程学习, 本文设置课程学习难度的下限Bmin与上限Bmax.若Bmin过小, 初期参与训练的样本对极少, 可能导致训练停滞; 若Bmin过大, 训练初期需要学习大量困难样本对, 可能导致训练不稳定或收敛至次优解.训练集上可能存在错误标注或特征异常值, 这些噪声可视作高难度样本.若强行拟合此类噪声, 将损害其泛化性能.通过设置难度上限Bmax可有效过滤此类噪声, 将资源集中于有价值的困难样本.
为了只对满足当前调度器阈值的锚点-负样本对进行训练, 将不符合当前难度要求的样本对权重设为接近0的值, 而将符合要求的样本对权重设为接近1的值.据此, 定义课程采样权重:
$ w=\frac{1}{1+e^{\alpha(D-B)}}, $
其中, B表示难度阈值, α 表示陡峭度, 越大越近似硬阈值, 越小则过渡越平滑.相比直接使用硬阈值, Sigmoid函数保留阈值附近样本对的梯度信息, 使模型能渐进适应难度边界, 避免训练震荡.在此基础上, 针对有效负样本执行课程采样权重归一化操作.
通过定期回顾锚点在训练间隔内的对比损失, 可识别那些当前判别困难但具备学习潜力的混淆变种样本.得益于双阈值动态调度器通过难度上限阈值对极端离群样本的预先过滤, 历史导向的困难锚点强化机制不再细化区分噪声样本, 只聚焦于高损失且具有学习潜力的锚点.具体地, 在每轮回顾周期Th结束时, 对于锚点i, 若其当前对比损失高于本批次损失均值, 且近5轮呈现持续下降趋势, 纳入困难锚点集合.双阈值动态调度器通过动态批次均值实现自适应筛选, 历史导向的困难锚点强化机制确保被强化锚点具备真实的收敛方向, 从而自动排除损失虽高但无下降趋势的无效样本.
在后续训练中, 将困难锚点的损失分量乘以权重因子λ 0, 增强该锚点对梯度更新的贡献.通过这种方式, 可对难以收敛的样本进行针对性的强化学习, 有效提升对比学习在复杂数据上的表征质量.
本文在NT-Xent损失的基础上引入课程样本对采样器.对于第i个输入图像, 基础损失定义如下:
$L_{i}^{\mathrm{base}}=-\ln \left(\frac{\exp \left(\frac{\operatorname{sim}\left(\boldsymbol{h}_{i}, \boldsymbol{h}_{i}^{\prime}\right)}{\tau}\right)}{\sum_{j \neq i} \exp \left(\frac{\operatorname{sim}\left(\boldsymbol{h}_{i}, \boldsymbol{h}_{j}^{\prime}\right)}{\tau}\right)}\right), $
其中, sim(· )表示余弦相似度, τ 表示温度系数.
综合考虑有效负样本约束、课程采样权重及困难锚点重加权, 本文的课程对比损失定义如下:
$L=-\frac{1}{|N|} \sum_{i \in A} \lambda_{i} \ln \left(\frac{\exp \left(\frac{\operatorname{sim}\left(\boldsymbol{h}_{i}, \boldsymbol{h}_{i}^{\prime}\right)}{\tau}\right)}{\sum_{j \neq i}\left(M_{i j} \bar{w}_{i j} \exp \left(\frac{\operatorname{sim}\left(\boldsymbol{h}_{i}, \boldsymbol{h}_{j}^{\prime}\right)}{\tau}\right)\right)}\right) .$
本节对比PGCL-MD与GraphCL(Graph Contras-tive Learning)的复杂度.GraphCL的时间复杂度O(N2)主要来源于批次内负样本对的计算.PGCL-MD在此基础上引入3个额外组件.原型驱动的难度评估器每T0轮执行1次聚类和难度评估, 聚类时间复杂度为O(N), 难度评估需计算每个样本到其原型的距离, 时间复杂度为O(N).双阈值动态调度器在损失计算中为每个负样本对增加常数级操作, 时间复杂度为O(N2).历史导向的困难锚点强化机制每Th轮对累积损失进行排序并筛选困难锚点, 时间复杂度为O(NlnN).因此, 本文方法的总时间复杂度仍为O(N2).在空间复杂度方面, PGCL-MD额外存储每个样本的典型性值、累积损失及记忆队列, 开销为O(N), 而GraphCL的空间复杂度主要为嵌入矩阵O(N)和相似度矩阵O(N2), 因此额外空间可忽略.
总之, PGCL-MD在保持与GraphCL相同渐进时间复杂度O(N2)的前提下, 通过周期性聚类和轻量级统计实现课程学习能力.空间复杂度仅小幅增加O(N), 具有良好的扩展性.
算法1 PGCL-MD
输入 图数据集G, 编码器fθ 、 f'θ , 原型更新间隔T0,
历史回顾间隔Th, 困难锚点权重λ 0
课程学习难度阈值Bmin、Bmax, 陡峭度α ,
温度τ
输出 训练好的编码器fθ
初始化编码器参数θ , 困难锚点集合$S \leftarrow \emptyset$
for t=1 to T do
$A, d^{\prime} \leftarrow f_{\theta}(g), f_{\theta}^{\prime}\left(g^{\prime}\right)$
if t mod T0== 0 then
$\left\{C^{1}, C^{2}, \cdots, C^{K}\right\} \leftarrow K \text {-means }(\not \subset, K)$
$M_{i j}=1_{\{i \neq j, c(i) \neq c(j)\}}$
计算每个样本典型性Ei和样本对典型性D(hi, h'j)
end if
if t mod Th==0 then
$\begin{array}{c} S \leftarrow S \cup\left\{i \mid L_{i}^{(t)}> \operatorname{mean}\left(L^{(t)}\right) \wedge\right. \\ \left.\prod_{r=1}^{5}\left(L^{(t-r+1)}< L_{i}^{(t-r)}\right)=1\right\} \end{array}$
end if
$B_{t} \leftarrow B_{\min }+\left(B_{\max }-B_{\min }\right)\left(1-e^{-5 \frac{t}{T}}\right)$
$w_{i, j} \leftarrow \frac{1}{1+e^{\alpha(D-B)}}$
$\lambda_{i, \boldsymbol{h}_{i} \in S} \leftarrow \lambda_{0}, \lambda_{i, \boldsymbol{h}_{i} \notin S} \leftarrow 1$
$L=-\frac{1}{|N|} .$
$\sum_{i \in A} \lambda_{i} \ln \left(\frac{\exp \left(\frac{\operatorname{sim}\left(\boldsymbol{h}_{i}, \boldsymbol{h}_{i}^{\prime}\right)}{\tau}\right)}{\sum_{j \neq i}\left(M_{i j} \bar{w}_{i j} \exp \left(\frac{\operatorname{sim}\left(\boldsymbol{h}_{i}, \boldsymbol{h}_{j}^{\prime}\right)}{\tau}\right)\right)}\right)$
$\theta \leftarrow \theta-\eta \nabla_{\theta} L$
end for
return fθ
本文在CIC SGG 2024_AE、CIC SGG 2024_FNE、Call-graph、Malnet-tiny这4个公开的恶意软件数据集上开展实验, 各数据集属性及规模分布如表1所示.CIC SGG 2024(https://www.unb.ca/cic/datasets/sgg-dataset-2024.html)数据集包含控制流图(子数据集命名为AE)和函数调用图(子数据集命名为FNE)两种构图方式, 由不同方式生成的图集合分别作为独立的数据集使用.在2个独立数据集上, 均选择DikeDataset作为良性样本集、pe-machine-learning-dataset作为恶意样本集.Call-graph数据集(https://github.com/quarkslab/dataset-call-graph-blogpost-material.git)和Malnet-tiny数据集(http://www.mal-net.org)分别对PE文件和安卓软件构建函数调用图.
 | 表1 实验数据集 Table 1 Experimental datasets |
本文选用分类准确率与F1分数作为主要评价指标.分类准确率能直观体现分类系统的整体有效性.F1分数则兼顾精确率与召回率, 其中, 精确率衡量模型预测为正例的样本中真实正例的比例, 召回率衡量真实正例中被模型正确检测的比例.
实验使用PyTorch框架, 在Xeon(R) Gold 6248R CPU@3.00 GHz, GPU NVIDIA A100-PCIE- 40 GB, Ubuntu 20.04操作系统上运行.
GNN采用GIN结构, 训练使用AdamW(Adap-tive Moment Estimation with Weight Decay)优化器, 对比训练轮次设为500, 最终的结果取10次运行结果的平均值.各数据集上具体参数设置如表2所示.K-means中的聚类数量设为数据集的真实类别数.
| 表2 各数据集上具体实验参数 Table 2 Detailed experimental parameters on each dataset |
为了验证PGCL-MD的优越性, 选取如下10种前沿基准方法进行对比.
1)监督学习方法GIN.
2)图对比学习方法:GraphCL、JOAO(Joint Aug-mentation Optimization)[33]、SimGRACE(Simple Frame-work for Graph Contrastive Learning)[34]、AutoGCL(Automated Graph Contrastive Learning)[35]、TopoGCL(Topological Graph Contrastive Learning)[36]、SA-GCL(Semantic-Aware Graph-Level Contrastive Learning)[37].
3)恶意软件检测方法:IFDroid[6]、A2-CLM[7]、文献[21]方法.
在图对比学习方法中, GraphCL设计节点丢弃、边扰动等图增强策略, 生成对比视图, 是图对比学习的奠基性工作.JOAO通过双层优化自动选取图增强策略.SimGRACE通过扰动编码器参数生成增强视图, 具有轻量高效的架构.AutoGCL引入可学习的视图生成器, 以端到端的方式生成对比样本.TopoGCL构造反映高阶全局结构的拓扑视图.SAGCL调整类中心特征与增强特征的距离, 实现可控的数据增强.在恶意软件检测方法中, IFDroid和文献[21]方法在构造对比对时使用真实标签.A2-CLM使用对抗扰动进行视图增强.对于恶意软件检测方法, 本文使用其对比学习增强策略及损失函数在图数据集上进行实验.
在分类性能评估阶段, 在GCL后接入一个两层感知机, 用于将软件的图级表示映射至类别标签.按 8∶ 1∶ 1 的比例随机划分训练集、验证集与测试集.为了保证公平性, 所有对比学习方法均使用相同的GIN.学习率和衰减率的设置采用网格搜索, 搜索空间分别为{0.001, 0.01, 0.1}和{1× 10⁻⁵, 5× 10⁻⁵, 1× 10⁻⁴, 5× 10⁻⁴, 1× 10⁻³, 5× 10⁻³}.
各方法在4个数据集上的指标值如表3所示, 表中黑体数字表示最优值.由表可见, PGCL-MD在GraphCL基础上引入原型驱动的难度评估器, 通过样本对渐进式训练显著提升判别能力.相比GraphCL, PGCL-MD在CIC SGG 2024_AE、CIC SGG 2024_PNE、Call-graph、Malnet-tiny数据集上分类准确率分别提升3.1%, 1.0%, 2.1%, 1.2%, F1值分别提高3.5%, 1.3%, 2.2, 1.5%, 并在所有自监督方法中达到最优, 性能可赶超监督对比方法.相比恶意软件检测方法, PGCL-MD在4个数据集上均优于A2-CLM, 在3个数据集上优于IFDroid和文献[21]方法, 仅在Malnet-tiny数据集上略低于IFDroid.
| 表3 各方法在4个数据集上的指标值 Table 3 Metric values of different methods on 4 datasets % |
GraphCL和JOAO通过随机增强策略生成增强视图, 可能丢失关键恶意节点, 影响性能.SimGR-ACE通过扰动GNN参数生成增强视图, 可能产生语义模糊的样本, 最终限制其有效性.A2-CLM的决策边界被局限于预定义的对抗扰动方向, 导致分类边界偏离数据的真实流形, 同时加剧训练震荡.SAGCL限制增强后的特征向量与类中心的距离, 防止语义偏移, 与PGCL-MD的作用层面不同.本文虽未特意设计恶意软件适用的视图增强方法, 但采取的渐进式训练策略可平滑优化轨迹并引导方法收敛至更平坦的极小值.TopoGCL和AutoGCL虽然引入拓扑特征或自适应增强, 但缺乏对学习样本难度的渐进式调度, 难以有效引导方法从语义中心向边界平稳过渡.
PGCL-MD包含双阈值动态调度器和历史导向的困难锚点强化机制这2个关键模块.为了分析两个模块的有效性并进一步验证课程学习策略设计的合理性, 分别从模块组合对比与不同课程学习方法对比两个角度进行消融实验.
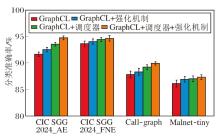
为了考察核心模块的有效性, 以GraphCL为基准, 逐步引入历史导向的困难锚点强化机制与双阈值动态调度器, 构造如下变体:GraphCL、GraphCL+强化机制、GraphCL+调度器、GraphCL+调度器+强化机制.在4个数据集上进行对比, 相应分类准确率如图3所示.由图可见, 各模块均对性能产生积极影响.强化机制的引入提升模型在各数据集上的基准准确率.调度器带来更显著的增益, 在CIC SGG 2024_AE数据集上将分类准确率由91.6%升至93.5%, 验证从典型样本到边缘样本的渐进式学习策略对判别性能提升的关键作用.GraphCL+调度器+强化机制在4个数据集上都取得最高的分类准确率, 且标准差均低于GraphCL, 表明PGCL-MD在提升检测精度的同时, 可显著增强训练过程的稳定性.
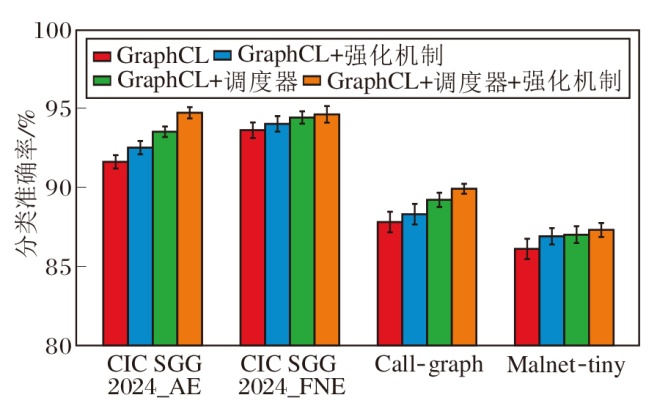 | 图3 不同模块组合下的分类准确率Fig.3 Classification accuracy under different module combinations |
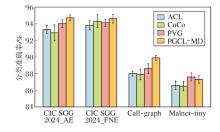
为了进一步定位PGCL-MD在课程学习方法中的优势, 以GraphCL为骨干, 设计3种课程学习变体:1)ACL.采用与PGCL-MD一致的典型性度量, 但是仅对锚点进行从典型到边缘的调度.2)PVG.渐进式增强视图难度, 逐步加大节点丢弃等扰动强度.3)CuCo[29].采用基于相似度的负样本课程采样策略.
各方法在4个数据集上的分类准确率如图4所示.
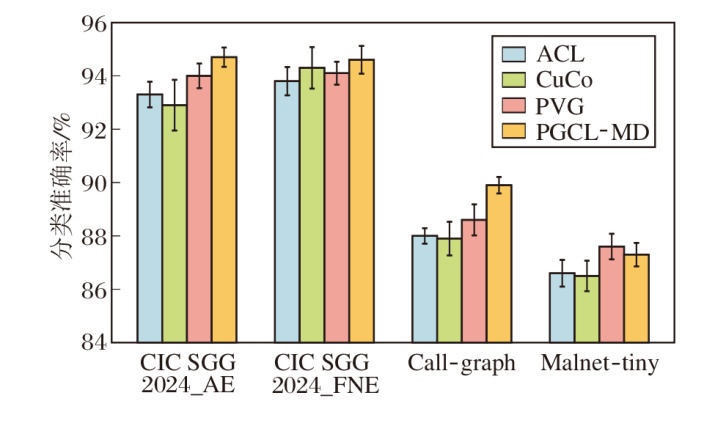 | 图4 不同课程学习方法的分类准确率Fig.4 Classification accuracy under different curriculum learning strategies |
由图4可见, 4种方法均产生正向促进作用.ACL虽因锚点调度策略取得一定效果, 但由于未能直接调控锚点-负样本对之间的对比难度, 性能提升幅度受限.CuCo的负样本采样策略虽遵循先易后难的原则, 但其难度定义依赖与锚点的相似度, 且未考虑锚点自身的类别典型性, 难以精准匹配恶意软件检测任务中对比学习的语义区分难度.PVG在Malnet-tiny数据集上表现最佳(领先PGCL-MD约0.3%), 但在其余3个数据集上均逊于PGCL-MD.PGCL-MD在4个数据集上分别达到最优值或次优值, 表明其在不同数据分布下均能保持稳定的优化过程.上述结果表明, 在样本对层级联合锚点与负样本的典型性以控制对比难度, 比仅从单侧或基于相似度的负采样策略更有效.
本节分析PGCL-MD中重要参数, 包括用于筛选样本对难度的Sigmoid函数的陡峭度α 、原型更新间隔T0、历史回顾间隔Th、课程学习难度的起始阈值Bmin和终止阈值Bmax、调度函数类型及困难锚点权重λ 0.
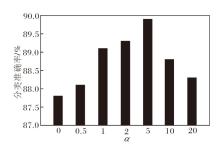
难度分数通过Sigmoid函数为样本对的课程学习分配权重, 而陡峭度α 控制Sigmoid函数的平滑程度.在Call-graph数据集上进行实验, 定义α =0, 0.5, 1, 2, 5, 10, 20, 其对PGCL-MD性能的影响如图5所示.由图可知, 当α 较小时, Sigmoid函数极为平滑, 此时所有样本对的权重相近, 课程学习的渐进筛选效果较弱.当α =5 时, 分类准确率达到峰值89.9%, 表明在该陡峭度下, PGCL-MD既能筛选与学习进程适配的样本对, 又保持样本对的多样性.进一步增大 α =10, 20, 此时Sigmoid函数逐渐逼近于0-1硬阈值, 导致样本对失去连续加权的优势, 分类准确率分别回落至88.8%和88.3%.因此, 过小或过大的α 均会削弱课程学习的效果, 这表明适中的Sigmoid函数平滑程度对样本对动态加权具有重要意义.
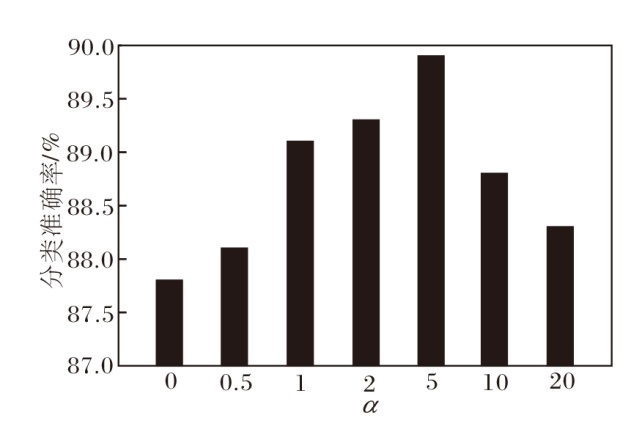 | 图5 α 对PGCL-MD性能的影响Fig.5 Effect of α on PGCL-MD performance |
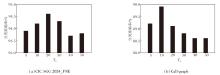
在模型训练中, 每隔T0轮次对样本集重新进行聚类并计算每个样本的典型性分数.在CIC SGG 2024_FNE、Call-graph数据集上进行实验, 定义原型更新间隔T0=5, 10, 20, 30, 40, 50, 其对PGCL-MD性能的影响如图6所示.
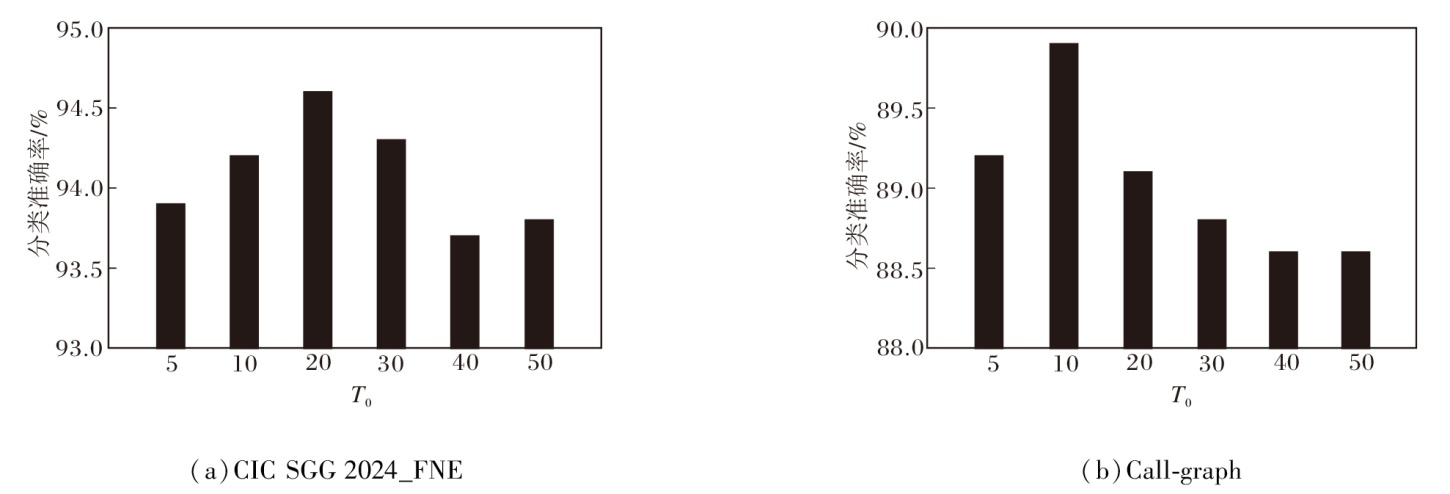 | 图6 T0对PGCL-MD性能的影响Fig.6 Effect of T0 on PGCL-MD performance |
由图6可见, 在CIC SGG 2024_FNE数据集上, 分类准确率随T0呈现先升后稳再微降的趋势, 最优值出现在T0=20处.在Call-graph数据集上, 分类准确率在T0=10时达到峰值, 此后逐渐下降并趋于平缓.随着模型训练, 特征表示会演化, 聚类中心也会相应漂移.若更新间隔过大会导致难度标签过时, PGCL-MD将遵循失效的难度顺序.若更新间隔过小则导致聚类结果不稳定, 使课程学习缺乏连续性.
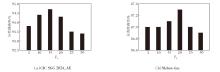
在模型训练中, 每隔Th进行一次历史回顾并标记高损失锚点.在CIC SGG 2024_AE、Malnet-tiny数据集上进行实验, 定义Th=5, 10, …, 30, 其对PGCL-MD性能的影响如图7所示.
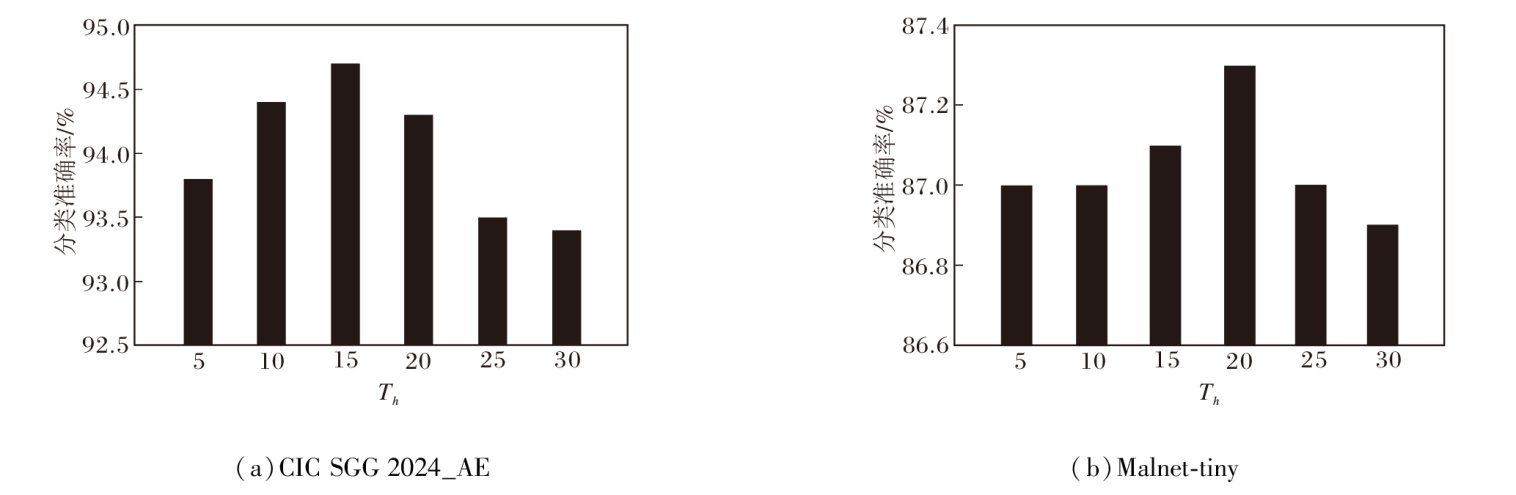 | 图7 Th对PGCL-MD性能的影响Fig.7 Effect of Th on PGCL-MD performance |
由图7可见, 在CIC SGG 2024_AE数据集上, 分类准确率随Th先增后减, 在Th=15 时达到最优值94.7%, 当Th=30时降至93.4%.在Malnet-tiny 数据集上, 性能波动较小, 最优值出现在Th=20处, 为87.3%.上述结果表明, 适中的Th能有效维持高损失锚点标记的时效性.
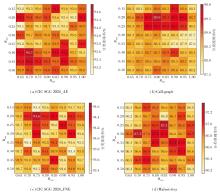
Bmin和Bmax分别表示课程学习难度的起始阈值与终止阈值, 共同控制训练过程中对比对的数量及难度水平.合理设置Bmin有助于构建良好的初始分类边界, 而恰当选取Bmax能有效滤除噪声样本.基于上述分析, 进一步考察 Bmin与 Bmax对分类性能的影响.为此, 在4个数据集上开展超参数实验, 并将分类准确率以热力图形式展示于图8中.由图可看出, 难度阈值的设置对分类性能影响显著.在CIC SGG 2024_AE、CIC SGG 2024_FNE数据集上, 最优参数集中在Bmin∈ [0.20, 0.40], Bmax∈ [0.70, 0.80], 分类准确率最高可达94.7%.在Call-graph数据集上, 在Bmin=0.20, Bmax=0.80附近取得最优分类准确率(89.9%), 对Bmin较敏感.在Malnet-tiny数据集上, 整体分类准确率波动不足1%, 对难度阈值不敏感.总之, 对于难度阈值在实际应用中应根据数据集的自身特性选取最优搭配.
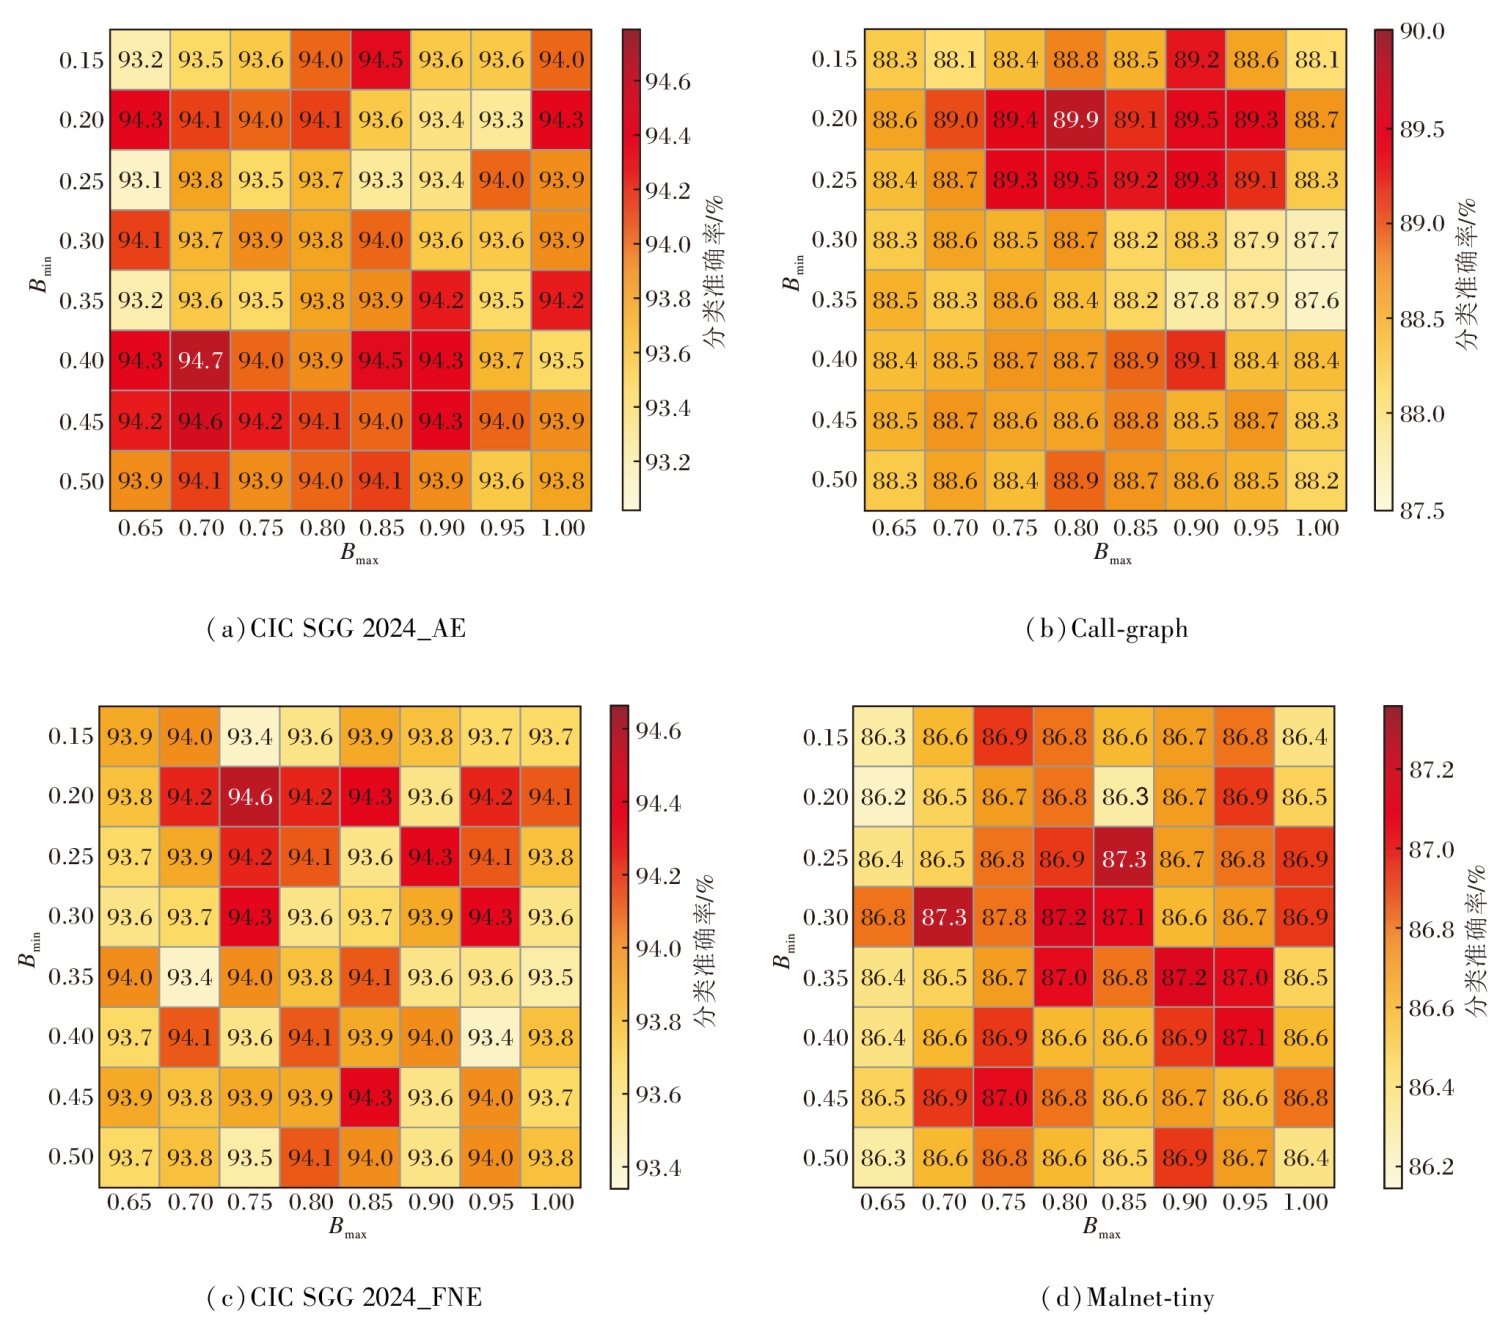 | 图8 Bmin、Bmax对PGCL-MD性能的影响Fig.8 Effect of Bmin and Bmax on PGCL-MD performance |
本文选用指数函数调度作为默认配置, 现对比线性函数、多项式函数和阶梯函数这3种常用的调度函数, 相应指标值如表4所示.由表可见, 不同函数对分类性能的影响较小.
| 表4 不同调度函数的指标值对比 Table 4 Metric value comparison of different scheduling functions % |
下面考察困难锚点权重λ 0对分类性能的影响.在Call-graph数据集上固定其它最优参数, 令λ 0=1.0, 1.1, 1.2, 1.3, 1.4, 1.5, 2.0, 相应分类准确率如表5所示, 表中黑体数字表示最优值.由表可见, 分类准确率λ 0的最优值集中在λ 0=1.2附近, 此时在各数据集上均能取得接近最优的性能.当λ 0从1.0增至1.2时, 在Call-graph、CIC SGG 2024_AE数据集上的分类准确率分别提升0.7%和1.2%, 表明适度强化困难锚点有助于提升边界样本的判别能力.继续增大至λ 0=2.0时, 所有数据集上的分类准确率均出现回落, 说明过高的权重会使方法过度拟合噪声锚点, 损害泛化性.不同数据集对λ 0的敏感程度存在差异:Call-graph数据集对λ 0较敏感(最优值与最劣值差距1.1%), 而Malnet-tiny、CIC SGG 2024_FNE数据集上的性能波动则较小.综合上述结果, 建议实际应用中以λ 0=1.2为基准, 并在 [1.0, 1.5] 范围内根据验证集进行微调, 该区间可保证稳定的性能提升并有效避免过拟合风险.
| 表5 λ 0对PGCL-MD性能的影响 Table 5 Effect of λ 0 on PGCL-MD performance |
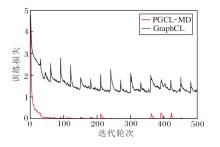
为了评估PGCL-MD在训练过程中的稳定性, 记录每轮的损失值, 并与GraphCL进行对比.两种方法在CIC SGG 2024_AE数据集上的损失变化曲线如图9所示.由图可知, PGCL-MD在收敛速度与稳定性上均显著优于GraphCL.训练至40轮次时, PGCL-MD的损失幅度显著变小, 这说明此时已学习典型样本的编码模式, 而后续在难样本上的训练可视为对模型的微调.因此, PGCL-MD在40轮之后的损失幅度变化较小且基本稳定.相比之下, GraphCL在对比训练中未区分样本对难度, 导致收敛过程不稳定, 损失呈脉冲状变化.
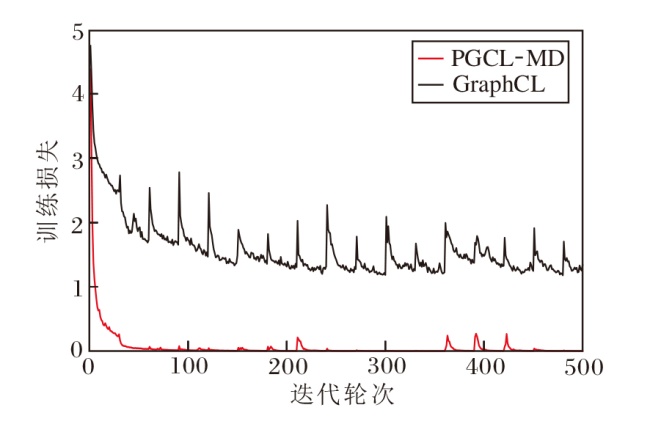 | 图9 2种方法的训练损失变化曲线Fig.9 Training loss curves of two methods |
对比学习常通过聚类获取伪标签, 导致训练初期存在大量噪声标签.对负样本的随机采样容易导致假阴性问题.PGCL-MD在训练初期仅挑选典型样本对参与训练, 避免边缘样本的过早介入, 从而有效缓解假阴性问题.
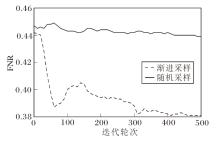
为了验证该观点, 设计如下对比实验.将本文的渐进采样策略替换为随机采样策略, 每隔10个迭代周期计算负样本对的平均假阴性率(False Negative Rate, FNR).在CIC SGG2024_AE数据集上进行实验, 相应FNR值如图10所示.
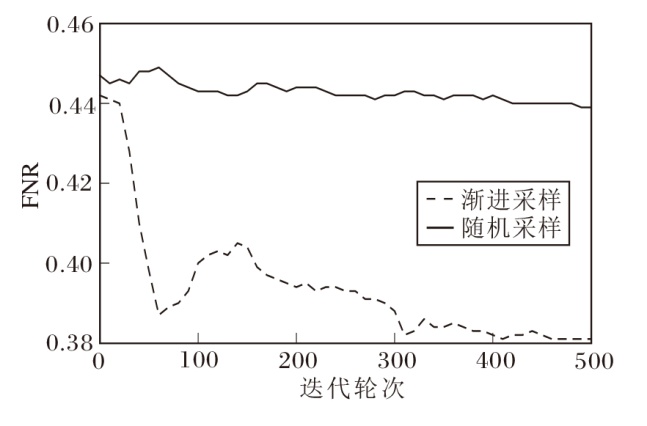 | 图10 两种采样策略下负样本对的平均假阴性率Fig.10 Average false negative rate of negative pairs under two sampling strategies |
由图10可见, 渐进采样策略的FNR值显著低于随机采样策略, 这是由于PGCL-MD早期选取各聚类中心附近的典型样本对, 可帮助模型快速建立清晰的簇间边界.当获得足够的表征能力后, 再逐步引入边界模糊的难样本, 大幅缓解噪声标签带来的影响.
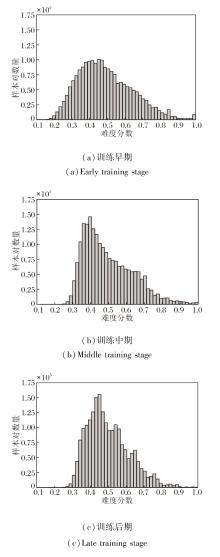
为了进一步探究PGCL-MD降低FNR的深层机制, 在训练过程上记录数据集上所有样本对的难度分布.具体而言, 分别在训练早期(迭代周期为0)、中期(迭代周期为200)和后期(迭代周期为400), 利用当前方法提取的特征重新计算每个样本对的难度, 并绘制难度分布直方图, 具体如图11所示.
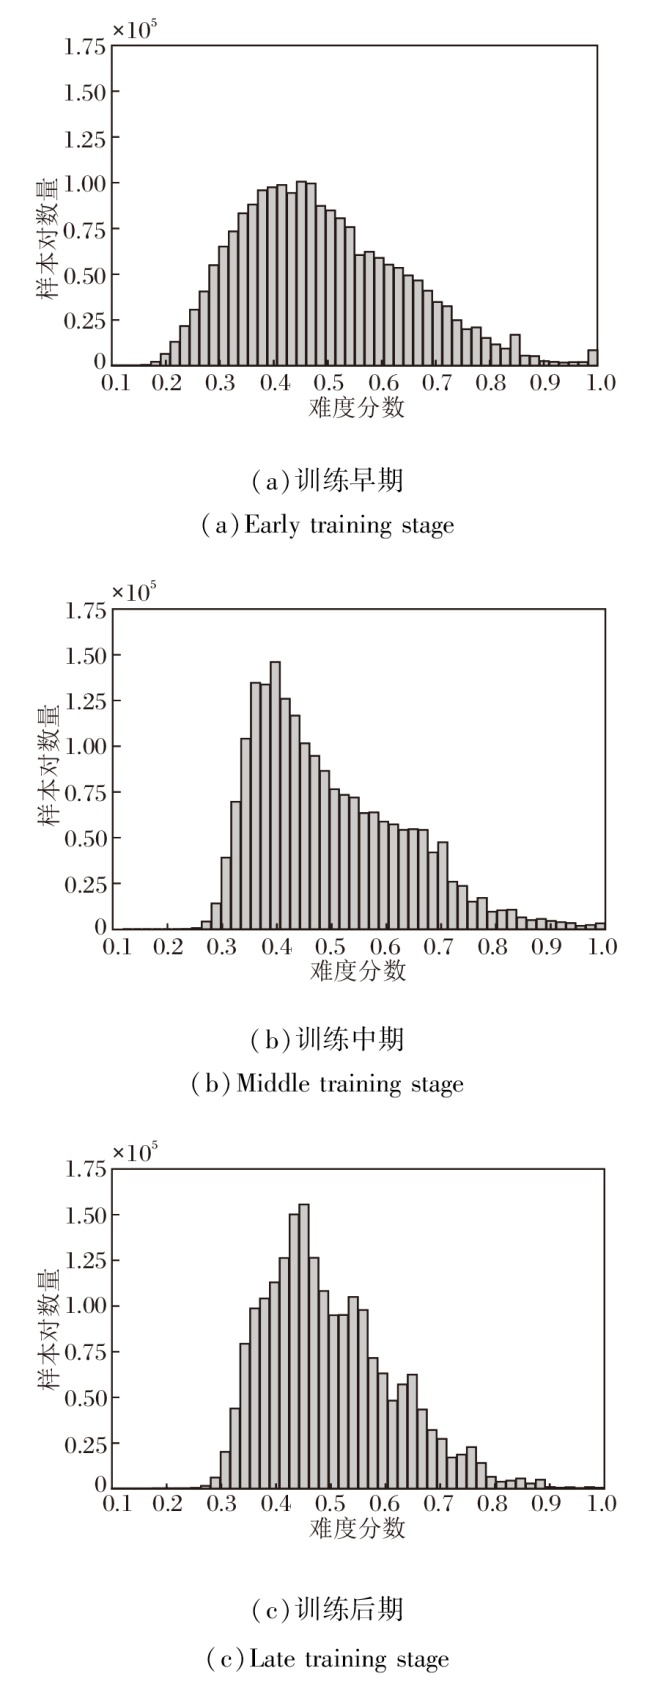 | 图11 样本对难度分布图Fig.11 Difficulty distribution of sample pairs |
由图11可知, 训练早期样本对的难度分布最分散且在高难度区间存在一定的比例, 表明不同类别的边界区域存在显著混淆, 这也解释为何随机负采样在早期阶段会产生大量假阴性样本.进入训练中期后, 难度分布整体向低值区间偏移, 峰值位置由0.451左移至0.397, 峰值高度较早期大幅提高, 低难度侧的样本对数量略有增加, 同时高难度样本对数量占比降低.此时典型样本逐步向类中心聚拢, 特征空间的可分性随之改善.在训练后期, 难度分布进一步收窄至低难度区域, 而高难度样本对数量明显减少.值得注意的是, 后期低难度样本对的数量低于初期水平.这是由于训练初期随机初始化的特征使同类样本在簇内产生虚假的过度分散, 而渐进式学习策略通过逐步引入难度递增的样本对, 促使方法将簇内距离校正至更真实的分布水平.上述分布演化过程表明, 本文的渐进式学习策略通过调控样本对的采样顺序, 能有效引导方法学习更清晰且紧凑的特征空间结构.
本文提出基于原型图对比学习的恶意软件检测方法(PGCL-MD), 为检测模型构建从典型到边缘的渐进式学习模式, 提升训练稳定性和检测能力.针对一般课程学习方法在对比学习中无法有效建模对比关系难度的问题, 在样本对层级结合锚点和负样本的典型性, 定义原型驱动的难度评估器.为了提高训练效率和过滤噪声, 设计双阈值动态调度器.此外, 针对困难锚点难训练的问题, 提出历史导向的困难锚点强化机制, 同步提升对困难锚点的表征能力.这一研究有望推广至二进制相似性检测、漏洞函数搜索乃至智能合约审计等更广泛的图分析任务中.
本文责任编委 何清
Recommended by Associate Editor HE Qing
| [1] |
|
| [2] |
|
| [3] |
|
| [4] |
|
| [5] |
|
| [6] |
|
| [7] |
|
| [8] |
|
| [9] |
|
| [10] |
|
| [11] |
|
| [12] |
|
| [13] |
|
| [14] |
|
| [15] |
|
| [16] |
|
| [17] |
|
| [18] |
|
| [19] |
|
| [20] |
|
| [21] |
|
| [22] |
|
| [23] |
|
| [24] |
|
| [25] |
|
| [26] |
|
| [27] |
|
| [28] |
|
| [29] |
|
| [30] |
|
| [31] |
|
| [32] |
|
| [33] |
|
| [34] |
|
| [35] |
|
| [36] |
|
| [37] |
|