

基于视觉语义动态锚定的双空间约束可见光-红外行人重识别方法
[谭荃戈1  , 孟思雨
1 , 毕艺瀚1 , 王蓉1 ]
, 孟思雨, 毕艺瀚, 王蓉]
|
|


作者简介:
谭荃戈,博士研究生,主要研究方向为行人目标追踪、行人重识别、图像分割.E-mail:tanquange@126.com.
孟思雨,硕士研究生,主要研究方向为深度伪造监测.E-mail:1983160587@qq.com.
毕艺瀚,博士研究生,主要研究方向为行人重识别.E-mail:rcbyh2023@126.com.
可见光-红外行人重识别是全天候视频监控的关键技术之一,但受模态异质性、姿态变化与遮挡等因素的制约,仍存在局部语义建模容易错位、训练目标与推理目标脱节、单空间匹配鲁棒性不足等问题.针对上述问题,文中提出基于视觉语义动态锚定的双空间约束可见光-红外行人重识别方法(Dual-Space Constrained Visible-Infrared Person Re-identification Method Based on Visual Semantic Dynamic Anchoring, DS-VSDA).首先,设计语义驱动的原型动态锚定模块,引入人体部位空间先验,缓解语义冗余与漂移.然后,提出跨样本邻域关联损失,显式建模批次内样本拓扑关系,使训练约束与推理检索逻辑保持一致.最后,构建双空间一致性约束与匹配动态校准机制,融合深层特征和浅层特征,并通过互证校验优化匹配结果.在SYSU-MM01、RegDB数据集上的实验表明,DS-VSDA在室内外多场景中的性能稳定,由此验证其有效性.
About Author:
TAN Quange, Ph.D. candidate. His research interests include pedestrian tracking, person re-identification, and image segmentation.
MENG Siyu, Master student. Her research interests include deepfake detection.
BI Yihan, Ph.D. candidate. His research interests include person re-identification.
Visible-infrared person re-identification is a key technology for all-day video surveillance. However, constrained by modality heterogeneity, pose variations, and occlusions, existing methods still suffer from misalignment in local semantic modeling, a gap between training and inference objectives, and insufficient robustness in single-space matching. To address these issues, a dual-space constrained method based on visual-semantic dynamic anchoring(DS-VSDA)is proposed. First, a semantics-driven prototype dynamic anchoring module is designed to introduce spatial prior initialization of human body parts, thereby alleviating semantic redundancy and drift. Then, a cross-sample neighborhood affinity loss is introduced to explicitly model the topological relations among samples within a batch, bridging the training-inference gap. Finally, a dual-space semantic consistency constraint and a matching calibration mechanism are constructed to fuse shallow and deep features and optimize matching results through mutual verification. Experiments on the SYSU-MM01 and RegDB datasets demonstrate that DS-VSDA achieves stable performance in both indoor and outdoor scenarios, thereby validating its effectiveness.
行人重识别是支撑公共安全防控、案件溯源的重要技术, 旨在从非重叠视域的多摄像设备中检索同一身份的目标行人.传统可见光行人重识别在光照充足场景中已实现规模化应用, 但在夜间、弱光、逆光等极端环境下成像质量严重衰减, 无法满足全天候需求.红外热成像摄像头可在零可见光条件下稳定捕捉目标轮廓, 因此红外-可见光行人重识别成为突破全天候行人检索瓶颈的重要路径, 是行人追踪领域的研究热点之一.
红外-可见光行人重识别的核心挑战源于模态间固有的异质性鸿沟:可见光图像蕴含丰富的颜色、纹理信息, 红外图像仅能反映目标的热辐射轮廓, 二者特征分布差异显著; 叠加行人姿态变化、视角偏移、局部遮挡等场景干扰; 数据集标注成本较高、样本规模有限.现有方法在多场景复杂条件下的匹配鲁棒性仍有提升空间.
针对上述挑战, 学者们围绕多条技术路线开展研究, 核心可归纳为部件级特征学习、跨模态特征对齐、多空间与多尺度特征增强.
部件级特征学习是红外-可见光行人重识别方法的主流范式, 挖掘局部特征, 补充全局判别信息.早期固定水平分割方法易受姿态变化影响出现部件错位, 后续研究围绕可学习注意力与结构感知优化部件建模.Chen等[1]提出SPOT(Structure-Aware Po-sitional Transformer), 利用结构与位置信息缓解错位问题.Kim等[2]提出PartMix, 通过跨模态部件混合, 提升局部特征正则化效果.Liu等[3]引入异质中心三元组损失, 优化部件特征的判别性.但是, 现有软划分方法多采用随机初始化策略, 缺乏人体结构先验引导, 容易出现语义坍缩、漂移等问题, 限制跨模态对齐精度.
早期, Zero-Padding通过零填充策略首次将红外-可见光跨模态行人重识别问题形式化, 奠定该任务的基础[4].Ye等[5]提出AGW(Attention Genera-lized-Mean Pooling with Weighted Triplet Loss), 作为通用的行人重识别统一强基线, 融合非局部注意力、广义均值池化与加权三元组损失, 成为跨模态行人重识别广泛采用的对比基准.跨模态特征对齐与度量学习的核心目标是缩小模态分布差异, 学习模态不变的判别性特征.
生成式方法通过对抗训练实现像素与特征联合对齐, 代表性工作包括cmGAN(Cross-Modality Gene-rative Adversarial Network)[6]、AlignGAN(Alignment Generative Adversarial Network)[7].Wang等[8]提出JSIA-ReID(Joint Set-Level and Instance-Level Align-ment Re-ID), 生成红外-可见光成对图像, 桥接模态差异, 但容易引入生成噪声, 训练复杂度较高.
模态解耦类方法通过分离域相关与身份相关特征提纯判别信息.ADCNet(Adversarial Disentangle-ment and Correlation Network)[9]、DmiR(Decoupling and Modality-Invariant Representation Learning)[10]、SDL(Spectrum-Disentangled Representation Learning)[11]通过对抗解耦、正交去相关等策略抑制模态特有信息.Hao等[12]提出MCLNet(Modality Confusion Learning Network), 通过混淆模态分布提升跨模态泛化性.Kim等[2]提出PartMix, 通过正则化提升训练稳定性.Feng等[13]提出MSR(Modality-Specific Networks), 为可见光与红外分别建模特有信息, 缩小模态差异.此外还有X-Infrared-Visible[14]、记忆增强[15]等策略.
在特征对齐与度量学习方面, Lu等[16]提出cm-SSFT(Cross-Modality Shared-Specific Feature Transfer Algorithm), 将特征分解为跨模态共享特征与模态特定特征, 并通过跨模态近邻传播补偿红外样本损失的特定信息.Zhang等[17]提出FMCNet(Feature-Level Modality Compensation Network), 在特征层面补偿红外缺失信息.Wei等[18]提出SMCL(Syncretic Moda-lity Collaborative Learning), 利用双模态信息融合模态进行协同学习.Park等[19]提出LbA, 利用跨模态对应关系进行对齐学习.Liu等[20]提出MAUM(Memory-Augmented Unidirectional Metrics), 引入记忆增强的单向度量学习.Zhu等[21]提出CMGR(Cross-Modal Group-Relation Optimization), 优化跨模态群组关系.Jiang等[22]提出L2RW, 对特征进行模态自适应混合与不变分解, 将模态特征与身份特征解耦, 从而补充模态信息, 强化跨模态关联.Lu等[23]提出PMT(Progressive Modality-Shared Transfor-mer), 逐步融合双模态特征, 提升对齐精度.Hu等[24]提出DJANet(Dual-Level Joint Align Network), 从特征与表征两个层级协同缓解模态鸿沟问题.Jiang等[25]提出CMT(Cross-Modality Transformer), 使用Transformer建模跨模态关系.Guo等[26]提出CFET(Cross-Fusion Enhanced Transformer Model), 通过交叉融合增强跨模态特征交互.Fu等[27]提出CMNAS(Cross-Modality Neural Architecture Search), 构建加权融合的交叉注意力机制与多尺度残差结构结合的视觉Transformer网络.Wu等[28]提出MPA-Net(Modality and Pattern Alignment Network), 通过模态与模式对齐挖掘跨模态细微差异.Li等[29]提出CIFT(Counterfactual Intervention Feature Transfer), 通过反事实干预去除模态相关干扰.Zhang等[30]提出MSCLNet(Modality Synergy Complement Learning Net-work), 实现模态协同互补与级联聚合.Ye等[31]提出DDAG(Dynamic Dual-Attentive Aggregation), 采用动态双注意力聚合.Ye等[32]提出CAJ(Channel Aug-mented Joint Learning), 通过交换可见光图像与红外图像的颜色通道进行增强, 并联合原始图像与增强图像共同训练, 从而缓解模态差异.现有方法的训练约束大多依赖单样本身份损失与稀疏成对三元组损失, 缺乏对批次内样本邻域拓扑结构的显式建模, 导致训练目标与推理匹配逻辑脱节, 难样本判别能力不足.
多空间、多尺度的鲁棒特征增强方法通过融合多层次、多粒度互补信息提升匹配鲁棒性.Chen等[33]提出NFS(Neural Feature Search), 实现粗粒度通道与细粒度空间的联合特征选择.Sarker等提出WF-CAMReViT(Weighted Fused Cross-Attention Multi-scale Residual Vision Transformer)[34]与TNAS(Trans-former-Based Neural Architecture Search)[35], 分别从跨模态与Transformer角度开展神经架构搜索.Hu等[24]提出DJANet, Guo等[26]提出CFET, 分别通过多粒度增强、跨模态交互融合强化特征表示.Li等[36]提出FDMNet(Frequency Domain Modality-In-variant Feature Learning Framework), 从幅值与相位角度提升跨模态特征不变性.Qiu等[37]提出HOS-Net(High-Order Structure Based Middle-Feature Lear-ning Network), 利用超图建模局部特征高阶关系.Wu等[38]提出CycleTrans(Cycle-Construction Based Network), 通过将特征先映射为模态无关的中立表示, 再重构回原模态的循环机制, 学习兼具跨模态通用性与身份判别性的特征.Wu等[39]提出MIP(Modality-Aware and Instance-Aware Visual Prompt), 通过视觉提示增强模型输入适应性.Ning等[40]提出EIE(Enhancement, Integration, Expansion), 通过区域与上下文融合提升特征完整性.Lin等[41]提出APR(Attribute-Person Recognition), 利用语义属性增强特征判别性.Huang等[42]提出CSVI(Co-segmen-tation Assisted Visible-Infrared Person Re-identifica-tion), 借助跨模态语义相似性缩小模态分布差异.Chen等[43]提出CFSR-Net(Consistency Driven Fea-ture Scoring and Regularization Network), 通过跨模态一致性约束提升特征鲁棒性.近期, Zhang等[44]提出WSL-VIReID, 通过跨模态互补信息交换, 进一步提升特征对齐精度.
频域方法借助幅度-相位分解与跨模态频谱对齐有效缓解遮挡场景中的部件错位问题.同时, 弱监督[45]、无监督[22]与隐私保护[46]等更贴近真实部署的设定, 也受到广泛关注.但是, 现有方法在推理阶段仍普遍依赖单一深层特征空间, 未充分利用浅层跨模态不变的轮廓细节信息, 也缺乏双空间交叉校验机制, 难样本匹配鲁棒性不足.
总之, 虽然部件级特征学习、跨模态对齐与多空间增强等方向已有大量文献, 但是当前方法仍面临3个核心瓶颈.1)与已有工作中简单的前景-背景分割或固定水平切分不同, 局部语义建模缺乏人体结构先验引导, 通用注意力机制的无监督收敛容易产生语义漂移, 导致部件表征与人体部位之间缺乏稳定对应.2)特征学习以单样本身份分类和稀疏成对度量为主, 未对批次内样本邻域拓扑进行显式建模, 训练约束与推理检索逻辑之间存在差距.3)推理阶段仅依赖深层特征空间, 未充分利用浅层跨模态不变的轮廓边缘等细节信息.
针对上述问题, 本文提出基于视觉语义动态锚定的双空间约束红外-可见光行人重识别方法(Dual-Space Constrained Visible-Infrared Person Re-identifica-tion Method Based on Visual Semantic Dynamic Ancho-ring, DSVSDA).首先, 设计语义驱动的原型动态锚定模块(Semantic Prototype Dynamic Anchoring, SPDA), 引入人体部位空间先验, 对可学习原型进行软初始化, 使各原型在训练之初就获得明确的空间语义指向(如头部、躯干、下肢等), 并结合原型间互斥损失, 抑制不同原型的注意力重叠.然后, 提出跨样本邻域关联损失(Neighbor Relation Loss, NRL), 在批次内为每个样本选取K个最近正邻域和最难负样本, 分别施加绝对距离阈值约束:正样本的距离应小于给定上界, 负样本的距离应大于给定下界.将度量学习从相对排序优化推广至绝对几何边界约束, 使特征空间的类内紧凑性与类间分离性得到更直接的控制, 训练目标与检索逻辑更加一致.最后, 设计双空间一致性约束与匹配动态校准机制(Dual-Space Consistency Calibration, DSCC).该机制同时利用浅层特征(富含跨模态不变的轮廓边缘信息)和深层特征(编码高层身份语义)进行联合匹配.训练时通过余弦距离项与均方误差项对齐浅层特征与深层特征的语义分布, 推理时以两个空间匹配结果的一致性作为门控信号:当浅层空间和深层空间判断一致时增强匹配置信度, 判断矛盾时抑制该匹配, 以此实现深层特征和浅层特征的自适应互补, 避免简单拼接引入的噪声耦合.
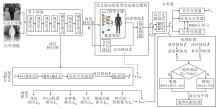
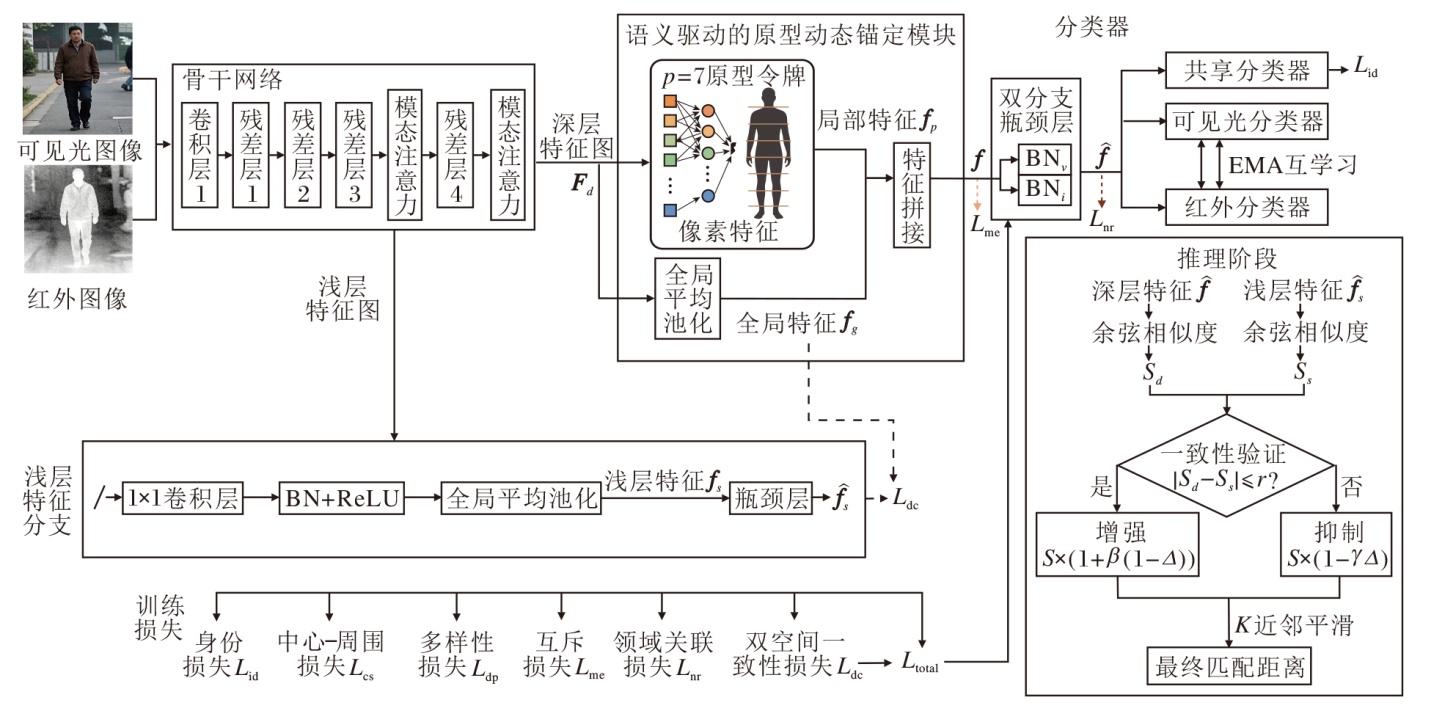
本文提出基于视觉语义动态锚定的双空间约束可见光-红外行人重识别方法(DS-VSDA), 总体架构如图1所示.可见光图像与红外图像共享Res-Net50骨干网络, 在残差层3和残差层4之后嵌入模态注意力模块(Modality Attention Module, MAM), 缓解模态分布差异.
 | 图1 DS-VSDA总体架构Fig.1 Overall architecture of DS-VSDA |
输入特征图X∈ RC× H× W, 其中, C表示特征图的通道数, H、W分别表示特征图的高度和宽度.MAM输出为:
$ \boldsymbol{Y}=G(\boldsymbol{X}) \odot \boldsymbol{X}+(\mathbf{1}-G(\boldsymbol{X})) \odot I N(\boldsymbol{X}) .$
其中:
$ G(\boldsymbol{X})=\sigma\left(\operatorname{Conv}_{1 \times 1}\left(\operatorname{ReLU}\left(\operatorname{Conv}_{1 \times 1}(\operatorname{AvgPool}(\boldsymbol{X}))\right)\right)\right)$
表示通道注意力门控函数(降维比r=16), σ (· )表示Sigmoid函数, Conv1× 1(· )表示1× 1卷积计算, ReLU(· )表示ReLU激活函数, AvgPool(· )表示平均池化; IN(X)表示实例归一化; ☉表示逐通道乘积.在结构上, MAM由通道注意力门控与实例归一化(Instance Normalization, IN)两条支路构成.通道注意力支路通过全局平均池化后连接两层1× 1卷积(降维比r=16), 生成通道级软门控权重; IN支路对特征进行实例级归一化, 去除模态特有的均值与方差统计信息.两个支路通过门控权重进行动态融合:门控值大时偏向保留原始判别特征, 门控值小时增强IN的去模态化效果, 从而在保留身份判别能力的同时自适应缩小可见光特征与红外特征的模态分布差异.
骨干网络在残差层2输出浅层特征图, 经轻量升维模块生成浅层特征, 构建浅层细节空间.在残差层4输出深层特征图, 经语义驱动的原型动态锚定模块(SPDA)生成部件特征, 与全局池化特征拼接后经双分支瓶颈层(Bottleneck, BN)归一化, 得到最终的深层特征表示, 送入共享分类器及模态专属互学习分类器进行身份学习.
模态专属互学习分类器由可见光分类器与红外分类器及其对应的影子分类器构成, 影子分类器不参与梯度更新, 而是通过指数移动平均(Exponential Moving Average, EMA)平滑主分类器的权重, 并与主分类器进行互学习.
训练阶段的总损失由身份分类损失、跨模态中心损失、部件多样性损失与本文新增的3项损失加权求和构成.推理阶段分别在深层空间和浅层空间计算余弦相似度, 经一致性校验动态校准后输出最终匹配距离.
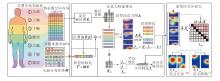
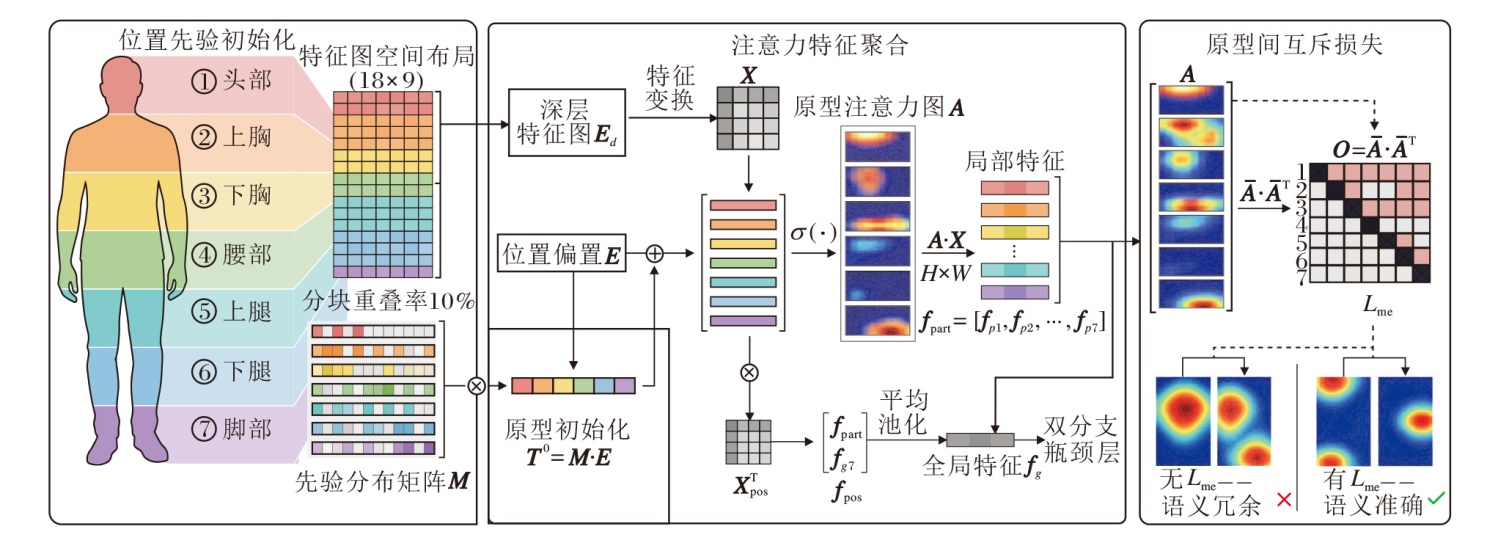
现有部件学习方法可大致分为2类:固定水平分割和可学习注意力.这两类方法的共同特点是部件语义完全由数据驱动形成, 缺乏人体结构的显式引导.固定分割的部件边界刚性, 难以适应姿态变化; 可学习注意力虽具有空间灵活性, 但由于采用随机初始化策略, 不同原型在无监督收敛后常出现语义重叠与漂移.因此, 本文设计语义驱动的原型动态锚定模块(SPDA), 核心区别在于引入人体部位空间位置先验:利用垂直方向上头部-躯干-下肢的解剖学分布规律对原型进行软初始化, 使各原型在训练之初获得明确的空间语义锚点.与PartMix等方法的本质差异在于:SPDA并非简单地让模型“ 学习” 部件划分, 而是为部件学习提供人体结构驱动的初始约束与持续正则(互斥损失), 使部件表征与人体部位之间建立更稳定、可解释的对应关系.SPDA框架如图2所示.
 | 图2 SPDA框架图Fig.2 SPDA framework |
1)注意力特征聚合.如图2中间区域所示, 深层特征图Fd∈ RB× C× H× W展平为像素特征序列X∈ RB× N× C(N=H× W), 其中B表示训练批次大小, 叠加可学习位置嵌入E∈ RN× C, 得到加入位置嵌入的输入特征:
$ \boldsymbol{X}_{\mathrm{pos}}=\boldsymbol{X}+\boldsymbol{E}, $
其中, E为各样本共享, 通过广播机制沿批量维度B复制, 与X逐元素相加.
P(P=7)个语义原型T∈ RP× C与Xpos计算内积并经Sigmoid激活, 生成注意力图:
$ \boldsymbol{A}=\boldsymbol{\sigma}\left(\boldsymbol{T} \cdot \boldsymbol{X}_{\text {pos }}^{\mathrm{T}}\right) \in \mathbf{R}^{B \times P \times N} .$
以A为权重对X加权聚合, 得到部件特征fpart∈ RP× C, 再与全局池化特征fg拼接, 得到拼接特征 f∈ R(P+1)× C.
2)位置先验锚定初始化.如图2左侧区域所示, 利用人体部位在垂直方向上的空间分布先验初始化原型.将特征图划分为P(P=7)个具有适度重叠的语义区域, 从上到下依次对应头部、上胸、下胸、腰部、上腿、下腿和脚部, 构建先验分布矩阵M∈ RP× N, 矩阵元素:
$ M_{p, n}=\left\{\begin{array}{ll} \frac{1}{\left|R_{p}\right|}, & n \in R_{p} \\ 0, & \text { 其它 } \end{array}\right.$
其中Rp表示第p个部位对应的像素集合.利用M对位置嵌入加权求和, 生成初始原型:
$ \boldsymbol{T}^{(0)}=\boldsymbol{M} \cdot \boldsymbol{E} .$
该初始化使每个原型在训练开始阶段就能锚定对应人体区域的空间位置信息.相邻区域设置约10%的重叠, 兼顾先验引导的稳定性与数据驱动的灵活性.原型初始化后仍作为可学习参数参与端到端训练.为了保证遮挡、姿态弯曲等复杂场景中位置先验的有效性, 首先, 位置先验的初始化仅提供训练起点的引导, 采取如下措施.原型在端到端训练中可根据数据自适应调整, 当行人出现局部遮挡或姿态变化时, 原型可通过梯度优化偏离初始锚点以适应实际空间偏移.其次, 原型间互斥损失对注意力重叠的约束是软性的(取上三角均值而非逐对强制正交), 为非标准姿态下的空间重叠保留容忍度, 避免因强制正交而导致部件割裂.
3)原型间互斥损失.如图2右侧区域所示, 为了防止训练中原型注意力趋同, 对注意力图的空间重叠施加惩罚.将注意力图沿空间维归一化为概率分布
$ \boldsymbol{O}=\overline{\boldsymbol{A}}_{p} \cdot \overline{\boldsymbol{A}}_{p}{ }^{\mathrm{T}} \in \mathbf{R}^{P \times P} .$
互斥损失取所有原型对上三角元素的均值:
$ L_{\mathrm{me}}=\frac{1}{B} \sum_{b=1}^{B} \frac{2}{P(P-1)} \sum_{i=1}^{P} \sum_{j=i+1}^{P} O_{i, j}^{(b)}, $
其中,
最小化Lme促使各原型的注意力分布趋向空间正交.位置先验初始化提供语义锚点, 互斥损失提供持续约束, 二者协同保障原型对人体部位的稳定覆盖.
现有红外-可见光重识别方法的训练损失以单样本身份分类和成对/三元组度量为主, 缺乏对批次内全局样本拓扑结构的显式感知.本文提出跨样本邻域关联损失(NRL), 为每个样本显式构建正负邻域并分别施加聚合与推离约束.
对于批次内归一化特征$ \left\{\widetilde{\boldsymbol{f}_{i}}\right\}_{i=1}^{B}$, 计算余弦相似度矩阵S, 矩阵元素
$ S_{i, j}=\tilde{\boldsymbol{f}}_{i}^{\mathrm{T}} \cdot \tilde{\boldsymbol{f}}_{j} .$
定义余弦距离
$ d_{i, j}=1-S_{i, j} .$
对于锚点样本i, 从同身份样本中选取相似度最高的M(M=4)个构成正邻域
$ \begin{array}{l} L_{\mathrm{pos}}^{(i)}=\frac{1}{M} \sum_{j \in N_{i}^{+}} \max \left(0, d_{i, j}-m_{\mathrm{pos}}\right), \\ L_{\mathrm{neg}}^{(i)}=\max \left(0, m_{\mathrm{neg}}-d_{i, j^{* }}\right), \end{array}$
其中, mpos=0.3, mneg=0.7, 分别表示正负邻域的距离阈值.最终的邻域关联损失为批次内的均值:
$ L_{\mathrm{nr}}=\frac{1}{|V|} \sum_{i \in V} L_{\mathrm{pos}}^{(i)}+\frac{1}{B} \sum_{i=1}^{B} L_{\mathrm{neg}}^{(i)} .$
NRL与现有度量学习及对比学习方法的区别体现在约束形式、优化目标和计算特性三个层面.首先, 在约束形式上, 三元组和对比学习使用相对排序损失(Margin-Based或Softmax-Based), NRL对正负邻域分别施加绝对距离阈值, 为特征空间提供更明确的几何边界.在负样本策略上, 对比学习依赖大batch或记忆库构建全局负样本, 存在假阴性风险, NRL仅使用批次内样本, 计算开销较小且避免跨批次的假阴性问题.上述设计使训练阶段的优化目标与推理阶段的检索逻辑保持高度一致.
从理论角度上, NRL与SupCon Loss和Multi-similarity Loss等代表性度量学习变体的关键区别如下.1)SupCon Loss使用softmax形式的全局归一化对比损失, 梯度由全体负样本共同决定:在VI-ReID中每个身份仅有少量样本的情况下, softmax分母受噪声负样本主导, 梯度信号被稀释.NRL的绝对阈值约束不依赖全局归一化, 梯度由正负邻域的局部几何关系直接确定.2)Multi-similarity Loss通过自相似性、正相对相似性和负相对相似性三个准则加权采样, 本质上仍是相对排序优化.NRL将优化从相对排序推广至绝对几何约束, 通过正邻域距离阈值margin_pos和负邻域距离阈值margin_neg直接规定正负邻域的期望距离界限, 对齐训练约束与推理时基于绝对距离的检索逻辑.3)上述损失函数均未显式建模多正样本的聚合结构, NRL对M个最近正邻域施加联合约束, 鼓励正样本形成紧致簇, 这对跨模态场景中身份特征的模态不变性尤其重要.
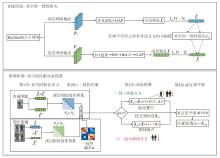
现有方法在推理阶段仅依赖深层特征空间计算匹配距离, 无法利用浅层网络中具有跨模态不变性的轮廓边缘等细节信息.本文构建双空间一致性约束与匹配动态校准机制(DSCC), 保持浅层细节空间与深层语义空间的独立性, 在训练阶段通过一致性损失对齐两个空间, 在推理阶段以双空间匹配结果的一致性作为校准信号, 一致时增强置信度, 不一致时抑制噪声.DSCC结构如图3所示.
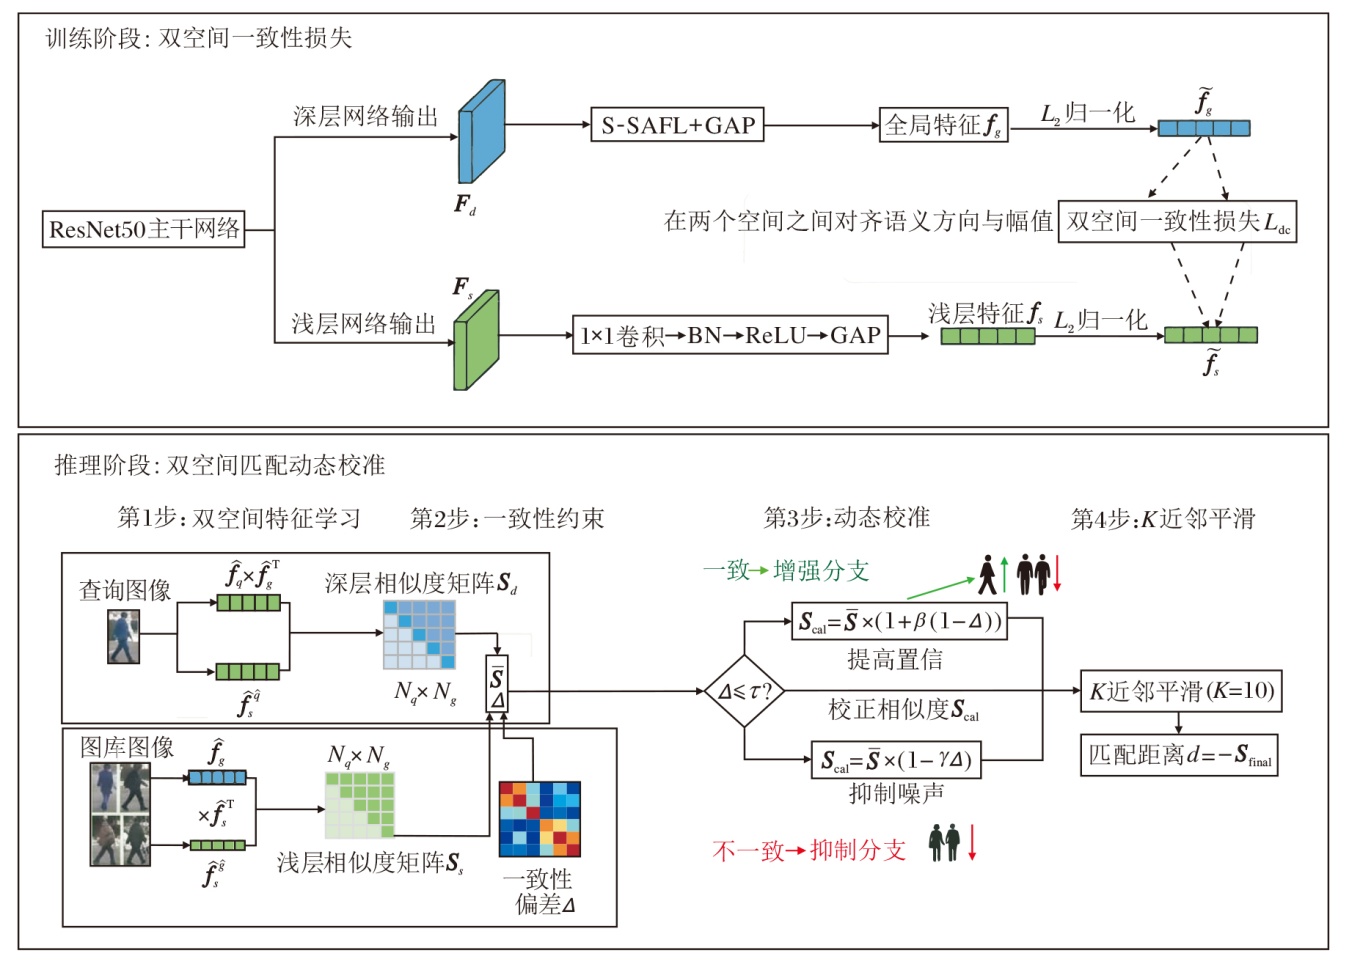 | 图3 DSCC结构图Fig.3 DSCC architecture |
在训练阶段, 对于L2归一化后的浅层特征
$ L_{\cos }=\frac{1}{B} \sum_{i=1}^{B}\left(1-\tilde{\boldsymbol{f}}_{s, i}^{\mathrm{T}} \cdot \tilde{\boldsymbol{f}}_{g, i}\right), $
与均方误差损失
$ L_{\mathrm{mse}}=\frac{1}{B} \sum_{i=1}^{B}\left\|\tilde{\boldsymbol{f}}_{s, i}-\tilde{\boldsymbol{f}}_{g, i}\right\|_{2}^{2}$
联合约束, 得到双空间一致性损失:
$ L_{\mathrm{dc}}=\alpha L_{\mathrm{cos}}+(1-\alpha) L_{\mathrm{mse}}, $
其中, α =0.6, 用于控制余弦损失与均方误差损失的相对重要性.Lcos约束特征方向一致性, Lmse约束特征幅度接近程度, 为推理阶段的双空间互证提供可靠基础.
在推理阶段, 如图3下侧所示, 对于查询集与图库集的L2归一化特征, 分别在深层空间和浅层空间计算余弦相似度矩阵S(d)和S(s), 进而计算平均相似度
$ \bar{S}_{i, j}=\frac{S_{i, j}^{(d)}+S_{i, j}^{(s)}}{2}, $
与一致性偏差
$ \Delta_{i, j}=\left|S_{i, j}^{(d)}-S_{i, j}^{(s)}\right|, $
其中, $ S_{i, j}^{(d)}$表示深层空间的余弦相似度矩阵中元素, $ S_{i, j}^{(s)}$表示浅层空间的余弦相似度矩阵中元素.
定义双空间一致性:
$ \boldsymbol{\Delta}=\left|\boldsymbol{S}_{\text {shallow }}-\boldsymbol{S}_{\text {deep }}\right|, $
值越小, 表示浅层特征与深层特征对同一匹配的判断越一致, 匹配置信度越高.校准后的相似度为:
$ S_{i, j}^{\text {cal }}=\left\{\begin{array}{ll} \bar{S}_{i, j}\left(1+\beta\left(1-\Delta_{i, j}\right)\right), & \Delta_{i, j} \leqslant \tau \\ \bar{S}_{i, j}\left(1+\gamma \Delta_{i, j}\right), & \Delta_{i, j}> \tau \end{array}\right.$
其中: β 表示增强系数, 用于增强匹配置信度的幅度; Δ i, j表示一致性偏差, 即深层空间与浅层空间对同一匹配对判断的差异; τ 表示评定双空间判断是否一致的阈值; γ ∈ [0, 1], 表示惩罚系数, 控制不一致时的抑制强度, 默认取γ =0.8.
为了抑制校准后的孤立噪声值, 对每个查询样本i, 取校准相似度中top-K近邻均值 μ i, 进行插值平滑, 得到平滑后的匹配相似度:
$ S_{i, j}^{\text {final }}=(1-\eta) S_{i, j}^{\text {cal }}+\eta \mu_{i} .$
其中:η =0.1, 表示平滑权重, 即邻域均值只占10%的贡献; K=10, 取top-10个最相似近邻求均值.最终匹配距离为:
$ d_{i, j}=-S_{i, j}^{\text {final }} .$
总之, 训练阶段的一致性损失为双空间建立统一语义基准, 推理阶段的动态校准利用一致性信息自适应增强或抑制匹配结果, 整个机制保持两个特征空间的独立性, 避免简单拼接融合可能引入的噪声耦合.双空间校准中的一致性阈值τ 控制校准的灵敏度.τ 过小时校准过激, τ 过大时校准退化.增强系数β 与惩罚系数γ 控制校准强度.
本文在SYSU-MM01、RegDB这2个红外-可见光跨模态行人重识别领域通用的基准数据集上开展实验, 验证DS-VSDA的有效性与泛化性.
SYSU-MM01数据集上通过4台可见光、2台近红外摄像机采集图像, 覆盖室内外多场景, 包含491个行人身份, 其中395个身份用于训练、96个身份用于测试, 共287 628幅图像, 模态差异与场景复杂度突出.实验同时以红外图像为查询集、可见光图像为图库集, 设置全场景搜索(All-Search)和室内搜索(Indoor-Search)两种检索模式.
RegDB数据集是双视角对齐采集的受控基准数据集, 包含412个行人身份, 每个身份对应10幅可见光图像和10幅红外图像, 共8 240幅图像.选取206个身份用于训练, 剩下206个身份用于测试.检索设置包括红外-可见光模式和可见光-红外模式.
本文采用Rank-1识别率与平均精度均值(Mean Average Precision, mAP)评估方法的跨模态检索性能, Rank-1识别率衡量检索首检命中率, mAP衡量模型整体检索精度.
本文采用在ImageNet上预训练的ResNet50作为骨干网络, 输入图像统一缩放至288× 144.训练阶段采用随机水平翻转、随机裁剪(填充10像素)和随机擦除进行数据增强.使用Adam(Adaptive Mo- ment Estimation)优化器进行端到端训练, 设置初始学习率为3.5× 10⁻⁴, 权重衰减系数为5× 10⁻⁴, 批次大小为128, 共计训练160轮.
关键超参数的选择依据如下.原型数量P(P=7)对应人体自然部位划分(头、上胸、下胸、腰、上腿、下腿、脚), 为经验取值.邻域损失的正邻域近邻数M=4、正邻域距离阈值margin_pos=0.3和负邻域距离阈值margin_neg=0.7均通过验证集网格搜索确定.基于余弦项与均方误差项的等权重实验择优选择双空间一致性损失的平衡系数α =0.6.3项损失权重均设为0.1, 平衡各模块贡献.基于验证集检索性能调优确定校准参数τ =0.5, β =0.8, K=10.DS-VSDA的结果均为3次独立运行(seed=0, 1, 2)的均值± 标准差.
所有实验在单块NVIDIA 4090 GPU上完成.
为了全面评估DS-VSDA的性能, 在SYSU-MM01、RegDB基准数据集上进行实验, 选择如下对比方法:Zero-Padding[4]、AGW[5]、cmGAN[6]、Align-GAN[7]、JSIA-ReID[8]、MCLNet[12]、cm-SSFT[16]、FMC- Net[17]、SMCL[18]、LbA[19]、MAUM[20]、CMGR[21]、CMT[25]、CFET[26]、CM-NAS[27]、MPANet[28]、CIFT[29]、MSCLNet[30]、DDAG[31]、文献[32]方法、NFS[33]、WF-CAMReViT[34]、TNAS[35]、MIP[39]、CSVI[42]、MID(Modality-Adaptive Mixup and Invariant Decomposi-tion)[47]、SAAI[48].
各方法在SYSU-MM01数据集上指标值如表1所示, 表中黑体数字表示最优值, 在与相同实验设置下的SAAI对比时, 所有改进均在同一代码框架和训练协议下复现.
 | 表1 各方法在SYSU-MM01数据集上的指标值 Table 1 Metric values of different methods on SYSU-MM01 dataset % |
由表1可见, DS-VSDA在全场景搜索单样本查询设置下, Rank-1值为75.28%, mAP值为76.45%.在mAP指标上, DS-VSDA(76.45%)与SAAI(77.03%)基本持平, 同时在室内搜索单样本查询和多样本查询设置下取得最优值.在全场景搜索多样本设置下, DS-VSDA的Rank-1值达83.25%, mAP值达82.53%, 相比SAAI, mAP值有所提升.室内搜索模式下DS-VSDA优势更突出:单样本查询设置下Rank-1值为84.07%、mAP值为88.09%, 多样本查询设置下两项指标分别达到91.87%和92.19%, 在所有设置下均取得具有竞争力的性能.相比CIFT、CMT、MAUM、MIP等前沿方法, DS-VSDA的mAP值更高, 综合检索精度优势显著.尽管MSCLNet在全场景搜索单样本查询设置下的Rank-1指标(76.99%)略高, 但mAP值为71.64%, 低于DS-VSDA.总之, DS-VSDA在Rank-1、mAP指标上均保持较高水平, 检索性能更均衡稳健.
各方法在RegDB数据集上的指标值如表2所示, 表中黑体数字表示最优值.由表可见:DS-VSDA在可见光-红外检索模式下, Rank-1值为91.52%、mAP值为92.35%; 红外-可见光检索模式下, Rank-1值为92.91%, mAP值为93.81%.两个检索方向的mAP值均为最优值.
| 表2 各方法在RegDB数据集上的指标值 Table 2 Metric values of different methods on RegDB dataset % |
相比SAAI, DS-VSDA在可见光-红外、红外-可见光两个方向上的mAP值分别提升0.90%和1.80%, 改进幅度大于在SYSU-MM01数据集上的效果, 由此验证DS-VSDA在受控场景中的突出优势.尽管CMT在可见光-红外模式下的Rank-1值高达95.17%, 高于DS-VSDA, 但mAP值为87.30%, 低于DS-VSDA.对比实验验证双空间一致性约束与匹配动态校准机制对排序质量的优化效果.
DS-VSDA的总参数量为57.99 M(其中可训练部分参数量为45.01 M), 相比SAAI, 参数量增加约1.05 M, 增量主要来源于浅层特征提取模块.新增的浅层特征提取模块引入约1.06 M的额外参数量, 包括:浅层特征提取器中的1× 1卷积层(参数量约为0.26 M)和批归一化层(可忽略), 而语义驱动的原型动态锚定模块(SPDA)、跨样本邻域关联损失(NRL)及双空间推理阶段的瓶颈层均不引入额外参数.
为了验证DS-VSDA中各模块的有效性及其协同效果, 在SYSU-MM01、RegDB数据集上进行逐步叠加的消融实验.
以SAAI作为基线方法, 依次引入模态注意力模块(MAM)、视觉语义驱动的原型动态锚定模块(SPDA)、跨样本邻域关联损失(NRL)、双空间一致性约束与匹配动态校准机制(DSCC), 观察性能的增量变化.相应消融实验结果如表3和表4所示, 表中黑体数字表示最优值.
| 表3 各模块在SYSU-MM01数据集上的消融实验结果 Table 3 Ablation experiment results of different modules on SYSU-MM01 dataset % |
| 表4 各模块在RegDB数据集上的消融实验结果 Table 4 Ablation experiment results of different modules on RegDB dataset % |
由表3可见, 在全场景搜索模式单样本查询设置下, DS-VSDA的Rank-1值为75.28%, mAP值为76.45%, 均未超越添加MAM的SAAI(75.90%, 77.03%), 这是因为DS-VSDA在该设置下的客观局限性.具体而言, SPDA单独使用时Rank-1值为75.61%(仅比添加MAM的SAAI减少0.29%), 表明人体部位空间先验在室外复杂场景中的偏差影响相对有限.进一步叠加NRL后, Rank-1值降至75.30%, 再叠加DSCC后Rank-1值降至75.28%, 说明NRL的邻域约束和DSCC的校准惩罚在这一协议下产生额外的负面作用, 3个模块在全场景搜索单样本设置下呈现一定的负协同效应.造成该现象的原因可能在于:1)全场景搜索单样本查询设置下要求根据单幅红外图像在可见光图库中检索唯一匹配结果, 检索空间较大且单样本信息有限, 任何额外的特征约束都可能进一步压缩特征空间的灵活性; 2)NRL的绝对距离阈值约束与DSCC的惩罚机制在多样性场景中可能对部分原本正确的跨模态匹配产生误约束.相比之下, 室内搜索模式下摄像头角度和拍摄距离相对固定, 上述约束的负面影响基本消失, 各模块转为正向增益.
在其它3组评估设置下, 各模块均呈现清晰的正向增益:在全场景搜索多样本查询设置下, 仅使用SPDA, Rank-1值从82.86%升至82.92%, 添加NRL后进一步升至83.12%, 再添加DSCC后达到83.25%; mAP值从82.39%逐步升至82.53%.在室内搜索模式单样本查询设置下, 增益最显著.仅使用SPDA使Rank-1值从83.20%升至83.64%, mAP值从88.01%升至88.19%.添加NRL后, mAP值进一步升至88.58%.再添加DSCC后, Rank-1值达到84.07%, mAP值达到88.09%.室内搜索模式下3个模块的递进增益完整且一致, 由此验证在姿态变化较小、场景相对受控的条件下各模块设计充分有效.室内搜索多样本查询设置下增益最大.仅使用SPDA使Rank-1值从90.73%升至91.46%, 添加NRL后升至91.67%, 再添加DSCC后达到91.87%; mAP值也从91.30%升至92.19%.单独添加NRL和DSCC后的指标值均低于SAAI, 由此验证递进式设计的必要性.NRL和DSCC需SPDA提供的结构化部件语义作为特征基础.添加NRL+DSCC后的指标值低于所有含SPDA的配置, 这从反面验证SPDA的作用.添加MAM后Rank-1、mAP指标值均有所上升, 这进一步确认MAM的基础性贡献.
由表4可见, 两个检索方向上各模块均呈现代际递增趋势, mAP指标值累计增益达1.80%.各模块在RegDB数据集受控环境下的平滑递增与SYSU-MM01数据集室内场景中的显著增益共同验证各模块设计的合理性与有效性.
在推理阶段, 双空间匹配动态校准需要额外计算浅层特征的余弦相似度矩阵, 复杂度为O(Nq· Ng· D), 其中, Nq表示查询图像数量, Ng表示图库图像数量, D表示特征维度, 这与深层检索的矩阵乘法复杂度相同.在SYSU-MM01全测试集(单块RTX 4090, 查询集3 803幅, 图库集6 775幅)上实测, ResNet特征提取耗时约6.5 s(查询集上耗时2.4 s、图库集上耗时4.1 s), 双空间矩阵乘法与校准耗时仅需约0.031 s, 占总推理时间的0.5%.其中浅层特征的额外矩阵乘法约0.013 s, 仅占总推理时间的0.2%.该类额外开销极小, 且可通过特征降维或近似近邻搜索进一步降低.
为了直观展示DS-VSDA的有效性, 从注意力图对比、检索结果对比、特征分布可视化及双空间一致性这4个方面进行定性分析.
2.5.1 注意力图可视化
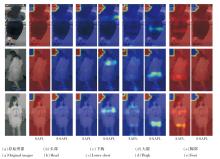
为了验证SPDA的有效性, 将原始SAFL(Seman-tic-Aligned Feature Learning)与SPDA在SYSU-MM01测试集上的注意力响应进行可视化对比, 在可见光模态与红外模态下, 选取4个人体部位原型(头部、下胸、大腿、脚部), 相应注意力热力图如图4所示.由图可观察到, SAFL的注意力响应呈现明显的弥散现象:各部位原型的激活区域存在大面积重叠, 尤其在下胸、大腿处原型响应难以区分.这一现象表明,
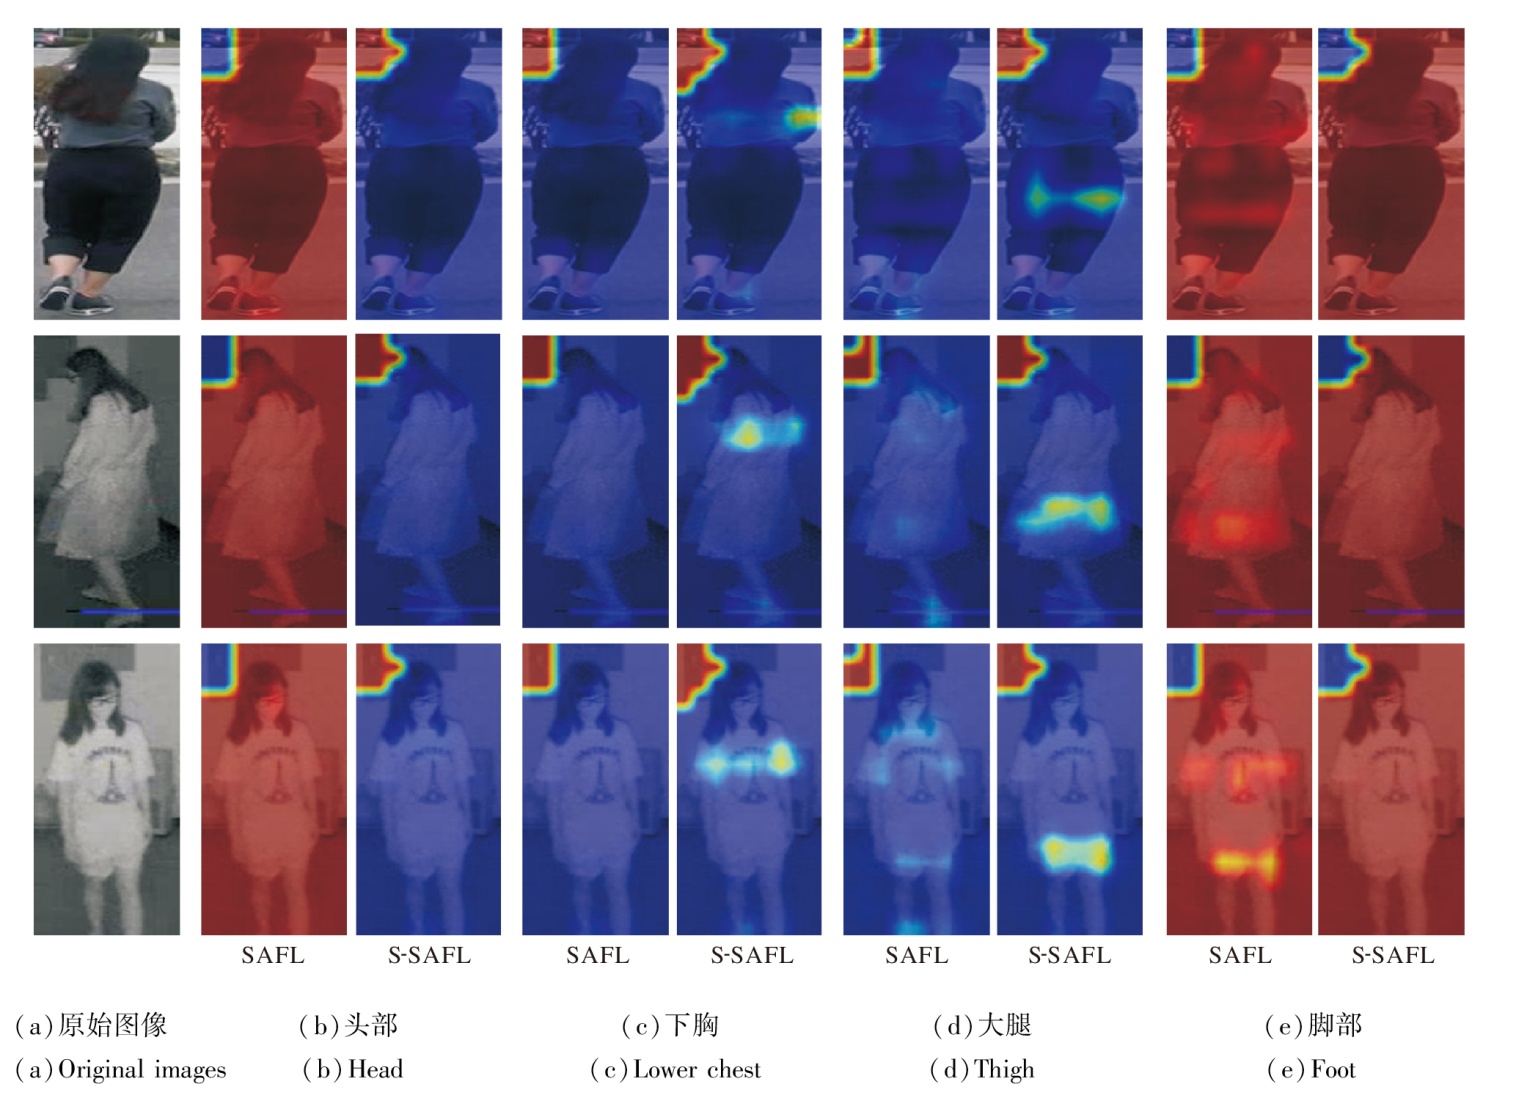 | 图4 原型注意力可视化图Fig.4 Prototype attention visualization |
随机初始化的原型在收敛后仍缺乏对人体结构的清晰语义对应.相比之下, SPDA通过位置先验软初始化和原型间互斥损失, 显著改善注意力分配的空间精度.在下胸等相邻区域, 注意力图呈现更高的空间聚焦度, 重叠区域明显减小.这一结果验证位置先验初始化为原型学习提供合理的起点, 而互斥损失进一步约束原型间的注意力竞争, 使各原型形成语义一致的空间分区.上述改善在红外模态下同样显著, 说明SPDA学习的人体结构先验具有跨模态泛化能力.
2.5.2 双空间特征激活区域可视化
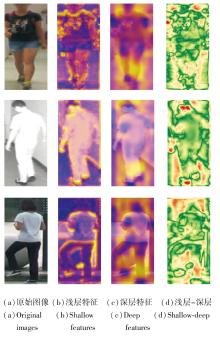
为了直观展示浅层细节空间与深层语义空间在空间区域级别的一致性与差异, 对浅层特征和深层特征在可见光图像与红外图像上的特征激活区域分布进行可视化, 结果如图5所示.在图中, 第2列为浅层特征激活图, 第3列为深层特征激活图, 第4列为两者的空间一致性度量, 绿色表示双空间高度一致, 红色表示双空间存在分歧.
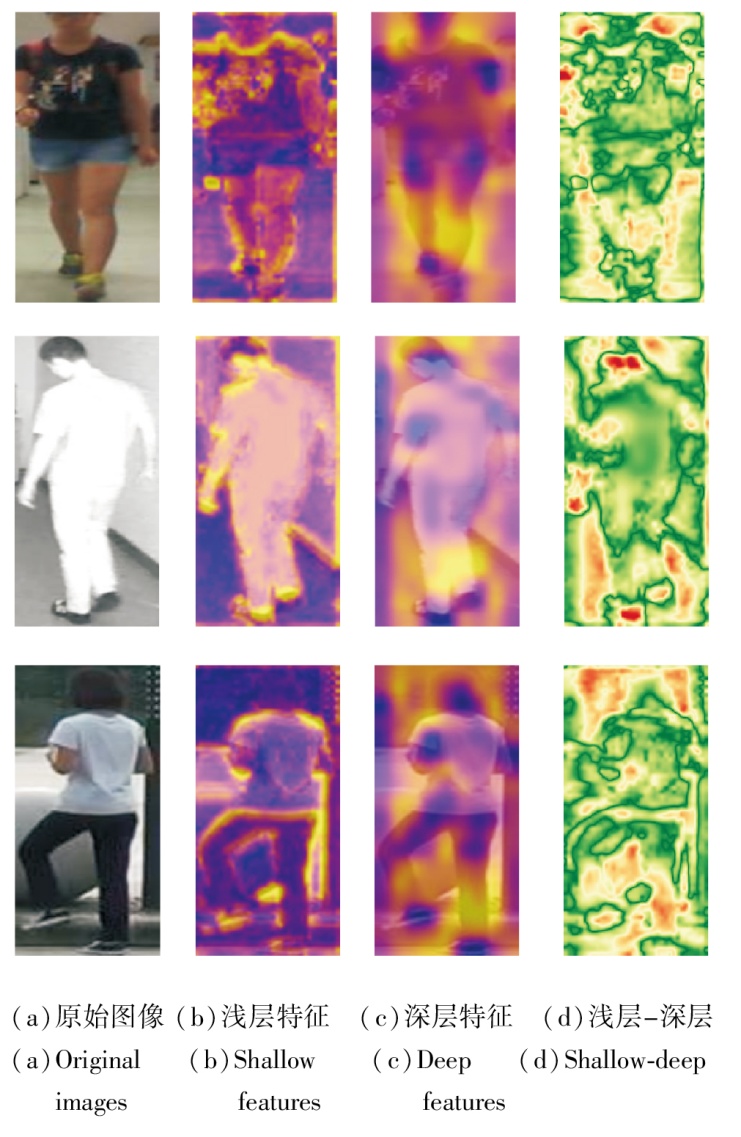 | 图5 双空间一致性可视化图Fig.5 Dual-space regional consistency visualization |
由图5可观察到, 浅层特征的激活主要分布于行人的轮廓边缘和纹理丰富区域, 空间模式细粒度较高、响应分散, 体现浅层网络对跨模态不变的低级结构信息的敏感性.深层特征的激活聚焦于行人的整体语义区域, 空间模式较平滑和集中, 体现深层网络对高层身份语义信息的抽象能力.
一致性图显示:在行人身体区域(躯干、腿部), 浅层特征与深层特征呈现较高的一致性, 训练约束使两个空间在语义相关的身体区域形成统一的特征表达, 由此验证双空间一致性损失的有效性.
2.5.3 双空间一致性分析
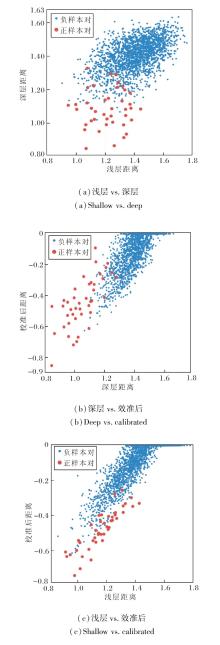
为了验证双空间一致性约束与匹配动态校准机制(DSCC)的实际效果, 对比分析浅层细节空间、深层语义空间及校准后的距离排序结果, 具体如图6所示.
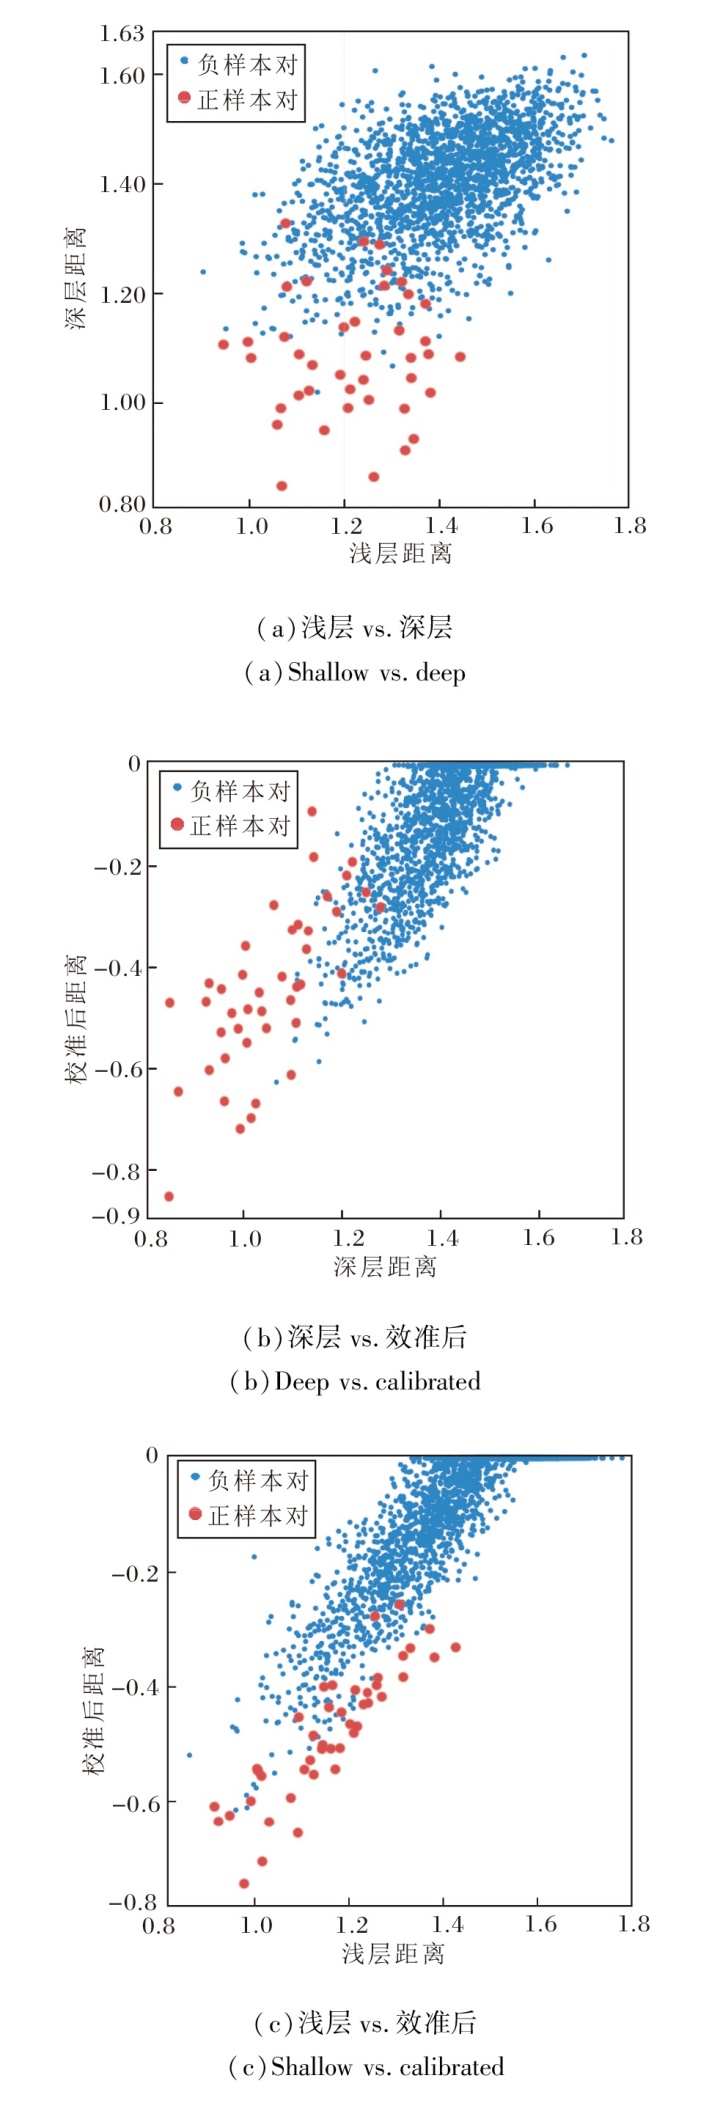 | 图6 双空间距离相关性散点图及匹配校准效果图Fig.6 Scatter plots of dual-space distance correlation and matching calibration effect |
由图6(a)所示, 浅层特征与深层特征的检索排序存在明显差异.浅层特征倾向于匹配低级纹理与局部轮廓模式, 深层特征则聚焦于行人的高级语义身份信息.若仅依赖单一空间的排序结果, 当两者判断出现分歧时, 容易产生匹配错误.DSCC引入一致性门控进行融合修正, 增强深浅层判断一致样本的匹配置信度, 惩罚分歧样本以过滤噪声, 实现更鲁棒的跨模态匹配.统计显示, 测试集上共有138个查询样本的Rank-1值, 经校准后从深层空间的错误匹配修正为正确匹配.
图6(b)、(c)分别给出浅层距离与深层距离、校准后距离的相关性散点分布.正样本对(红色)与负样本对(蓝色)在浅层-深层距离空间中整体呈现正相关, 但两类样本的分布区域存在明显重叠.经DSCC校准后, 正样本对的距离下降幅度显著大于负样本对, 使得正负样本在校准距离维度上的可分性明显提升.可视化结果验证DSCC可有效融合深浅层特征的互补信息, 提升匹配决策的可靠性.
在SYSU-MM01数据集上对NRL及SPDA中4个核心参数进行单变量敏感性分析.各参数在默认值附近变化时, 其余参数保持为默认值.实验采用全场景搜索多样本查询(10-shot)设置, 以Rank-1和mAP作为评估指标.
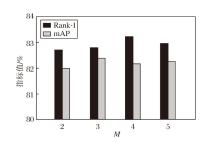
定义正邻域近邻数M=2, 3, 4, 5, 其对DS-VSDA性能的影响如图7所示, 由图可见, M从2增至4时, Rank-1值从82.68%逐步升至83.22%, mAP值在M=3时达到最高(82.37%), M=5时性能略有回落.M过小, 正邻域信息不足, 难以充分建模类内拓扑; M过大, 引入语义较远的同身份样本, 弱化近邻约束的聚焦性.M=4时方法在Rank-1指标上表现最优.
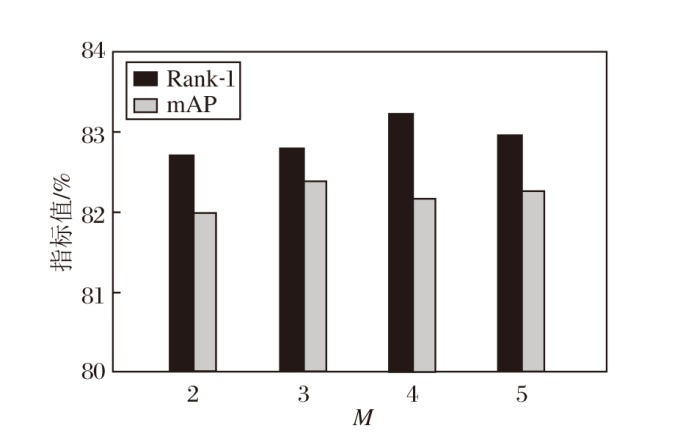 | 图7 M对DS-VSDA性能的影响Fig.7 Effect of M on DS-VSDA performance |
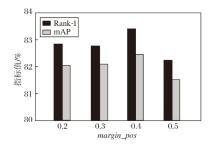
定义正邻域距离阈值margin_pos=0.2, 0.3, 0.4, 0.5, 其对DS-VSDA性能的影响如图8所示, 由图可见, margin_pos从0.2增至0.4时, 性能持续提升(Rank-1值从82.85%升至83.41%, mAP值从82.05%升至82.46%).margin_pos=0.5时性能出现下降.过小的margin_pos对正样本聚合施加不切实际的紧约束, 使方法难以收敛到有效解; 过大的margin_pos使约束过度松弛, 失去正则化效果.默认值margin_pos=0.3虽非最优, 但与最优值0.4的性能差距在0.6%以内.
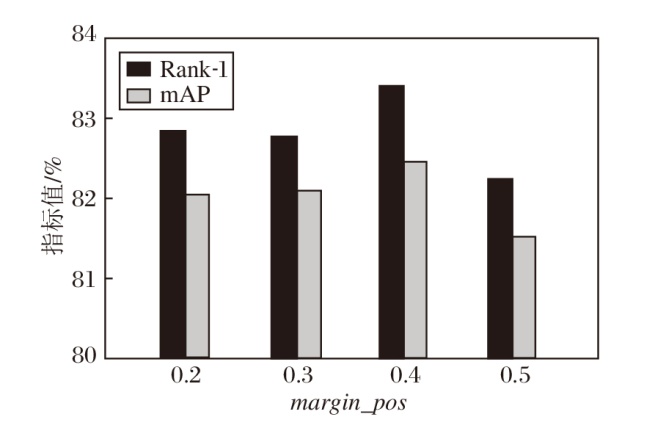 | 图8 margin_pos对DS-VSDA性能的影响Fig.8 Effect of margin_pos on DS-VSDA performance |
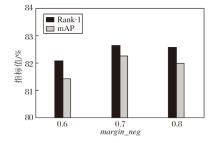
定义负邻域距离阈值margin_neg=0.6, 0.7, 0.8, 其对DS-VSDA性能的影响如图9所示, 由图可见, margin_neg从0.6增至0.7时, Rank-1值从82.09%升至82.65%, margin_neg=0.8时Rank-1值回落至82.58%.margin_neg 控制负样本与锚点之间需要保持的最小距离.该值过小时, 与锚点外观相近的难分负样本被推离得不够远, 仍容易被误判为正样本; 该值过大时, 又会把这些本应保留一定相似性的负样本强制推得过远, 使特征空间过度拉伸, 反而破坏样本间原有的邻近关系.margin_neg=0.7时方法在两个指标上均为最优值.
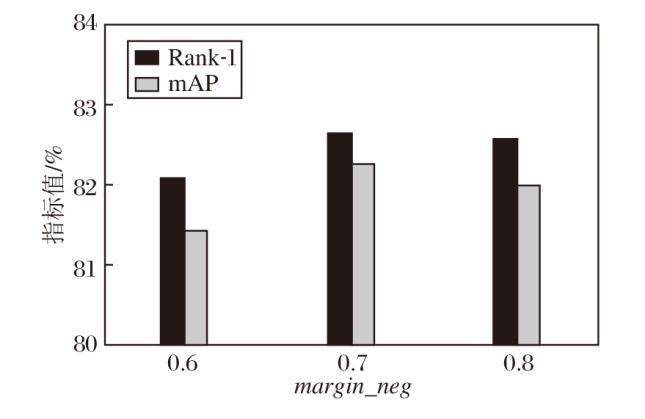 | 图9 margin_neg对DS-VSDA性能的影响Fig.9 Effect of margin_neg on DS-VSDA performance |
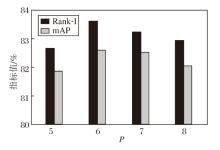
定义SPDA原型数量P=5, 6, 7, 8, 其对DS-VSDA性能的影响如图10所示, 由图可见, P=6时Rank-1、mAP指标均达到峰值(83.62%和82.61%), P=5和P=8时性能均有所下降.P过少则空间粒度不足, 难以精细捕捉不同人体部位的语义差异; P过多则引入冗余部件, 原型间语义重叠增加.默认值P=7与最优值P=6的性能差距很小(Rank-1值差0.4%), 均在合理范围内.
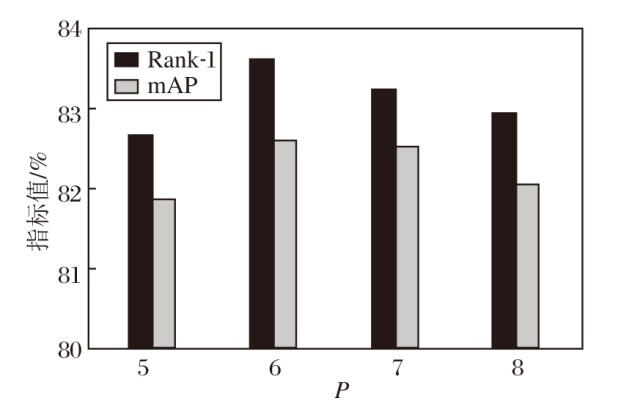 | 图10 P对DS-VSDA性能的影响Fig.10 Effect of P on DS-VSDA performance |
综合上述分析可知, 4个参数在默认值附近时方法均处于性能较优的区间, Rank-1波动幅度最大不超过1.5%, mAP波动幅度最大不超过1.2%.参数敏感性分析验证本文超参数选择的合理性:默认值均位于或接近于各参数空间内的最优区域.
针对可见光-红外行人重识别的模态异质性与场景干扰问题, 本文提出基于视觉语义动态锚定的双空间约束可见光-红外行人重识别方法(DS-VS-DA), 通过语义驱动的原型动态锚定模块(SPDA)、跨样本邻域关联学习损失(NRL)、双空间一致性约束与匹配动态校准机制(DSCC), 分别解决局部语义对齐不准、特征判别性不足、单空间匹配易受噪声影响的难题.实验表明, DS-VSDA在SYSUMM-01数据集室内搜索场景和RegDB数据集上取得具有竞争力的性能, 尤其在RegDB数据集的两个检索方向上mAP值均为最优, 由此验证方法的有效性.消融实验与可视化结果验证方法的合理性与先进性.DS-VSDA为全天候跨模态行人检索提供有效技术路径.今后可从如下方向进行改进:1)探索自适应原型数量选择机制, 根据输入图像的行人姿态和遮挡程度动态调整部位划分粒度, 缓解固定位置先验在极端姿态下的局限性; 2)研究基于视觉-语言模型(如CLIP(Contrastive Language-Image Pre-training))的语义属性引导, 对齐行人属性文本描述与视觉部件特征, 进一步提升跨模态部件语义的判别性; 3)设计轻量化双空间校准策略, 如在推理阶段通过知识蒸馏将浅层特征信息迁移至深层空间, 从而在保持校准效果的同时降低推理计算开销.
本文责任编委 黄华
Recommended by Associate Editor HUANG Hua
| [1] |
|
| [2] |
|
| [3] |
|
| [4] |
|
| [5] |
|
| [6] |
|
| [7] |
|
| [8] |
|
| [9] |
|
| [10] |
|
| [11] |
|
| [12] |
|
| [13] |
|
| [14] |
|
| [15] |
|
| [16] |
|
| [17] |
|
| [18] |
|
| [19] |
|
| [20] |
|
| [21] |
|
| [22] |
|
| [23] |
|
| [24] |
|
| [25] |
|
| [26] |
|
| [27] |
|
| [28] |
|
| [29] |
|
| [30] |
|
| [31] |
|
| [32] |
|
| [33] |
|
| [34] |
|
| [35] |
|
| [36] |
|
| [37] |
|
| [38] |
|
| [39] |
|
| [40] |
|
| [41] |
|
| [42] |
|
| [43] |
|
| [44] |
|
| [45] |
|
| [46] |
|
| [47] |
|
| [48] |
|