

多阶段感知引导的概念漂移自适应集成
[郭虎升1, 2, 3  , 王瑶
1 , 张旭1 , 郑温冬1 , 许行1, 2 , 王文剑2, 3 ]
, 王瑶, 张旭, 郑温冬, 许行, 王文剑]
|
|


作者简介:
郭虎升,博士,教授,主要研究方向为数据挖掘、机器学习、深度学习等.E-mail:guohusheng@sxu.edu.cn.
王 瑶,硕士研究生,主要研究方向为数据挖掘.E-mail:202424312035@sxu.edu.cn.
张 旭,硕士研究生,主要研究方向为数据挖掘.E-mail:zx011002@163.com.
郑温冬,博士,讲师,主要研究方向为时序预测、噪声鲁棒性等.E-mail:wendongz@sxu.edu.cn.
许 行,博士,副教授,主要研究方向为数据挖掘、机器学习等.E-mail:hxu@sxu.edu.cn.
概念漂移是开放环境下流数据挖掘任务中影响模型性能提升的关键因素之一.由于流数据分布持续演化,历史数据与当前数据分布之间存在差异,导致历史信息难以被充分利用,从而影响模型性能的稳定性与对漂移的适应性.为此,文中提出多阶段感知引导的概念漂移自适应集成方法.根据模型在连续数据块上的表现进行时序分型,选择与当前分布一致的关键历史数据,并结合损失序列与显著性检验对当前数据进行自适应筛选,通过时序感知对样本进行动态重构.同时,结合损失下降率设计动态集成停止准则,通过漂移感知调节集成过程,依据漂移强度构建自适应集成模型,实现数据与模型的有效协同.实验表明,文中方法能有效利用历史数据,在提升漂移适应性的同时,获得良好的泛化性能.
About Author:
GUO Husheng, Ph.D., professor. His re-search interests include data mining, machine learning and deep learning.
WANG Yao, Master student. Her research interests include data mining.
ZHANG Xu, Master student. Her research interests include data mining.
ZHENG Wendong, Ph.D., lecturer. His research interests include time series forecas-ting and noise robustness.
XU Hang, Ph.D., associate professor. Her research interests include data mining and machine learning
Concept drift is a critical factor that limits the performance improvement of models in data stream mining tasks in open environments. Due to the continuous evolution of data distributions in data streams, the discrepancies between historical and current data distributions result in difficulties in fully exploiting historical knowledge, thereby undermining model stability and adaptability to drifting environments. To address this issue, a multi-stage perception guided adaptive ensemble for concept drift(MPAE) is proposed. Temporal profiling based on model performance over consecutive data blocks is performed, and the key historical data consistent with the current distribution are selected accordingly. Loss sequences and statistical significance testing are further combined to adaptively filter current data. Dynamic sample reconstruction is conducted based on temporal perception. In addition, a dynamic ensemble stopping criterion is designed based on the loss decay rate, allowing drift-perception adjustment of the ensemble process. According to the estimated drift intensity, an adaptive ensemble model is constructed to achieve effective coordination between the data and the model. Experiments demonstrate that MPAE exploits the historical data effectively, improves the drift adaptability of the model, and achieves favorable generalization performance.
在大数据时代, 各类应用系统持续产生大量的动态数据, 如电子商务交易记录、智慧城市监控数据、病毒传播数据、网页点击数据等.相比传统静态数据, 动态数据具有连续产生、高速到达和实时变化等特点, 被称为流数据[1, 2].流数据挖掘旨在构建能适应数据分布变化的学习模型, 提升预测性能.
概念漂移是流数据的一个重要特性, 也是流数据挖掘的主要挑战之一, 典型特点是数据分布会随着环境因素的变化而发生改变[3, 4].当概念漂移发生时, 原有模型难以适应新的数据环境, 导致历史数据难以得到有效利用, 降低模型的实时学习性能.因此, 构建具备动态适应能力的学习模型成为流数据挖掘的核心任务之一, 可应对数据分布变化带来的预测性能退化问题[5].
目前, 在线学习方法广泛应用于流数据挖掘任务中, 在处理动态数据和应对概念漂移方面取得一定的研究进展[6].然而, 当数据分布持续变化时, 受更新机制的影响, 方法在历史信息利用和动态调整能力方面仍存在一定局限, 导致对新数据环境的适应能力不足.在概念漂移发生后, 如何有效利用历史数据信息并合理调整模型规模, 提升稳定性与适应能力, 仍是流数据学习领域亟待解决的问题之一.
为了解决上述问题, 本文提出多阶段感知引导的概念漂移自适应集成方法(Multi-stage Perception Guided Adaptive Ensemble for Concept Drift, MPAE).首先, 基于集成模型在连续数据块上的表现, 评估历史数据与当前数据的匹配程度, 结合漂移检测与损失序列对当前数据进行时序分型.在此基础上结合显著性检验与模型性能变化, 对历史样本进行动态筛选.然后, 基于漂移强度确定目标集成规模, 结合损失下降率构建动态集成停止准则, 实现集成模型规模的自适应调整, 提升方法在动态环境下的适应性与稳定性.
目前, 集成学习在处理概念漂移方面得到广泛应用.此类方法通过某种组合策略将多个弱学习器构建为具有较优预测性能的强学习器.根据学习方式的不同, 相关方法主要分为基于块的集成方法和基于在线学习的集成方法.
基于块的集成方法通常将数据流划分为等长的数据片段, 结合漂移检测机制与周期性模型更新实现概念漂移适应.Lu等[7]提出ACDWM(Adaptive Chunk-Based Dynamic Weighted Majority), 为每个数据块训练独立的基学习器, 依据其在流环境中的实时表现动态调整权重, 并基于假设检验自适应确定最佳数据块规模.Weinberg等[8]提出EnHAT(En-semble Combined with Hoeffding Adaptive Tree), 结合Hoeffding自适应树与基于数据块生成的决策树, 通过两类模型的协同学习, 提升对概念漂移的适应速度.Li等[9]提出DUE(Dynamic Updated Ensemble), 为每个数据块创建若干候选分类器, 并进行分段加权, 动态调整分类器权重, 应对概念漂移问题.Woź niak等[10]提出AWAE(Active Weighted Aging Ensemble), 通过基学习器的权重老化机制动态调整集成模型规模, 对概念漂移做出自适应响应.上述方法通常以数据块作为基本处理单元, 难以区分数据块内部的新旧概念样本.当概念漂移发生在数据块内部时, 包含过时概念的历史样本仍可能参与训练, 影响方法对当前数据分布的适应能力.
基于在线学习的集成方法通过逐个数据实时更新集成模型, 按照时间顺序持续优化基学习器权重或替换基学习器.Guo等[11]提出Targeted EL(Tar-geted Ensemble Learning), 针对不同类型的概念漂移, 设计样本加权与基分类器选择机制, 并通过动态权重调整实现对数据流变化的在线自适应, 提升方法的准确性与多样性.Barboza等[12]提出IncA-DES(Incremental Adaptive Dynamic Ensemble Selection), 采用增量式动态集成选择策略, 结合在线K-d树邻域搜索, 动态选择基分类器, 适应概念漂移.Li等[13]提出DDG-DA(Data Distribution Generation for Predic-table Concept Drift Adaptation), 结合历史数据重采样与漂移数据建模, 动态更新学习器的训练样本, 通过分布生成方式提升对概念漂移的适应能力.Guo等[14]提出SEOA(Selective Ensemble-Based Online Adap-tive Deep Neural Network), 构建在线自适应深度神经网络, 以网络内部的自适应深度单元作为候选基学习器, 根据其在当前数据流上的性能动态选择基学习器并加权融合, 提升概念漂移下模型的分类性能.上述方法能根据数据流变化及时调整模型, 适应过程主要集中于在线学习器权重更新与分类器选择.不同程度的概念漂移对集成模型规模的需求存在差异, 缺乏针对漂移强度的规模调节, 容易导致方法表征能力不足或产生冗余.
除了上述集成学习方法以外, 时间序列模型、持续学习方法和深度学习方法也被用于概念漂移场景.Zhou等[15]提出Informer, Nie等[16]提出PatchTST(Patch Time Series Transformer), 都利用注意力机制与时序分块等方式挖掘数据中的长期依赖关系, 为适应动态数据环境提供有效的时序表征能力.Buzzega等[17]提出DER++(Dark Experience Replay++), 作为持续学习方法, 通过经验回放与历史样本复用, 缓解持续学习过程中的灾难性遗忘问题.DNN(Deep Neural Network)[18]、Highway Networks[19]、HBP(Hedge Backpropagation)[20]、ResNet(Residual Net-work)[21]和DenseNet(Dense Convolutional Network)[22]等深度学习方法主要通过模型参数更新、深层特征表征实现环境适应, 在利用多个模型的互补信息及根据漂移状态动态调整模型结构方面存在一定局限性.
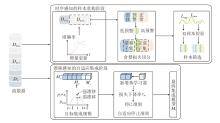
本文提出多阶段感知引导的概念漂移自适应集成方法(MPAE), 总体架构如图1所示.首先, 在时序感知的样本重构阶段, 根据不同历史数据块训练得到的模型在当前数据块上的预测性能, 选择与当前数据分布一致的历史样本, 同时结合损失序列对预警数据进行时序划分, 完成样本的动态重构, 然后, 结合统计显著性检验与模型性能变化, 对样本进行保留或舍弃, 实现自适应筛选, 提升模型的适应性.在漂移感知的自适应集成阶段, 根据感知的漂移强度确定目标集成规模, 并结合动态集成停止准则约束集成模型, 动态控制集成规模与模型复杂度, 提升模型的稳定性.
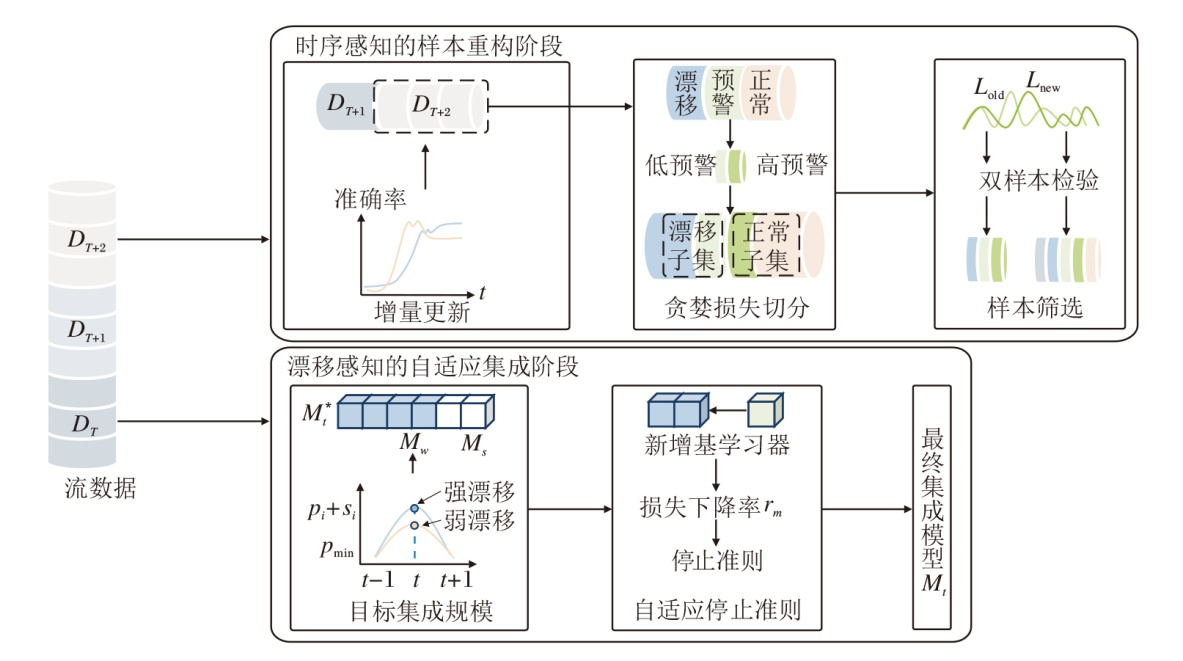 | 图1 MPAE总体架构Fig.1 Overall architecture of MPAE |
为了充分利用历史样本信息并增强对数据分布变化的自适应响应能力, 在时序感知的样本重构阶段, 联合分析历史数据与当前数据, 实现样本的时序分型与动态筛选.
2.1.1 时序分型的样本重构
为了实现有效的样本重构, 需要对数据块进行时序分型, 并选择分布一致的历史数据, 构建数据集.设数据流由一系列数据块
$D_{T}=\left\{\left(\boldsymbol{x}_{i}, y_{i}\right)\right\}_{i=1}^{n}$
组成, 其中, T表示时间步长, xi表示第i个样本的特征向量, yi表示对应的类别标签, n表示数据块样本数量.考虑3个连续的数据块DT、DT+1、DT+2, 假设DT中的数据分布正常, DT+1中发生概念漂移, 而DT+2的分布未知.为了降低概念漂移的影响, 首先将DT和DT+1作为两个独立数据集, 在DT上训练集成模型F0(x), 在DT+1上训练集成模型F1(x), 处理发生概念漂移的数据.当新的数据块DT+2到达时, 在该块上分别评估集成模型F0(x)和F1(x)的预测性能, 得到准确率ac
$a c c_{F_{0}(x)}> a c c_{F_{1}(x)}, $
说明基于旧的数据分布训练的集成模型F0(x)在当前数据上更匹配; 否则说明集成模型F1(x)更适合当前分布.
基于上述判断, 对集成模型F0(x)、F1(x)对应数据集进行有选择地增量更新:如果ac
$\left\{\begin{array}{ll} \widetilde{D}_{0} \leftarrow D_{T} \cup D_{T+2}, & a c c_{F_{0}(x)}> a c c_{F_{1}(x)} \\ \widetilde{D}_{1} \leftarrow D_{T+1} \cup D_{T+2}, & a c c_{F_{0}(x)} \leqslant a c c_{F_{1}(x)} \end{array}\right.$
在数据块内部同时存在旧概念与新概念时, 单纯块级合并难以实现准确学习.因此, 在数据块内部采用DDM(Drift Detection Method)[23], 对数据进行监测, 通过识别预警点与漂移点, 将数据分型为正常数据和漂移数据.
具体地, 从数据块DT+2的第1个样本开始逐条输入集成模型并计算预测错误率, DDM通过2个阈值分别表示预警状态和漂移状态.当模型的预测错误率及其波动范围首次超过预警阈值时, 记录该点为预警点iw; 若后续错误率继续上升并超过漂移阈值, 记录该点为漂移点id.一旦检测漂移点或当前数据块处理完毕进入下一数据块时, DDM的内部统计量(历史最小错误率pmin和标准差smin)被立即重置为当前最新样本的预测错误率.若仅触发预警而未达到漂移状态, 保留预警点, 直至进入下一个新数据块或触发漂移后统一重置.若在一个数据块中检测多次漂移, 仅保留首次出现的漂移点, 其后所有样本全部归为漂移子集.据此, 将数据块DT+2划分为3个子集:正常子集$\left\{\left(x_{i}, y_{i}\right)\right\}_{i=1}^{i_{w}-1}$、预警子集$\left\{\left(x_{i}, y_{i}\right)\right\}_{i=i_{w}}^{i_{d}-1}$和漂移子集$\left\{\left(x_{i}, y_{i}\right)\right\}_{i=i_{d}}^{n}$.
预警子集内部的数据处于概念变化的过渡阶段, 可能包含不同程度的预警样本, 需进一步区分低预警数据和高预警数据.基于模型在样本前缀上的损失序列进行贪婪切分, 使用交叉熵损失作为损失函数.具体而言, 首先在正常子集$\left\{\left(x_{i}, y_{i}\right)\right\}_{\substack{i_{w}-1 \\ i=1}}$上测试集成模型并计算损失Lnormal, 然后按时间顺序逐个加入预警子集中的样本, 计算累积损失序列{
$\left\{\begin{array}{l} \widetilde{D_{0}} \leftarrow D_{T} \cup\left\{\left(x_{i}, y_{i}\right)\right\}_{i=1}^{i_{w}-1} \cup\left\{\left(x_{i}, y_{i}\right)\right\}_{i=i_{w}}^{i_{w}+\eta} \\ \widetilde{D_{1}} \leftarrow D_{T+1} \cup\left\{\left(x_{i}, y_{i}\right)\right\}_{\substack{i=i_{w}+\eta+1 \\ i=1}}^{i_{d}-1} \cup\left\{\left(x_{i}, y_{i}\right)\right\}_{i=i_{d}}^{n} \end{array}\right.$
其中, id∈ [1, n],
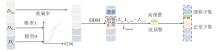
当数据块DT+2在DDM检测下未触发预警状态和漂移状态, 将该数据块视为正常数据, 不进行预警区间划分及相应的样本筛选, 并保持当前集成模型状态.当前数据块处理完成后, 重新初始化DDM, 并对下一数据块重新进行漂移检测.数据集样本重构过程如图2所示.
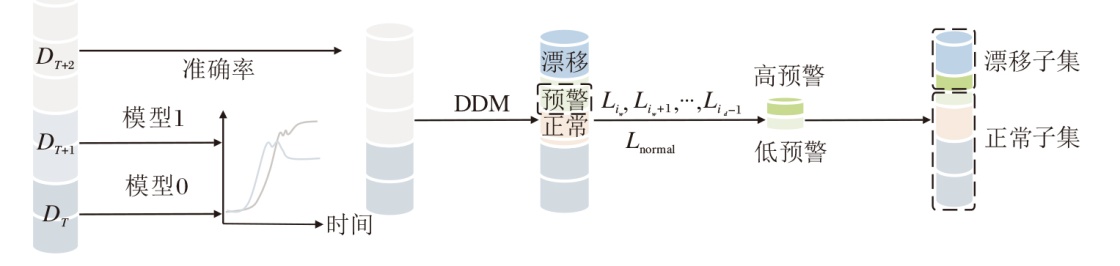 | 图2 样本重构过程Fig.2 Sample reconstruction process |
2.1.2 动态调节的样本筛选
在获得更新后的数据集
$\begin{aligned} I_{\text {lower }} & =\frac{a c c+\frac{z^{2}}{2 n}-z \sqrt{\frac{a c c(1-a c c)}{n}+\frac{z^{2}}{4 n^{2}}}}{1+\frac{z^{2}}{n}}, \\ I_{\text {upper }} & =\frac{a c c+\frac{z^{2}}{2 n}+z \sqrt{\frac{a c c(1-a c c)}{n}+\frac{z^{2}}{4 n^{2}}}}{1+\frac{z^{2}}{n}}, \end{aligned}$
其中, n表示当前数据块中的样本数量, z表示标准正态分布对应的临界值.当置信水平取95%时, z=1.96.置信区间宽度随样本数量和预测准确率的变化自动调整.当样本数量较少时, 置信区间较宽, 降低样本不足导致的历史有效样本被错误筛选的风险.随着样本数量增加, 置信区间逐渐收窄, 提升历史数据有效性判断的准确性.若历史数据对应模型性能低于当前置信区间下限, 认为旧数据块DT已不再适用于当前数据环境, 此时应舍弃该数据块, 仅保留
$L_{\text {old }}=\left\{L_{\text {old }, m}\right\}_{m=1}^{M}, L_{\text {new }}=\left\{L_{\text {new }, m}\right\}_{m=1}^{M}, $
其中M表示基学习器数量.采用双样本K-S检验分析这两组损失序列是否存在显著差异.设原假设H0为新旧数据的损失序列来自相同的概率分布, 备择假设H1为两者来自不同的概率分布.K-S检验通过对比两组样本的经验累积分布函数, 得到检验输出的p值:
$p_{\text {value }} \leftarrow p\left(L_{\text {old }}, L_{\text {new }}\right), $
用于判断是否拒绝原假设H0.将pvalue与显著性水平ρ (取ρ =0.01)进行对比.如果pvalue< ρ , 拒绝原假设H0, 认为DT+1和更新后的
$a c c_{T+2}< a c c_{T+1}-\mu a c c_{T+1}, $
认为概念漂移对模型性能产生明显影响, 此时应舍弃旧数据块DT+1, 仅保留来自DT+2的高预警数据和漂移子集作为
$\widetilde{D}_{1} \leftarrow\left\{\left(x_{i}, y_{i}\right)\right\}_{\substack{i_{d}-1 \\ i=i_{w}+\eta+1}}^{i_{j}-1} \cup\left\{\left(x_{i}, y_{i}\right)\right\}_{i=i_{d}}^{n} .$
反之, 若pvalue≥ ρ , 认为DT+1与更新后的
通过上述统计检验与性能回退的联合判断, 在保留泛化能力与舍弃过时样本之间取得平衡, 增强集成模型在非平稳环境下的适应性与鲁棒性.
在概念漂移的流数据环境中, 固定的模型规模难以适应动态变化的数据分布.当漂移程度较平缓时, 过大的集成规模可能导致模型复杂度过高; 当漂移程度较剧烈时, 较小的集成规模可能无法充分表征新的数据分布特征.
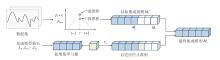
因此, 有必要自适应控制漂移感知的基学习器数量, 使模型规模能随着数据分布变化动态调整, 从而在模型复杂度与学习能力之间取得平衡.集成模型自适应过程如图3所示.
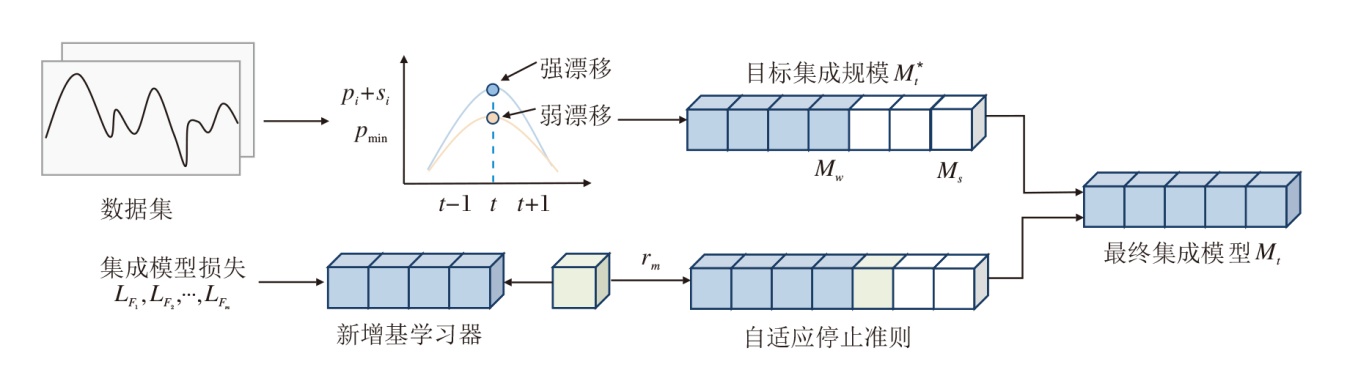 | 图3 集成模型自适应过程Fig.3 Adaptation process of ensemble model |
本文采用多个结构相同但参数独立的多层感知机作为基学习器.每个基学习器分别利用当前筛选后的数据集进行独立优化, 采用Adam(Adaptive Moment Estimation)优化器更新网络参数.当单个基学习器训练完成后, 参数保持固定, 并通过新增基学习器实现数据分布变化下的模型适应.设当前集成模型包含M个基学习器, 第m个基学习器表示为fm(x).本文采用等权融合策略构建最终集成模型, 预测结果如下:
$F(x)=\frac{1}{M} \sum_{m=1}^{M} f_{m}(x) .$
为了在不同漂移感知阶段匹配合适的模型规模, 采用DDM感知数据流的漂移强度.设第i个样本的模型错误率为pi, 对应标准差
$s_{i}=\sqrt{\frac{p_{i}\left(1-p_{i}\right)}{i}}, $
历史最优错误率为pmin, 对应标准差为smin.当满足
$p_{i}+s_{i} \geqslant p_{\min }+2 s_{\min }$
时, DDM进入预警状态, 当前数据分布发生轻微变化, 此时判定为弱漂移阶段; 当满足
$p_{i}+s_{i} \geqslant p_{\min }+3 s_{\min }$
时, DDM判定发生漂移, 当前数据流出现明显概念变化, 此时判定为强漂移阶段.基于不同漂移阶段, 设定目标集成规模:
$M_{t}^{* }=\left\{\begin{array}{ll} M_{s}, & \text { 强漂移 } \\ M_{w}, & \text { 弱漂移 } \end{array}\right.$
其中Ms与Mw分别表示在强漂移阶段与弱漂移阶段允许的最大基学习器数量.
然而, 仅采用预设的集成规模仍可能引入冗余基学习器, 因此, 在达到目标集成规模之前, 进一步引入基于新增基学习器贡献的自适应停止准则, 评估每次新增基学习器对模型性能的实际提升效果, 避免不必要的规模增长.
设由前m个基学习器构成的集成模型为Fm(x), 当新增第m+1个基学习器后, 集成模型更新为Fm+1(x).新增基学习器对整体模型性能的贡献可通过集成模型在当前数据集上的损失变化进行刻画.具体地, 第m+1个基学习器带来的损失下降定义如下:
$\Delta L_{m+1}=L_{F_{m}(x)}-L_{F_{m+1}(x)}, $
其中
为了消除不同训练阶段损失尺度差异对评估结果的影响, 定义损失下降率rm, 用于衡量新增基学习器相对于当前模型状态带来的性能改进幅度, 计算公式如下:
$r_{m}=\frac{\Delta L_{m}}{L_{F_{m-1}(x)}}, $
其中
$r_{m}< \gamma \bar{r}_{1: m-1} .$
当新增基学习器的损失下降率明显低于历史平均下降水平的一定比例时, 认为继续增加基学习器难以获得有效的性能提升, 此时停止追加基学习器.其中, γ ∈ (0, 1)表示比例系数, 用于控制规模扩展的保守程度, 本文取γ =0.9,
因此, 当前数据块对应的最终集成规模由目标集成规模与自适应停止准则共同约束, 即
$M_{t}=\min \left(M_{t}^{* }, \min \left\{m: r_{m}< \gamma \bar{r}_{1: m-1}\right\}\right) .$
这样能保证模型在强漂移阶段充分扩展容量, 在弱漂移阶段或稳定阶段自动抑制冗余基学习器的引入, 在保证预测性能的同时有效控制模型复杂度.
MPAE的实现过程如算法1所示.
算法1 MPAE
输入 数据流S={D1, D2, …, DT+1, DT+2},
漂移性能衰减容忍系数μ ,
规模控制比例系数γ , 显著性水平ρ ,
基学习器规模上限Ms、下限Mw
输出 自适应集成模型
初始化集成模型F0(x)和F1(x);
for DT∈ S do
在DT+2上训练模型得到ac
$\text { if } a c c_{F_{0}(x)}> a c c_{F_{1}(x)} \text { then }$
$\widetilde{D}_{0} \leftarrow D_{T} \cup D_{T+2} ; $
else
$\widetilde{D}_{1} \leftarrow D_{T+1} \cup D_{T+2} ; $
end if
采用DDM检测漂移并进行样本重构;
构造新旧数据集上的损失序列Lold和Lnew;
计算显著性差异pvalue;
$\text { if } p_{\text {value }}< \rho \text { and } a c c_{T+2}< (1-\mu) a c c_{T+1} \text { then }$
$\widetilde{D}_{1} \leftarrow\left\{\left(x_{i}, y_{i}\right)\right\}_{i=i_{w}+\eta+1}^{i_{d}-1} \cup\left\{\left(x_{i}, y_{i}\right)\right\}_{i=i_{d}}^{n} ; $
else
合并新旧数据;
end if
$\text { if } p_{i}+s_{i} \geqslant p_{\min }+2 s_{\min } \text { then }$
判定为弱漂移阶段;
end if
$\text { if } p_{i}+s_{i} \geqslant p_{\min }+3 s_{\min } \text { then }$
判定为强漂移阶段;
end if
根据漂移强度确定目标集成规模
训练基学习器并计算损失下降率rm;
得到自适应停止准则$r_{m}< \gamma \bar{r}_{1: m-1} ; $
得到最终集成规模Mt;
集成模型更新;
输出自适应集成模型;
end for
2.4.1 合理性分析
假设存在3个连续的数据块DT, DT+1, DT+2, 数据块DT完全服从旧概率分布P, DT+2完全服从新概率分布Q, 数据块DT+1中仅有α 的部分服从分布P, 其余1-α 的部分服从分布Q.数据块DT+1的概率分布:
$P^{\prime}=\alpha P+(1-\alpha) Q .$
设学习模型为F(x), 损失函数为L(y, F(x)), 旧概率分布下的真实标签为yP, 新概率分布下的真实标签为yQ.假设数据块内样本相互独立且损失函数满足
$0 \leqslant L(y, F(x)) \leqslant 1 .$
记P、P'、Q的概率密度函数分别为ϕ P(x)、ϕ P'(x)、ϕ Q(x), 则混合分布P'的概率密度函数为:
$\phi_{P^{\prime}}(x)=\alpha \phi_{P}(x)+(1-\alpha) \phi_{Q}(x) .$
模型在概率分布P'下的期望风险为:
$\varepsilon_{P^{\prime}}(F(x))=E_{x \sim P^{\prime}}[L(y, F(x))], $
其中Ex~P'[· ]表示随机变量x服从分布P'时的数学期望.在实际学习中, 通常使用经验误差对真实风险进行估计.对于∀ δ > 0, 模型的真实风险以至少1-δ 的概率满足如下上界:
$\varepsilon_{P^{\prime}}(F(x)) \leqslant \hat{\varepsilon}_{P^{\prime}}(F(x))+\sqrt{\frac{1}{2 n} \ln \left(\frac{1}{\delta}\right)}, $
其中, n表示样本数量,
由于P'为混合分布, 与当前概念分布Q存在一定的分布差异.根据分布差异理论[24], 分布Q与P'的分布差异为:
$d\left(Q, P^{\prime}\right)=\frac{1}{2} \int\left|\phi_{Q}(x)-\phi_{P^{\prime}}(x)\right| \mathrm{d} x .$
同时, 定义历史概念与当前概念之间的标签差异项:
$\Delta=\left|E_{x \sim Q}\left[L\left(y_{Q}, F(x)\right)-L\left(y_{P}, F(x)\right)\right]\right| .$
其中Ex~Q[· ]表示随机变量x服从分布Q时的数学期望.结合期望风险定义, 分布Q的风险为:
$\begin{aligned} \varepsilon_{Q}(F(x))= & E_{x \sim Q}\left[L\left(y_{Q}, F(x)\right)\right]= \\ & E_{x \sim Q}\left[L\left(y_{P}, F(x)\right)\right]+E_{x \sim Q}\left[L\left(y_{Q}, F(x)\right)-L\left(y_{P}, F(x)\right)\right] \leqslant \\ & E_{x \sim Q}\left[L\left(y_{P}, F(x)\right)\right]+\Delta . \end{aligned}$
由于损失函数有界, 分布Q与P'的期望满足
$\begin{array}{l} E_{x \sim Q}\left[L\left(y_{P}, F(x)\right)\right]-E_{x \sim P^{\prime}}\left[L\left(y_{P}, F(x)\right)\right] \leqslant \\ d\left(Q, P^{\prime}\right) \end{array}$
根据分布P'下的期望风险定义, 得
$\varepsilon_{Q}(F(x)) \leqslant \varepsilon_{P^{\prime}}(F(x))+d\left(Q, P^{\prime}\right)+\Delta .$
由于
$P^{\prime}=\alpha P+(1-\alpha) Q, $
分布差异项
$d\left(Q, P^{\prime}\right)=\alpha d(Q, P), $
模型的误差上界
$\begin{array}{l} \varepsilon_{Q}(F(x)) \leqslant \\ \quad \hat{\varepsilon}_{P^{\prime}}(F(x))+\sqrt{\frac{1}{2 n} \ln \left(\frac{1}{\delta}\right)}+\alpha d(Q, P)+\Delta . \end{array}$
若对数据块进行时序切分, 仅保留接近当前概率分布的数据用于训练, 则训练数据主要服从新概率分布Q.切分后有效样本数量为(1-α )n, 模型的误差上界为:
$\varepsilon_{Q^{\prime}}(F(x)) \leqslant \hat{\varepsilon}_{Q}(F(x))+\sqrt{\frac{1}{2(1-\alpha) n} \ln \left(\frac{1}{\delta}\right)} .$
在未进行时序切分时, 模型误差上界包含分布差异项α d(Q, P)和标签差异项Δ , 而在进行时序切分后, 该项可有效消除.当数据块中旧概率分布样本占比较大时, 直接使用全部数据训练会引入较大的分布偏差.通过时序切分可降低旧分布数据的影响, 使训练数据更接近当前分布, 减小模型在新分布下的泛化误差.总之, 对数据块进行时序切分可减少训练数据与当前分布的差异, 使模型更关注当前数据特征, 有助于提升学习鲁棒性.
2.4.2 时间复杂度分析
对于训练过程, 在每个数据块上需要训练多个基学习器.假设模型中单个基学习器的训练时间复杂度为O(h), 且初始训练时有M个基学习器, 则每个时间步的模型训练复杂度为O(Mh).设数据流共有T个时间步, 整个数据流上的模型训练复杂度为O(TMh).
本文采用DDM对数据块中的样本进行在线漂移检测.由于其仅需对每个样本进行在线错误率更新, 对于大小为n的数据块, 复杂度为O(n).整个数据流上的漂移检测复杂度为O(Tn).
在基于损失序列的漂移量化过程中, 需要对预警区间内的损失序列进行贪婪遍历.每个时间点的预警子集大小为id-iw, 因此该过程的时间复杂度为O(T(id-iw)).
在动态调节的样本筛选阶段, 需要对新旧损失序列进行K-S检验.设损失序列长度为基学习器数量M, 则该阶段的复杂度为O(TMlog2M).
综上所述, MPAE在每个时间步主要包含基学习器训练、在线漂移检测、损失序列切分和动态样本筛选.由于预警子集
$i_{d}-i_{w} \leqslant n, $
损失序列切分与漂移检测的复杂度可合并为O(Tn).由此MPAE总体时间复杂度为
$O\left(T\left(M h+n+M \log _{2} M\right)\right) .$
为了验证MPAE的有效性, 选取8个具有不同类型概念漂移的数据集进行实验.从模型精度、收敛速度及不同数据集更新策略对模型影响这3个方面进行评估, 并与15种主流方法进行对比.
实验平台是搭载酷睿i5-8265U和8 GB内存的Window 10系统.MPAE在Python 3.7环境中编写和运行.此外, 所有实验都遵循流数据的标准设置[25], 即每个批次的数据先用于测试模型, 再用于训练模型, 并且每个数据集均按顺序遍历一次.
为了评估MPAE处理不同类型概念漂移的能力, 使用大规模在线分析平台(Massive Online Analysis, MOA)的流数据生成器[26]生成4个具有突变式、渐进式及增量式的合成漂移数据集.此外, 还选取4个真实数据集.数据集具体信息如表1所示.
 | 表1 实验数据集信息 Table 1 Details of experimental datasets |
为了评估MPAE的性能, 主要选择如下指标.
1)平均实时精度(Average Real-Time Accuracy, Avgracc).表示模型在每个时间步的实时精度的平均值, 反映模型的实时性能, 是分类结果的有效衡量标准, 公式如下:
$\text { Avgracc }=\frac{1}{T} \sum_{t=1}^{T}\left(\frac{n_{t}}{n}\right), $
其中, nt表示在t时间步正确分类的样本数量, n表示每个时间步的样本数量, T表示经过的时间步长.平均实时精度越大, 表明模型的分类性能越优.
2)累积精度(Cumulative Accuracy, Cumacc).表示模型在过去Tt时间步中累积预测正确样本数和总样本数的比率, 反映模型在过去所有时间步长的表现, 公式如下:
$\text { Cumacc }=\frac{1}{T_{t} n} \sum_{t=1}^{T_{t}} n_{t}, $
其中Tt表示当前累积的时间步数.
3)模型收敛速度(Recovery Speed under Accu-racy, RSA).表示在概念漂移发生后模型收敛到新分布数据的能力, 公式如下:
$R S A=\text { step } \cdot \text { avge }, $
其中, step表示模型从概念漂移点到收敛点所需的时间步长, avge表示收敛过程中分类错误率的平均值.本文统一设定收敛判定阈值β =0.02.如果一个位点的性能与其后m个参考位点的平均性能之差小于β , 并且参考位点前半部分与后半部分之间的性能差异也小于β , 认为该点为收敛点.公式如下:
$\begin{array}{l} \left|\frac{1}{\left\lfloor\frac{m}{2}\right\rfloor} \sum_{i=1}^{\left\lfloor\frac{m}{2}\right\rfloor} a c c_{t+i}-\frac{1}{m-\left\lceil\frac{m}{2}\right\rceil+1} \sum_{\left\lceil\frac{m}{2}\right\rceil}^{m} a c c_{t+i}\right|< \beta \text { and } \\ \quad\left|a c c_{t}-\frac{1}{m} \sum_{j=1}^{m} a c c_{t+j}\right|< \beta, \end{array}$
其中
$a c c_{t}=\frac{n_{t}}{n} .$
较小的RSA值意味着模型能更快地恢复到漂移前的性能.
为了有效衡量MPAE的分类性能, 选取如下具有代表性的学习方法作为基线模型:IncA-DES[12]、Informer[15]、PatchTST[16]、DER++[17]、DNN[18]、High-way Networks[19]、HBP[20]、ResNet[21]、DenseNet[22]、ARF(Adaptive Random Forest)[27]、DWMIL(Dynamic Weighted Majority for Imbalance Learning)[28]、文献[29]方法、SRP(Streaming Random Patches)[30]、文献[31]方法、ROSE(Robust Online Self-Adjusting Ensemble)[32].所有对比方法均在相同的数据流环境和预处理方式下进行测试, 并采用原始算法推荐的参数设置, 批次大小统一设为100, 隐藏层节点数设为100, 使用ReLU激活函数和0.01的固定学习率.
各方法在不同数据集上的平均实时精度及平均排名情况如表2所示, 表中黑体数字表示最优值, 斜体数字表示次优值.由表可见, MPAE在大多数数据集上取得较优的分类性能, 排名最高.这得益于该方法通过时序分型与动态筛选减少无效历史样本的干扰, 并结合漂移感知自适应调整集成模型, 能快速适应新的数据分布, 从而在概念漂移环境下获得更优的实时分类性能.
| 表2 不同方法在各数据集上的平均实时精度及平均排名 Table 2 Average real-time accuracy and average ranking of different methods on each dataset |
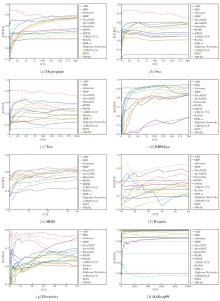
各方法在不同数据集上的累积精度如图4所示, 由图可看出, MPAE在大多数据集上都表现较优.在Sea、Tree、Electricity数据集上, MPAE均取得最高的最终累积精度.这表明在数据分布持续变化时, MPAE能通过样本动态重构有效利用历史数据, 并保持较高的长期分类性能.
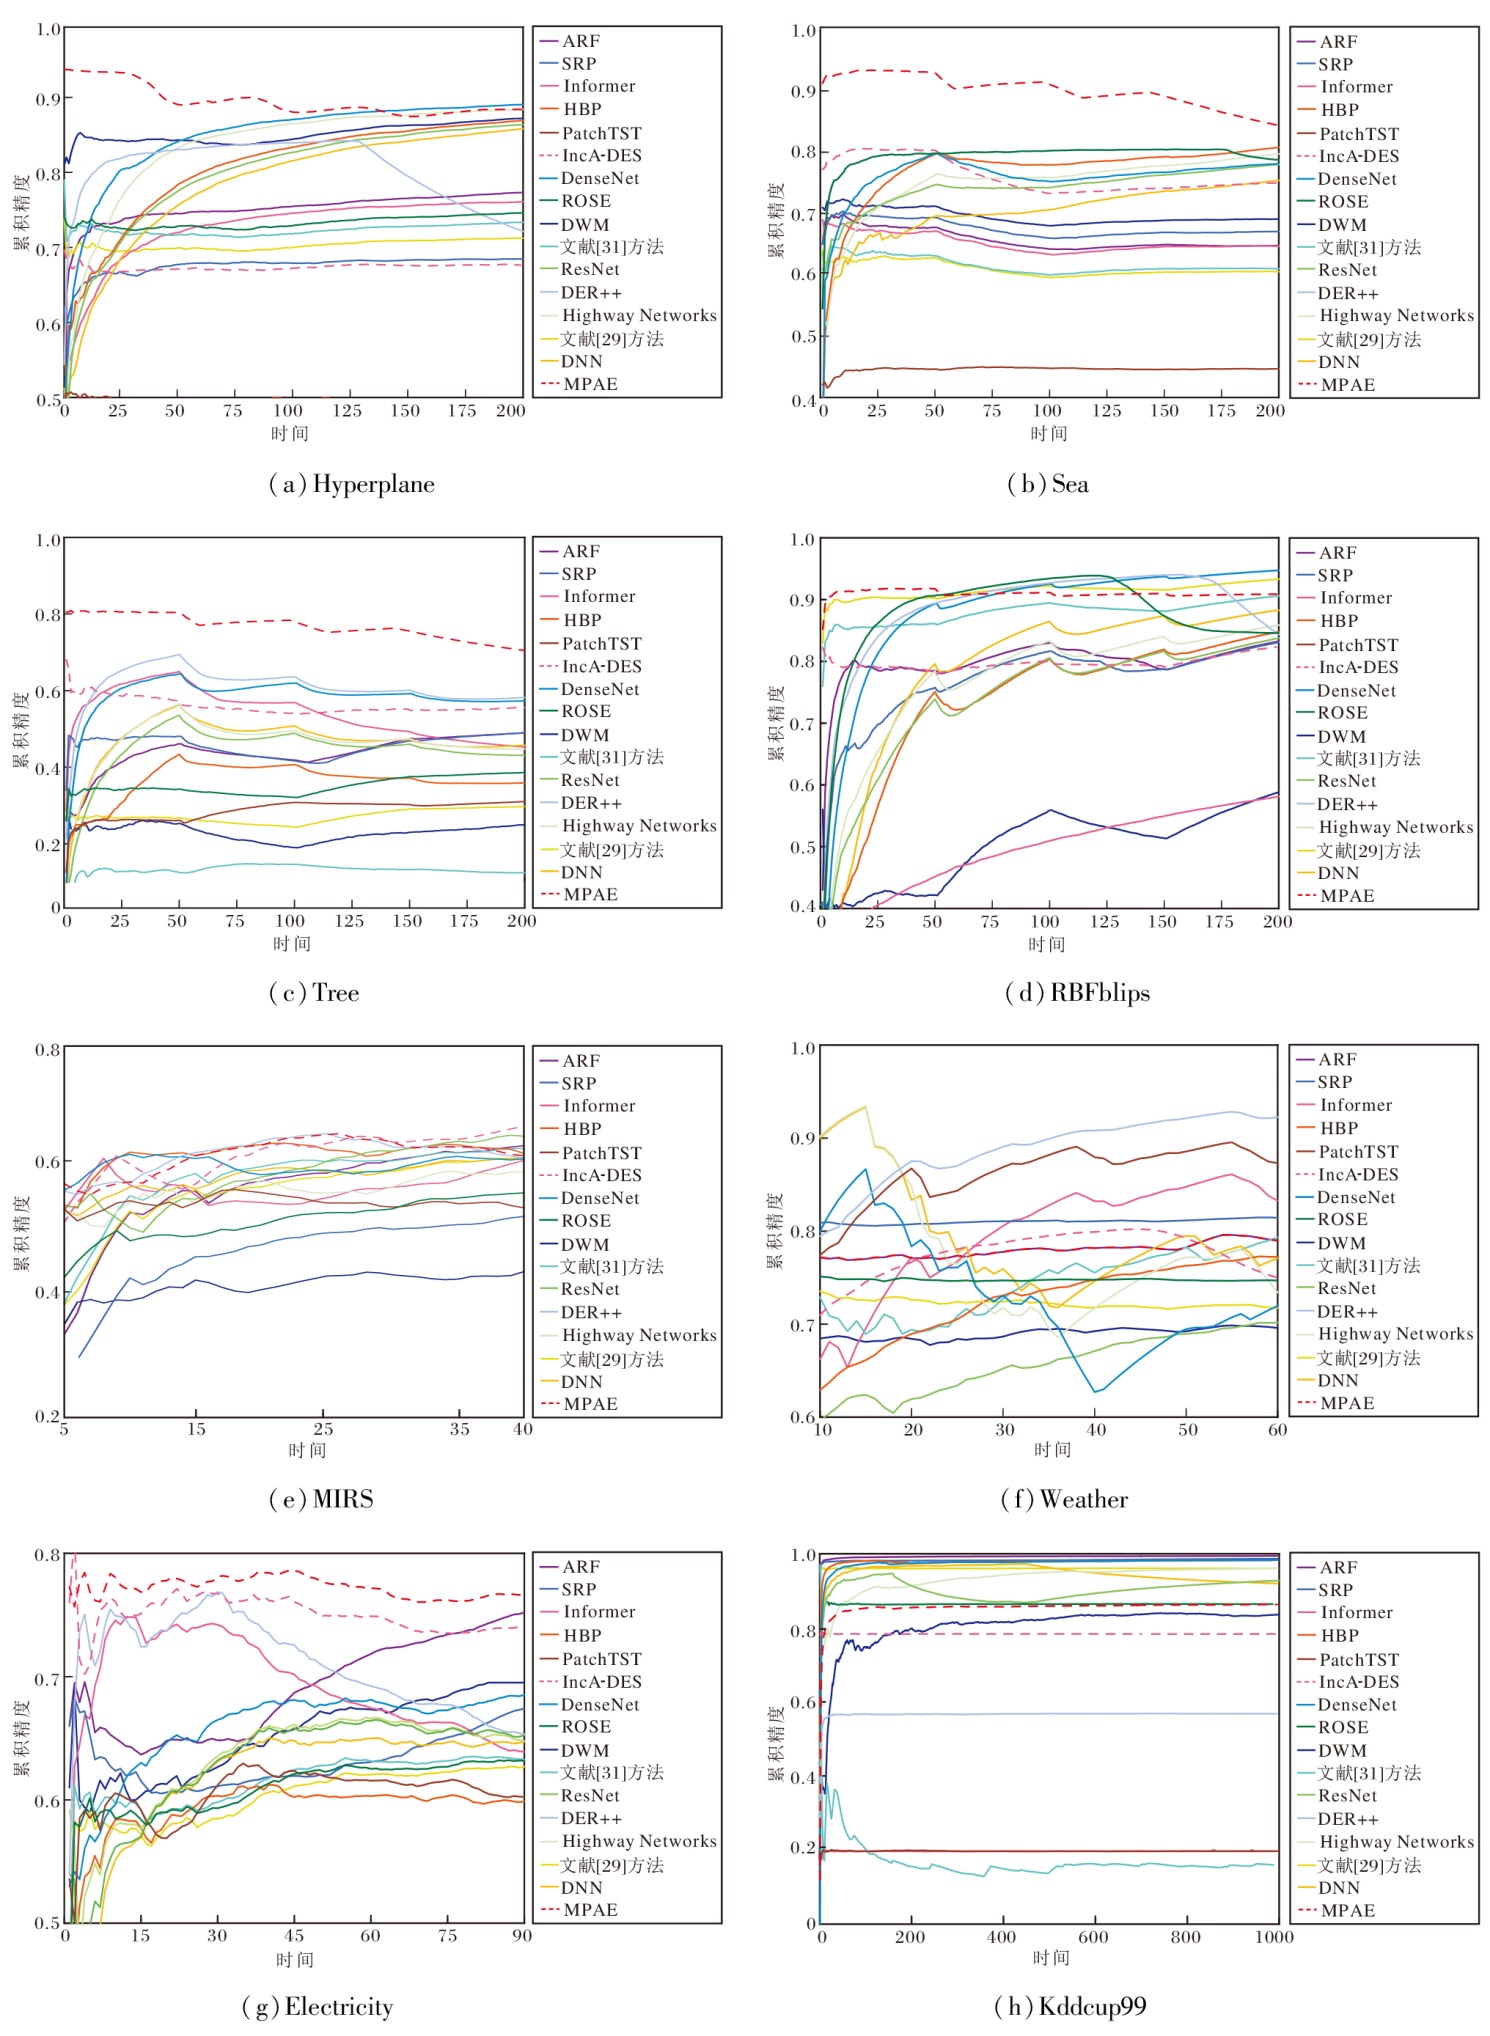 | 图4 不同方法在各数据集上的累积精度Fig.4 Cumulative accuracy of different methods on each dataset |
综合来看, 这得益于漂移检测与损失序列分析结合的数据集自适应更新策略, MPAE能在概念漂移环境下动态调整集成规模, 从而在长期累积性能上优于多数对比方法.
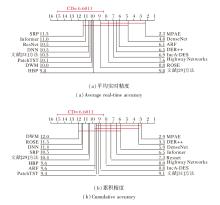
本文使用Bonferroni-Dunn检验方法[33]计算所有方法两者之间的显著性差异, 通过对比算法的平均排名差异与临界差(Critical Difference, CD)评估显著性.若平均排名差异大于临界差, 说明平均排名较高的算法优于平均排名较低的算法, 反之则无差异, 相应公式如下:
$C D=q_{\alpha} \sqrt{\frac{K(K+1)}{6 N}}, $
其中, qα 表示显著性水平α 下的临界值, K表示方法数量, N表示数据集数量.经计算可得, 当α =0.05时, CD=6.601 1.不同方法的平均实时精度和最终累积精度的统计分析结果如图5所示, 图中用红线连接平均排名在一个临近值域内的方法.在平均实时精度指标上, MPAE与DenseNet、ROSE、ARF、DER++、IncA-DES和Highway Networks之间的差异未达到统计显著水平, 而与其余对比方法之间的差异均达到统计显著水平.在累积精度指标上, MPAE与DenseNet、IncA-DES、文献[31]方法之间的差异未达到统计显著水平, 与HBP、文献[29]方法、DWM之间的差异达到统计显著水平.总之, MPAE虽然并非在所有对比方法中均表现出统计显著优势, 但在两个指标评价上均取得最低平均排名, 且相比多数平均排名靠后的方法表现出显著性能优势.
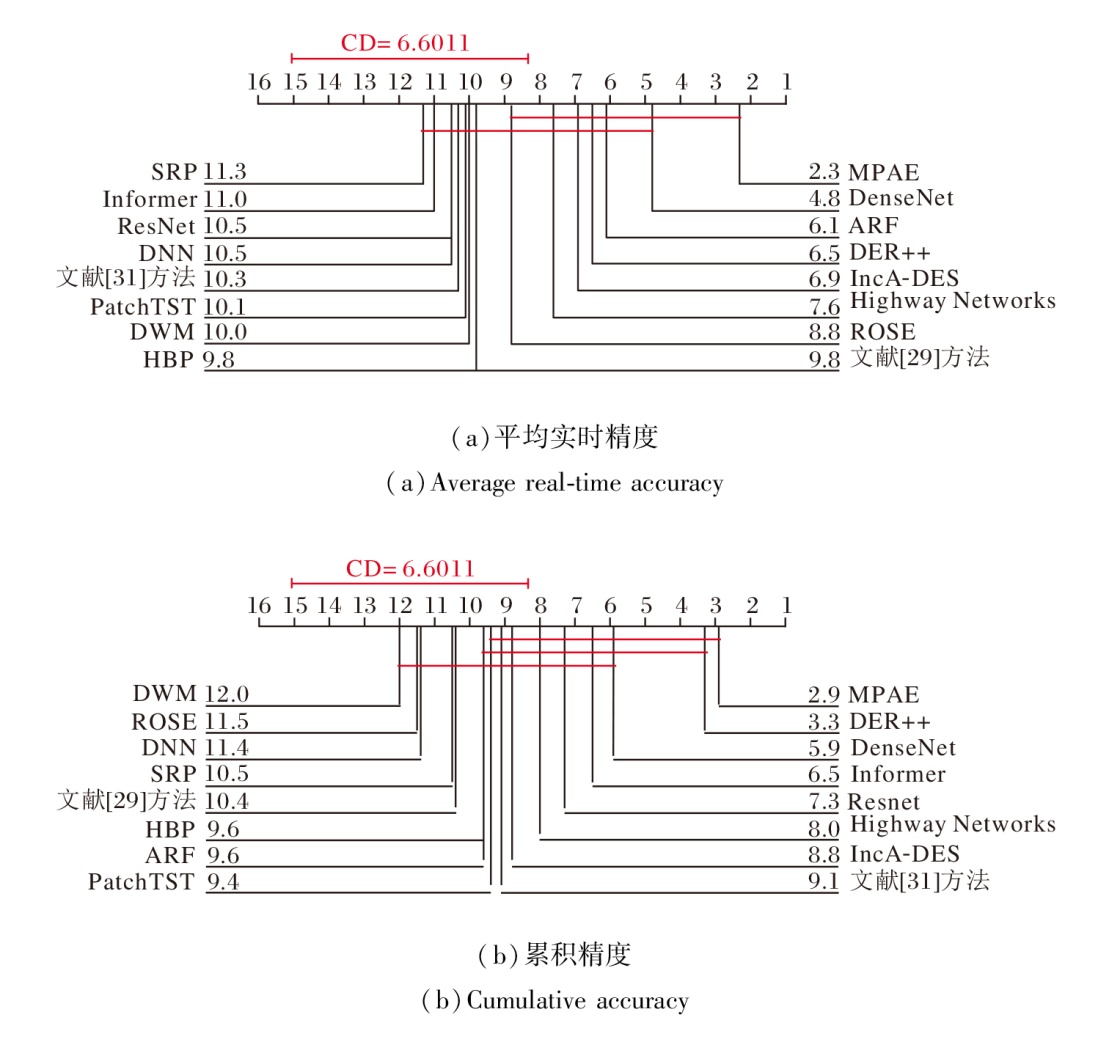 | 图5 不同方法的Bonferroni-Dunn检验结果Fig.5 Bonferroni-Dunn test results of different methods |
各方法在已知漂移位点的4个数据集上对应漂移位点处的收敛速度如表3所示, 表中的前、中、后表示每种方法对应数据集上前、中、后3个位点的收敛速度, 黑体数字表示最优值.
| 表3 不同方法在各数据集上的收敛速度 Table 3 Recovery speed of different methods on each dataset |
由表3可看出, MPAE在多数情况下都具有较快的收敛速度, 这是因为该方法能自适应更新基学习器且快速调整集成规模, 提高模型的适应性.从平均排名来看, MPAE位列第一, 说明方法具有较快的收敛速度, 收敛性能较优.
为了进一步评价各方法在流数据环境中的计算效率, 对比方法在不同数据集上的运行时间, 具体如表4所示.运行时间越短, 表明算法的计算效率越高.表中黑体数字表示最优值, 斜体数字表示次优值.由表4可看出, 不同方法在运行时间方面存在一定差异, MPAE在部分数据集上的运行时间并非最低, 但整体处于可接受水平, 能在保证分类性能的同时具有较高的计算效率.这主要得益于MPAE时序感知的样本重构, 通过限制历史样本的保留数量, 减少冗余历史数据参与模型训练, 有效降低计算开销.
| 表4 不同方法在各数据集上的运行时间 Table 4 Running time of different methods on each dataset |
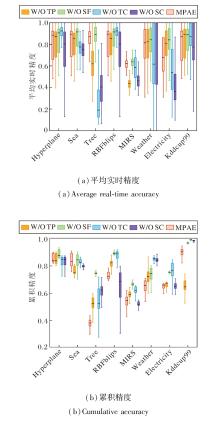
为了测试MPAE的有效性, 进行4组消融对比实验.具体而言, MPAE包含时序分型的样本重构、动态调节的样本筛选、目标集成规模调整和动态集成停止准则4个核心模块.针对每个模块分别构造对应的消融模型, 每次仅移除一个模块, 其余模块及实验设置与MPAE保持一致.W/O TP表示去除时序分型的样本重构模块; W/O SF表示去除动态样本筛选机制; W/O TC表示去除基于漂移强度的集成规模调节机制, 采用固定目标集成规模; W/O SC表示去除基于损失下降率的动态集成停止准则, 使模型在对应漂移阶段扩展至预设目标集成规模.
在包含增量型、突变型和渐进型概念漂移的数据集上进行测试, 结果如图6所示.
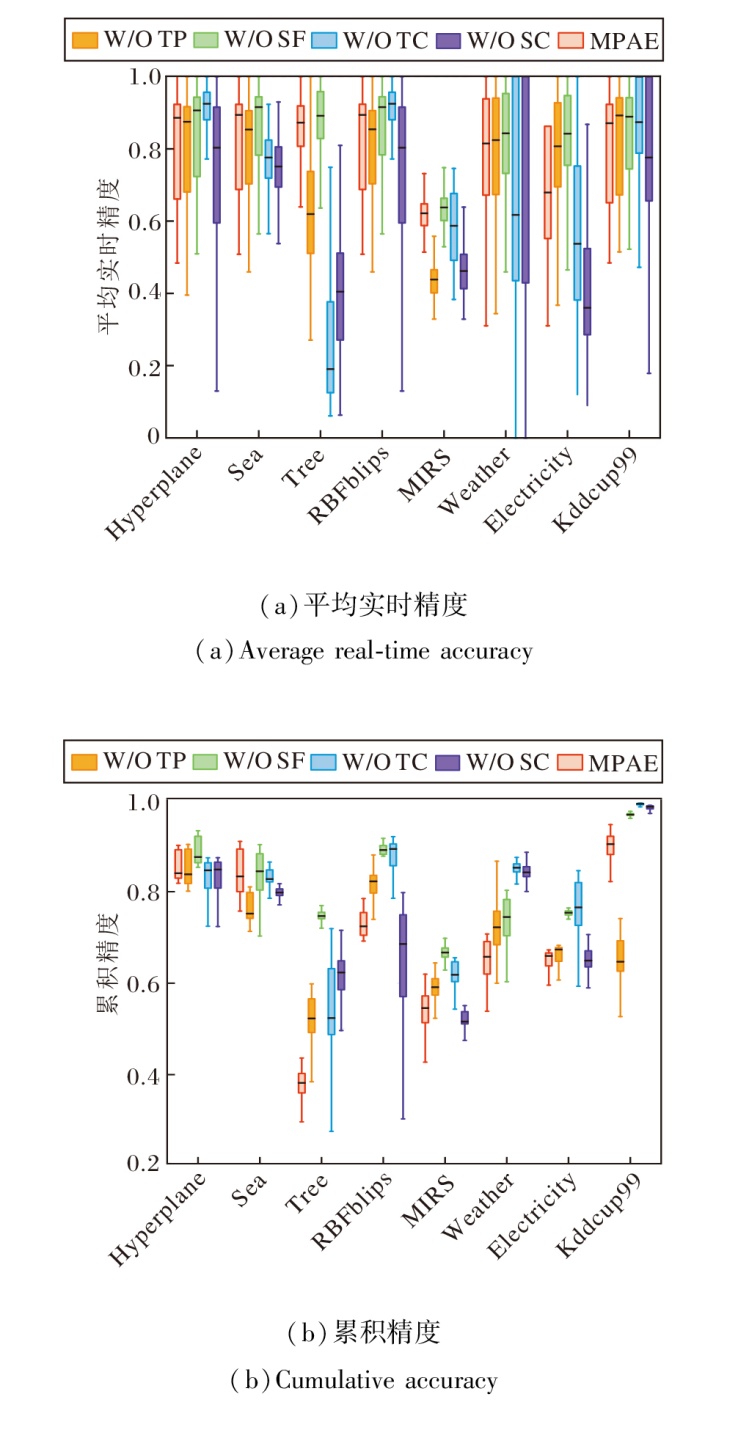 | 图6 各模块消融实验结果Fig.6 Ablation experiment results of different modules |
由图6可看出, 去除时序分型的样本重构模块(W/O TP)后, 不同分布的数据混合参与模型训练, 导致预测性能下降.W/O SF在保留样本动态重构的同时未对历史样本进行动态筛选, 部分旧分布数据持续参与模型训练.当历史分布与当前分布差异较大时, 过时信息会对模型更新产生影响, 导致对当前概念的适应能力下降.W/O TC采用固定目标集成规模, 不再根据漂移强度区分弱漂移阶段与强漂移阶段.相比MPAE, 该模型无法根据概念变化程度匹配相应的模型容量.当发生强漂移时模型容量可能不足, 而在弱漂移时又可能引入冗余基学习器, 导致性能受限.W/O SC保留漂移感知的目标集成规模, 但去除基于损失下降率的动态集成停止准则, 使模型持续扩展至预设目标规模.动态集成停止准则利用检验损失下降率控制实际集成规模.若新增基学习器带来的性能提升已较小, 继续扩展模型将增加计算开销并产生冗余.MPAE能在历史信息利用与漂移适应能力之间取得良好平衡, 提升模型的稳定性与适应性, 由此验证各模块设计的合理性.
首先分析MPAE在漂移性能衰减容忍系数μ 下的性能表现.μ 值越大表示模型对性能下降的容忍度越高, 需要保留更多的历史信息以增强模型稳定性; μ 值越小表示模型对性能变化越敏感, 需要降低历史信息的保留比例, 提高模型的响应能力.为了避免μ 值选取不当, 选取μ =0.6, 0.7, 0.8, 0.9, 1.0进行对比, 相应平均实时精度如表5所示, 表中黑体数字表示最优值.由表可见, 当μ =0.6时, 平均实时精度相对较高.当μ 值过低时, 漂移数据更可能被判定为重度漂移, 会频繁替换或丢弃历史数据; μ 值过高时会错误保留不再有效的历史数据, 降低对漂移的适应能力.综合考虑各数据集上的结果, 本文将μ 设为0.6, 保证MPAE在不同数据环境下均能保持较优的分类性能和适应能力.
| 表5 μ 对MPAE性能的影响 Table 5 Effect of μ on MPAE performance |
最大保留数据实例数量w控制模型在数据流学习过程中的记忆长度.w取值偏大容易引入过时概念, 降低对新分布的响应速度, w取值偏小会导致历史信息利用不足.选取w=200, 500, 1 000, 1 500, 2 000, 相应平均实时精度如表6所示, 表中黑体数字表示最优值.
| 表6 w对MPAE性能的影响 Table 6 Effect of w on MPAE performance |
由表6可见, 当w较小时, 历史样本保留数量有限, MPAE不能充分利用历史分布信息, 分类性能较低.随着w值增大, MPAE能保留更多与当前分布相关的历史样本, 性能得到提升.当w值继续增大时, 部分过时样本的信息会被保留, 导致MPAE对新分布的响应能力下降.综合各数据集上的结果, 当w=1 000时, MPAE在历史信息利用与漂移响应能力之间取得较优平衡.
最后分析不同最大集成规模对MPAE性能的影响.设置不同规模下限Mw和上限Ms的组合, 相应平均实时精度如表7所示, 表中黑体数字表示最优值.
| 表7 最大集成规模对MPAE性能的影响 Table 7 Effect of maximum integration scales on MPAE performance |
由表7可见, 在弱漂移阶段, 当最大集成规模下限Mw较小时, MPAE中包含基学习器数量有限, 不能充分利用历史信息, 当Mw继续增大, 过多的基学习器会增加MPAE的计算复杂度, 降低性能.在强漂移阶段, 当最大集成规模上限Ms较小时, MPAE容量不足, 不能有效学习新的数据分布特征, 当Ms进一步增大时, 新增基学习器带来的性能提升逐渐减弱, 同时也会增加计算开销.综合考虑性能与计算复杂度, 本文设置Mw=10, Ms=20.
针对集成模型在概念漂移出现后不能充分利用历史样本信息的问题, 本文提出多阶段感知引导的概念漂移自适应集成方法(MPAE), 实现数据与模型的协同自适应.通过时序感知对样本进行动态重构, 根据模型在数据块上的表现进行时序分型, 并结合损失序列与显著性检验对样本进行动态筛选.通过漂移感知对集成模型进行自适应调节, 依据漂移强度构建目标集成规模, 结合损失下降率设计动态集成停止准则, 使模型规模与分布变化强度保持一致.在8个具有不同漂移类型的数据集上进行实验, 结果表明, MPAE在不同类型概念漂移环境下表现出较优的适应能力.然而, 在高维或复杂数据分布环境下, 数据重构过程仍可能影响方法性能.后续研究将进一步结合深度特征表示方法, 提高方法对复杂数据分布的建模能力, 同时考虑引入元学习机制, 增强方法在不同概念漂移场景中的快速自适应能力.
本文责任编委 陶卿
Recommended by Associate Editor TAO Qing
| [1] |
|
| [2] |
|
| [3] |
|
| [4] |
|
| [5] |
|
| [6] |
|
| [7] |
|
| [8] |
|
| [9] |
|
| [10] |
|
| [11] |
|
| [12] |
|
| [13] |
|
| [14] |
|
| [15] |
|
| [16] |
|
| [17] |
|
| [18] |
|
| [19] |
|
| [20] |
|
| [21] |
|
| [22] |
|
| [23] |
|
| [24] |
|
| [25] |
|
| [26] |
|
| [27] |
|
| [28] |
|
| [29] |
|
| [30] |
|
| [31] |
|
| [32] |
|
| [33] |
|