

基于大语言模型语义评判的奖励建模与自动泊车策略优化方法
[韩诚1, 2  , 庄瀚洋
3 , 李悦圆1, 2 , 王春香1, 2 , 杨明1, 2 ]
, 庄瀚洋, 李悦圆, 王春香, 杨明]
|
|


作者简介:
韩 诚,硕士研究生,主要研究方向为自动驾驶、强化学习、人工智能智能体.E-mail:sjtu_hancheng@sjtu.edu.cn.
李悦圆,博士研究生,主要研究方向为自动驾驶、世界模型、强化学习.E-mail:rowena_lee@sjtu.edu.cn.
王春香,博士,副教授,主要研究方向为自动驾驶高精建图、定位与导航.E-mail:wangcx@sjtu.edu.cn.
杨 明,博士,教授,主要研究方向为智能车辆有关的定位、导航、感知、控制等方面的理论研究.E-mail:mingyang@sjtu.edu.cn.
基于强化学习与几何规划器的混合策略框架已在自动泊车任务中取得较高的成功率,但在部分复杂场景中仍存在反复换挡的震荡行为,且人工设计的标量奖励函数难以表达行为层面的偏好.针对上述问题,文中提出基于大语言模型语义评判的奖励建模与自动泊车策略优化方法,并构建为四阶段策略优化框架.首先,从混合策略系统中挖掘含震荡负样本的轨迹对,经四模型集成投票完成偏好标注.然后,通过环境奖励预训练与偏好残差微调训练两阶段奖励模型,将大语言模型对轨迹质量的偏好转化为可排序的奖励评分.最后,按场景独立筛选精英轨迹用于行为克隆.在基于真实停车场感知数据构建的 500 个仿真场景中的实验表明,文中方法可提升泊车成功率,同时大幅降低单次泊车过程中车辆平均前进-后退切换次数.
About Author:
HAN Cheng, Master student. His research interests include autonomous driving, reinforcement learning, and artificial intelligence agents.
LI Yueyuan, Ph.D. candidate. Her research interests include autonomous driving, world models, and reinforcement learning.
WANG Chunxiang, Ph.D., associate professor. Her research interests include high accuracy mapping, localization and navigation.
YANG Ming, Ph.D., professor. His research interests include theoretical investigations into positioning, navigation, perception and control of intelligent vehicles.
Hybrid policy frameworks combining reinforcement learning with geometric planners achieve high success rates in automatic-parking tasks. However, oscillatory gear-shifting behavior is still observed in some complex scenarios, and behavioral preferences cannot be adequately represented by manually designed scalar reward functions. To address these problems, a method for reward modeling and automatic parking policy optimization with large language model-based semantic assessment is proposed as a four-stage policy-optimization framework. First, trajectory pairs containing oscillatory negative samples are mined from the hybrid policy system, and preference labels are generated by ensemble voting among four models. Then, a two-stage reward model is trained through environment-reward pre-training and preference-residual fine-tuning. Preferences of large language models for trajectory quality are converted into sortable reward scores. Finally, elite trajectories are selected by scenario for behavior cloning. Experiments on 500 simulation scenarios constructed from perception data of real parking lots show that the proposed method improves parking success rates and greatly reduces the average number of forward-reverse gear switches during each parking process.
随着人工智能(Artificial Intelligence, AI)技术在感知、推理与决策领域的持续深化, 自动泊车作为智能驾驶系统的核心功能之一, 正面临从工程经验驱动向数据与模型驱动的范式转变.相比结构化道路上的巡航任务, 泊车场景空间狭窄、障碍物密集、目标姿态约束严格, 对路径规划的精度和鲁棒性要求更高.
经典的泊车路径规划以Reeds-Shepp(RS)曲线[1]和Hybrid-State A* [2]为代表.RS曲线在无障碍环境下给出时间最优的解析路径; Hybrid-State A* 在连续位姿空间(x, y, θ )经离散化的三维网格上进行启发式搜索, 同时满足车辆运动学约束.然而, 上述方法依赖精确的环境建模, 在感知噪声较大或障碍物几何形状不规则的场景中规划质量显著下降[3].深度强化学习(Deep Reinforcement Learning, DRL)提供另一条路径, 通过端到端交互学习获得对环境扰动的适应能力.HOPE(Hybrid Policy Path Planner)[4]结合DRL智能体与RS几何规划器, 当RS规划器能生成无碰撞路径时, 系统优先采用该轨迹, 否则由强化学习(Reinforcement Learning, RL)智能体生成泊车轨迹.该架构在多场景评估中成功率较高.
然而, 自动泊车在实际应用中仍存在如下2个问题.1)在复杂场景(如障碍物遮挡、极窄车位、自由空间约束受限等)中, RL智能体常出现反复前进-后退的震荡行为, 换挡次数激增, 不仅降低泊车效率, 也给乘客带来明显的顿挫感.2)现有系统以距离奖励、对齐奖励与碰撞惩罚的加权和构成标量奖励函数.这种设计在统计意义上能引导策略趋近目标, 却难以区分顺畅入位与反复试探, 二者可能积累相近的累积回报.
大语言模型(Large Language Model, LLM)使任务语义、行为偏好与可优化奖励信号之间的转换成为可能.Eureka[5]利用LLM自动生成奖励函数代码, CaP(Code as Policies)[6]将LLM推理映射为机器人控制代码, RLAIF(Reinforcement Learning from AI Feedback)[7]以 AI 反馈替代人类标注, 训练奖励模型.这些研究表明, 语义层面的任务偏好可被转化为后续优化可使用的信号.在策略优化方面, RAFT(Reward Ranked Finetuning)[8]和ReST(Reinforced Self-Training)[9]通过奖励模型排序筛选高质量样本, 用于行为克隆, 在语言生成任务上效果良好, 但在自动驾驶泊车场景中的适用性仍缺少验证.
由此, 本文提出基于大语言模型语义评判的奖励建模与自动泊车策略优化方法(Method for Re-ward Modeling and Automatic Parking Policy Optimiza-tion with LLM-Based Semantic Assessment, MAPLE).针对泊车轨迹为高维数值时间序列、LLM难以直接处理的问题, 设计面向连续控制任务的跨模态偏好学习过程.具体而言, 从轨迹数据中计算用于表征安全性、行驶效率和运动平滑性的3类量化指标, 结合自动推断的场景类型与难度构建结构化提示, 使LLM在场景语境下比较轨迹.采用两阶段奖励模型, 先利用约1.38× 10⁴条带有密集环境奖励的轨迹数据预训练编码器, 再冻结编码器与奖励头, 通过轻量残差头拟合1 367对LLM偏好标签, 用于区分运动学先验和语义偏好.策略优化阶段按场景独立筛选高分轨迹进行行为克隆(Behavior Cloning, BC), 避免简单场景在全局排序中占据过多训练配额.将MAPLE应用于HOPE后得到的优化策略记为MA-PLE-HOPE.500个仿真场景中的统一评估显示, 相比HOPE, MAPLE-HOPE将泊车成功率从88.8%提升至94.6%, 单次泊车过程中车辆平均前进-后退切换次数降低39.5%.
泊车路径规划方法大致可分为几何解析法、搜索优化法和学习法.Reeds等[1]给出有界曲率车辆在无障碍平面上的最短路径解析解.Dolgov等[2]提出Hybrid-State A* , 在连续位姿空间经离散化的三维网格(x, y, θ )上进行运动学可行的启发式搜索.Li等[10]以曲率连续性和安全间距为约束, 求解非线性规划.上述方法的共同前提是精确的环境建模.Zhang等[11]将强化学习用于自动泊车运动规划.Tang等[12]基于SAC(Soft Actor-Critic)[13], 在非理想泊车场景中实现路径规划与跟踪控制的联合优化.Han等[14]提出NeuPAN(Neural Proximal Alternating-Minimization Network), 将点云约束、可训练距离编码器与模型预测控制紧耦合, 形成从障碍点到控制量的模型驱动学习规划器.Jiang等[4]提出HOPE, 结合RL与RS规划器, 形成混合策略, 在多难度场景中取得较优结果.
奖励函数设计是RL应用中的核心难题之一.奖励设计不当可能诱发奖励投机等偏离预期目标的行为[15].逆强化学习(Inverse Reinforcement Learning, IRL)可从专家演示中恢复奖励函数[16].彭浩楠等[17]提出最大熵原则的逆强化学习方法, 将IRL应用于智能网联汽车轨迹规划优化.基于势能函数的奖励塑形在理论上可保持策略不变性[18], 但势能函数设计仍依赖领域先验, 对权重调整较敏感.偏好学习提供另一种思路.Christiano等[19]沿用Bradley-Terry模型[20], 将成对偏好比较转化为标量评分并训练奖励模型.Ouyang等[21]提出InstructGPT, 将该范式系统转化为基于人类反馈的强化学习(Rein-forcement Learning from Human Feedback, RLHF)流程并应用于语言模型对齐.Lee等[7]提出RLAIF, 使用LLM标签替代人类标注.在具体方法上, Lee等[22]提出PEBBLE(Unsupervised Pre-training and Preference-Based Learning via Relabeling Experience), 通过成对人类查询与经验重标注实现无监督偏好学习.Brown等[23]提出D-REX(Disturbance-Based Re-ward Extrapolation), 向专家演示中注入噪声, 自动生成排序信号, 训练奖励模型以泛化至超越演示质量的行为.
LLM已被用于机器人控制、奖励设计和自动驾驶决策领域.王祥等[24]结合知识与大语言模型, 研究高速环境下的自动驾驶决策.Ma等[5]提出Eure- ka, 使用GPT-4迭代生成奖励函数代码, 实现无需人工设计的奖励工程.Xie等[25]提出Text2-Reward, 将自然语言任务描述转化为可执行奖励代码.Liang等[6]提出CaP, 将自然语言指令转化为机器人控制代码, 以LLM推理能力弥合语言与动作的语义鸿沟.Kwon等[26]将LLM用作逐步代理奖励函数, 依据任务描述对智能体的每步行为进行语义评分.上述工作表明, LLM能在一定程度上理解物理世界任务语义, 并将安全性、效率等层面的偏好转化为可供策略学习的信号.
提示策略方面, Wei等[27]提出Chain-of-Thought(CoT) Prompting提示, 通过逐步推理示例引导LLM给出中间判断.Lee等[7]提出RLAIF, 在偏好评价提示中采用逐步推理过程.在安全攸关场景中, 分步推理有助于减少模型对单个数值指标的过度依赖, 使偏好判断更贴近具体场景.
RAFT[8]以奖励模型评分筛选高质量样本, 用于行为克隆.ReST[9]将其推广为多轮“ 生成-评估-学习” 迭代方式.两者均在文本、代码等离散生成任务中验证以奖励为引导的策略精调的有效性.在自动驾驶轨迹规划领域中, 已有工作将RLHF引入轨迹优化器的偏好对齐, 采用在线策略梯度持续更新规划网络, 跟踪偏好分布的漂移.然而此类方案难以应用于含不可微规划器步骤的混合架构, 并且在场景异质性较强时, 全局排序容易导致简单场景占主导、困难场景训练配额不足.
在机器人与自动驾驶领域, 模仿学习(Imitation Learning, IL)与RL的结合常被用于提升样本效率.Huang等[28]从行为克隆策略中提取专家先验, 通过Kullback-Leibler(KL)散度正则化SAC训练过程, 在自动驾驶任务中提高样本效率.Hu等[29]提出IBRL(Imitation Bootstrapped Reinforcement Learning), 利用模仿学习策略引导RL探索并辅助Q值估计, 在机器人操作任务中取得较优效果.上述方法说明示范衍生策略可改善RL训练, 但多数依赖固定专家示范数据集, 示范质量不随策略改善而更新, 在高难度场景中仍受限.
现有RAFT和ReST主要用于验证文本、代码等离散生成任务, 面向多场景异质泊车时证据仍不足.在线策略梯度方案与含不可微规划器的混合架构并不容易兼容, 固定示范的IL也难以随策略迭代更新示范质量.
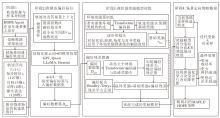
本文提出基于大语言模型语义评判的奖励建模与自动泊车策略优化方法(MAPLE).以基于预训练混合策略的泊车智能体HOPE[4]为基线, 分为轨迹挖掘与样本对构建、跨模态偏好标注、奖励模型训练和场景定向策略精调4个阶段, 整体架构如图1所示.HOPE在执行过程中优先调用RS规划器连接当前状态与目标车位.当局部几何规划尚不能形成安全可行路径时, 由RL策略网络继续探索并调整车辆状态.基于HOPE流程, MAPLE围绕如下3项设计展开.将震荡程度、路径效率和安全裕度等轨迹物理量转写为结构化自然语言, 使LLM能在轨迹层面比较控制行为.将泊车类型和场景难度纳入提示词, 使偏好判断依赖具体场景语境.再通过奖励模型对完整轨迹进行离线评估与排序, 从中选取高质量示范用于行为克隆.
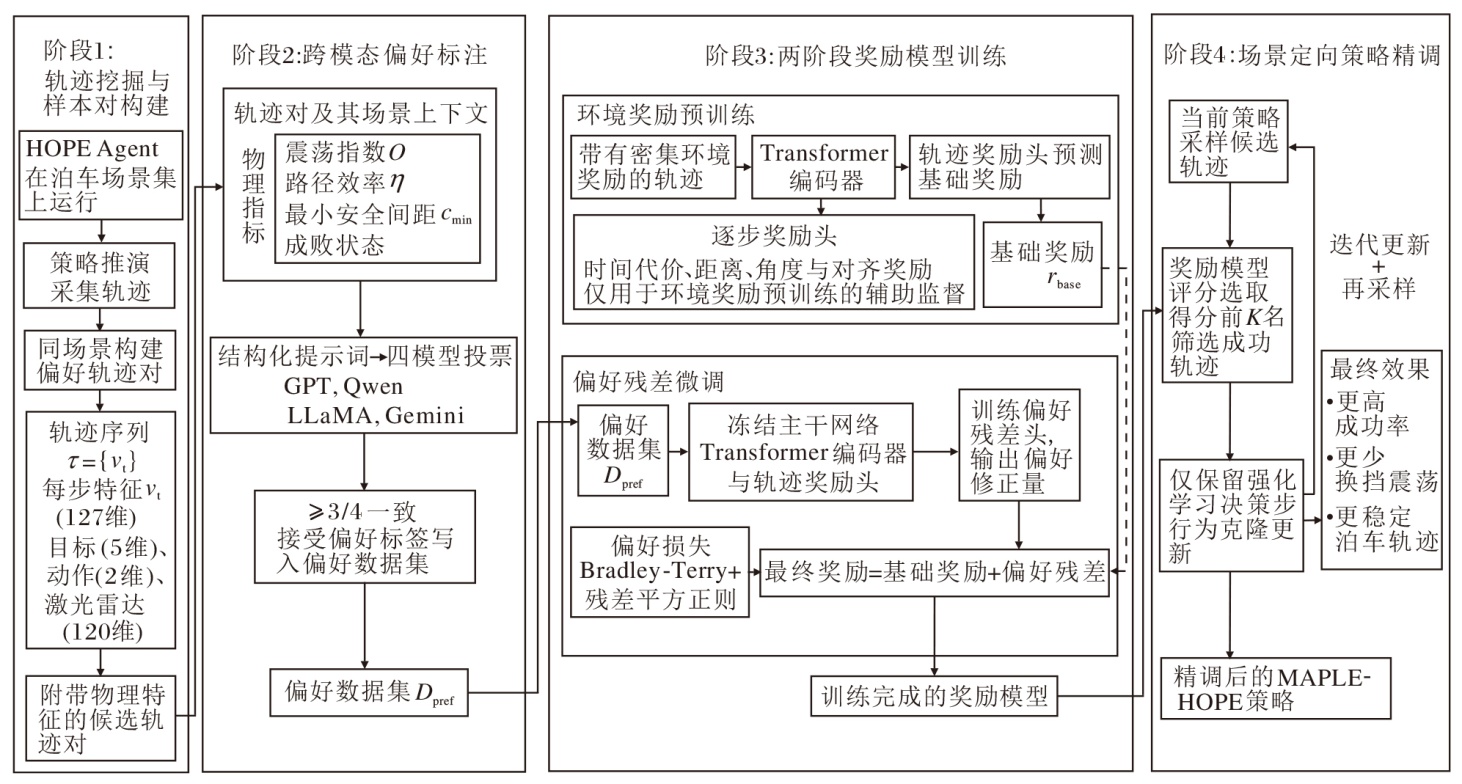 | 图1 MAPLE整体架构Fig.1 Overall architecture of MAPLE |
偏好学习需要成对比较数据.与自然语言处理(Natural Language Processing, NLP)任务不同, 泊车轨迹的质量差异不仅体现在成功或失败, 还体现在执行过程.两条均到达目标的轨迹, 可能在平滑性、效率和安全裕度上存在明显差异.混合策略中的RL策略具有随机性, 同一场景的多次执行有一定概率产生不同质量的轨迹.本文使用预训练 HOPE 智能体在 500个泊车场景中采集并审核轨迹.
在同一场景中构建成功与失败轨迹配对、同为成功的轨迹间质量对比两类偏好对.构建时过滤近似重复对以保证偏好对多样性, 并优先选取对比度高的样本.最终提交1 391组候选偏好对(成功与失败配对528组, 成功间质量对比863组), 后续交由四模型集成投票筛选, 1 367组达成共识被接受.
本阶段将轨迹的物理特征转写为结构化自然语言描述, 再交由LLM进行偏好标注.采用LLM标注主要出于如下3方面考虑.首先, 提示词可显式给出偏好优先级, 如安全优先于效率, 并在数千组对比中按同一规则进行场景条件化判断.其次, 提示词、逐模型解析得到的偏好结果与推理说明、投票和固定标签均可被保存与审计, 这使下游奖励模型(Re-ward Model, RM)与策略精调不依赖再次调用同一应用程序编程接口(Application Programming Inter-face, API).最后, 推理记录可用于事后检查标注质量与失败归因.Lee等[7]已在文本摘要、有益性对话等多项任务上验证AI反馈与人类反馈的效果可比性.
对每条轨迹定义如下特征指标.首先定义震荡指数:
$O=\frac{N_{\text {gear }}}{\max (D, \varepsilon)} .$
其中: Ngear表示忽略零速采样点后, 车辆沿着行驶方向在前进与倒车之间切换的次数; D表示按相邻轨迹点二维欧氏距离累加得到的行驶距离; 分母下限ε =0.1m, 用于避免近零位移轨迹产生的数值不稳定.行驶距离归一化的目的是消除行程长短对换挡频率统计的影响, 长路径通常包含更多的绝对换挡次数, 而每单位距离的换挡率能更准确地刻画策略的决策稳定性.
末段换向占比为:
$\rho=\left\{\begin{array}{ll} \frac{N_{\text {gear, end }}}{N_{\text {gear, total }}}, & T \geqslant 3, N_{\text {gear, total }}> 0 \\ 0, & \text { 其它 } \end{array}\right.$
其中:T表示轨迹采样点数; Ngear, total=Ngear, 表示全轨迹换向事件数; Ngear, end表示发生在轨迹末段三分之一区间内的换向事件数.当轨迹少于3个采样点或全轨迹内无换向事件时, ρ =0.该指标用于区分前期调整后平稳入位与临近目标车位仍频繁换挡的行为模式.
路径效率为:
$\eta=\left\{\begin{array}{ll} \frac{d_{\text {straight }}}{d_{\text {path }}}, & d_{\text {path }} \geqslant 0.1 \mathrm{~m} \\ 0, & \text { 其它 } \end{array}\right.$
其中:dstraight表示轨迹起点与终点间的二维欧氏距离; dpath表示沿轨迹累计得到的行驶距离.当dpath< 0.1 m时η =0.
其余特征指标还包括行驶过程中车辆外形与障碍物之间的最小距离cmin.
提示词中还包含自动推断的场景上下文.系统根据障碍物在目标车位局部坐标系中的分布判别泊车类型(垂直、侧方或斜向), 并结合起点到终点距离、旋转角度与障碍物密度计算综合难度评分.引入场景上下文后, 同一物理指标可在不同难度下被区别解释.在空间紧凑的高难度场景中, 适度换挡可能是为了安全调整; 在开阔的低难度场景中, 同等频次的换挡更可能反映策略低效.LLM可能过度惩罚具有探索性但其实是安全的行为, 针对这一潜在偏差, 提示词要求模型在场景难度上下文下区分高难度场景中合理的换挡调整与低难度场景中低效换挡, 而非对换挡行为一概而论.
提示词采用思维链格式, 要求模型按安全性、效率和综合判断逐步推理.标注由Gemini 3.1 Flash-Lite Preview、Qwen2.5-72B-Instruct、Llama-3.3-70B-Instruct 与GPT-4o mini这4个异构LLM集成投票完成, 4个模型中至少3个一致才接受该标签.为了消除位置偏见, 每组轨迹对以均匀概率随机交换呈现顺序, 标注结果再映射回原始对应关系.最终标签 y∈ {0, 1}, y=1表示轨迹A优于轨迹B.
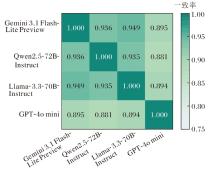
由图2可见, 共1 391组轨迹对提交至四模型集成, 其中81.5%(1 133对) 获得全票一致(4/4), 16.8%(234对)为多数一致(3/4), 1.7%(24对)因分歧过大被拒绝, 最终接受1 367对.四模型标注的Fleiss'κ [30]=0.828, 按Landis & Koch[31]的分级标准属于几乎完全一致区间(κ > 0.80).从类型上看, 成功-失败对的全票一致性明显高于成功-成功质量对比, 后者全票率为74.9%, 涉及更细粒度的行为偏好判断, 分歧略高在预期之内.模型间两两一致率显示GPT-4o mini最独立(平均 89.0%), Gemini 3.1 Flash-Lite Preview与Llama-3.3-70B-Instruct的两两一致率最高(94.9%), 表明异构集成可有效抑制单模型偏差.
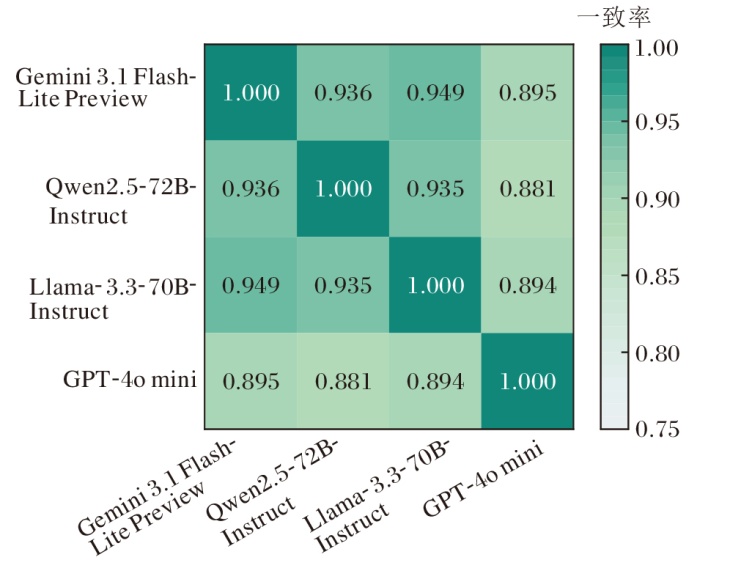 | 图2 四模型集成标注一致性分析Fig.2 Analysis of pairwise annotation agreement rates among four LLMs |
为了进一步检查LLM偏好是否偏离人类直观判断, 从偏好对中按“ 成功-成功” 、“ 成功-失败” 和低模型共识难例分层抽取100组轨迹对, 并限制同一场景的入选数量, 以此提高候选场景的多样性.9名标注者在隐藏方法名称和成败标签的条件下, 使用独立界面完成二选一判断, 人工投票结果与LLM集成标签总体保持较高一致性.
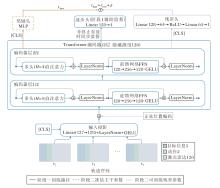
奖励模型(RM)采用 Transformer[32] 编码器架构, 训练分为两个阶段:环境奖励预训练和偏好残差微调, 具体架构如图3所示.
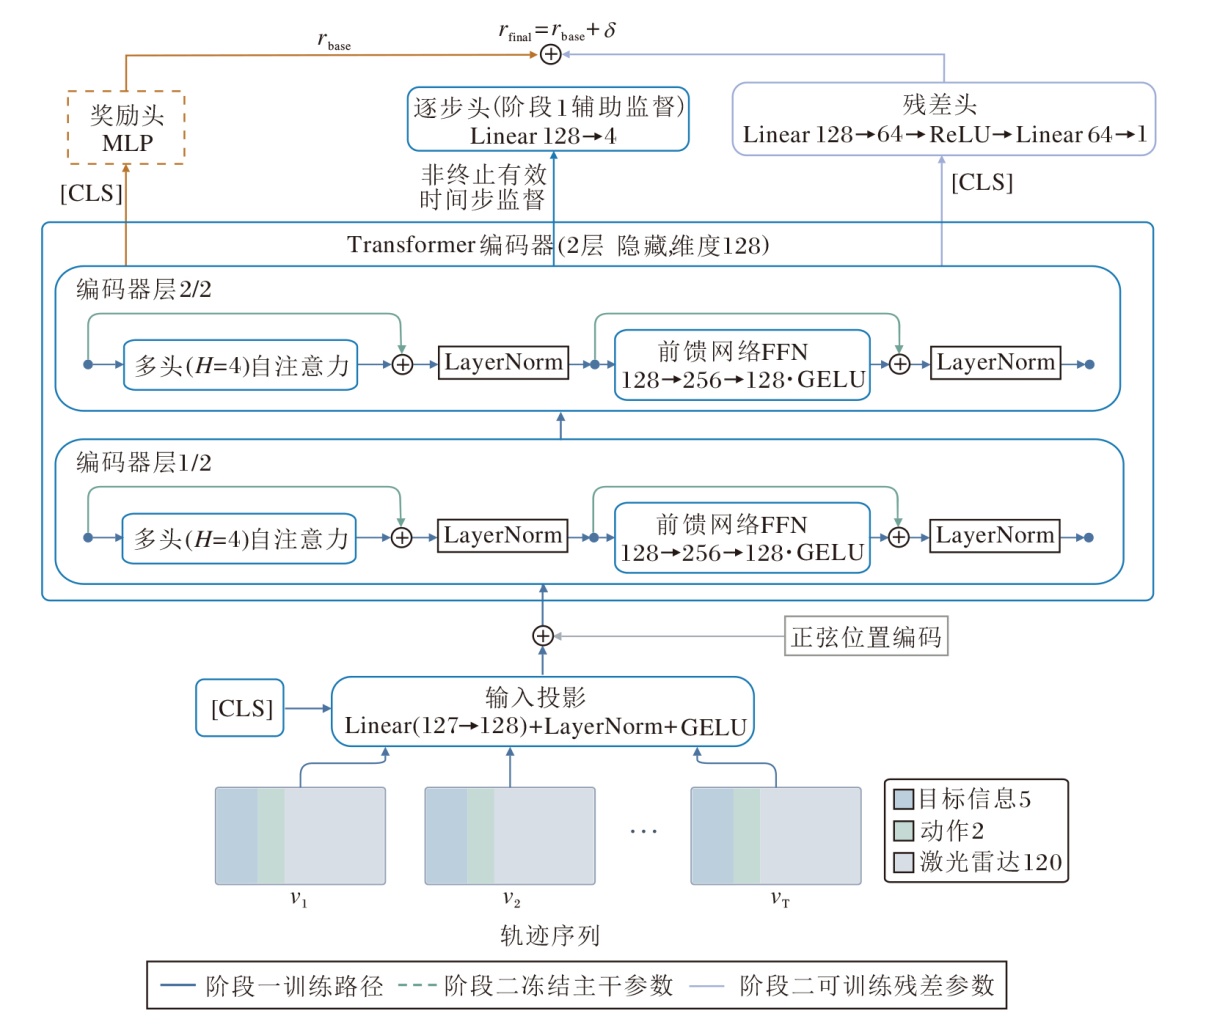 | 图3 奖励模型架构图Fig.3 Architecture of reward model |
输入轨迹$\boldsymbol{\tau}=\left(\left(\boldsymbol{o}_{t}, \boldsymbol{a}_{t}, \boldsymbol{l}_{t}\right)\right)_{t=1}^{T}$为有序序列, 其中, ot∈ R5表示目标信息, at∈ R2表示动作, lt∈ R120表示激光雷达扫描信息.第 t 个时间步的目标信息ot、动作at和激光雷达扫描lt拼接为特征向量
$\boldsymbol{v}_{t}=\left[\boldsymbol{o}_{t}^{\mathrm{T}}, \boldsymbol{a}_{t}^{\mathrm{T}}, \boldsymbol{l}_{t}^{\mathrm{T}}\right]^{\mathrm{T}} \in \mathbf{R}^{127}, $
经线性投影映射至d=128维嵌入空间, 得到该时间步送入Transformer编码器前的初始嵌入:
$\boldsymbol{h}_{t}^{(0)}=G E L U\left(L N\left(\boldsymbol{W}_{\text {proj }} \boldsymbol{v}_{t}+\boldsymbol{b}_{\text {proj }}\right)\right), $
其中, Wproj、bproj分别表示可学习的线性投影矩阵和偏置向量, LN(· )表示层归一化(Layer Normalization, LN), GELU(· )表示高斯误差线性单元(Gaussian Error Linear Unit, GELU)激活函数.在序列头部添加可学习的分类令牌(Classification Token), 并加入正弦位置编码.
Transformer编码器包含L(L=2)层标准编码层, 每层为多头(H=4)自注意力, 前馈隐藏维度dff=256, 随机失活率为0.1.
模型设有3个输出头, 分别服务于不同训练阶段的优化目标.奖励头为3层多层感知机(Multi-layer Perceptron, MLP)(128→ 256→ 128→ 1, 参数量约为6.6× 10⁴), 从[CLS]表征预测轨迹级基础奖励rbase.逐步奖励头为简单线性层(128→ 4, 参数量约为516), 对编码器每个时间步的输出预测四分量环境奖励(时间代价、距离奖励、角度奖励、对齐奖励), 仅在第1阶段使用.引入逐步预测任务的目的是使编码器在中间层学到逐步粒度的物理表征, 避免所有信息都压缩至[CLS]位置的全局统计量中.偏好残差头为两层MLP(128→ 64→ 1, 参数量约为8.3× 10³), 输出偏好修正残差δ .最后一层权重零初始化, 确保第2阶段开始时δ =0, 不破坏第1阶段已建立的评分基线.编码器与奖励头参数量之和约为3.48× 10⁵; 引入偏好残差头(参数量约为8× 10³)后模型总参数量约为3.56× 10⁵.
第1阶段为环境奖励预训练.两阶段训练的动机在于偏好标注数据的稀缺性.1 367 组偏好对相对于参数量约为3.56× 10⁵的模型而言并不充分, 直接端到端训练极易过拟合.因此本文先利用约13 753条已有轨迹(9 567成功、4 186失败)的密集环境奖励信号对编码器进行预训练, 注入运动学先验.损失函数如下:
$\begin{aligned} L_{1}= & \frac{\alpha}{4 N_{\text {valid }}} \sum_{b} \sum_{t} \sum_{c}\left(\widehat{R}_{\text {btc }}-\widetilde{R}_{\text {btc }}\right)^{2}+ \\ & \frac{1-\alpha}{B} \sum_{b}\left(\hat{r}_{\text {base }, b}-\widetilde{R}_{b}\right)^{2} . \end{aligned}$
其中:$ N_{\mathrm{valid}}=\sum_{b} T_{b}$, 表示批内有效步总数, Tb表示第b条轨迹中参与损失计算的有效非终止步数; t=1, 2, …, Tb表示第b条轨迹中参与损失计算的有效非终止时间步索引; B表示批大小; c表示环境奖励分量索引, 分别对应时间代价、距离奖励、角度奖励和对齐奖励.损失函数中的第1项对批内所有有效时间步及4个奖励分量的平方误差取平均, 第2项对批内所有轨迹的累计奖励预测平方误差取平均; α =0.3用于平衡逐步物理表征目标与轨迹级累计奖励目标;
第2阶段为偏好残差微调.冻结编码器与奖励头的全部参数, 仅训练零初始化的残差头.采用Bradley-Terry模型[20], 定义偏好概率:
$P\left(\tau_{w}> \tau_{l}\right)=\sigma\left[\left(r_{\text {base }, w}+\delta_{w}\right)-\left(r_{\text {base }, l}+\delta_{l}\right)\right], $
其中, τ w、τ l分别表示LLM集成标签判定的更优轨迹和另一条轨迹, rbase, w、rbase, l分别表示第1阶段奖励头对2条轨迹输出的基础评分, δ w、δ l分别表示第2阶段偏好残差头对两条轨迹输出的评分修正量,
$\sigma(z)=\frac{1}{1+e^{-z}}, $
表示Sigmoid函数.
损失由Bradley-Terry负对数似然与残差输出幅值的二次惩罚组成:
$L_{2}=-\frac{1}{B} \sum_{i=1}^{B} \ln \left(\sigma\left(\Delta_{i}\right)\right)+\frac{\lambda}{2 B} \sum_{i=1}^{B}\left[\left(\delta_{i}^{w}\right)^{2}+\left(\delta_{i}^{l}\right)^{2}\right] .$
其中:
$\Delta_{i}=\left(r_{\text {base }, i}^{w}+\delta_{i}^{w}\right)-\left(r_{\text {base }, i}^{l}+\delta_{i}^{l}\right), $
表示2条轨迹最终评分之差; i表示小批量中的偏好轨迹对索引;
奖励模型训练完成后, 本文将其作为离线轨迹筛选器使用.混合架构中RL仅控制约30%的时间步, 在线策略梯度方法的有效信号密度受限.同时, RS规划器步骤不可微, 直接端到端更新并不适合该架构.因此, 本文策略是从候选轨迹中识别高质量示范供行为克隆使用, 而不是通过在线策略梯度将奖励信号直接传播至策略网络.该思路借鉴NLP领域的RAFT[8], 并针对连续控制任务中的场景异质性进行调整.
多场景泊车任务中各场景的难度差异较大, 统一采样会造成资源浪费或覆盖不足.基于HOPE轨迹审核结果, 500个场景被划分为246个简单场景、221个中等场景和33个困难场景.针对简单场景每轮抽取80个并在15轮内累计覆盖全部场景, 用于维持基础泊车能力.中等场景全部参与每轮采样, 是行为克隆训练的主要来源.困难场景因有效成功轨迹数量不足而不进入行为克隆数据.因此每轮实际覆盖301个场景, 针对每个场景采样10条候选轨迹.
RAFT的核心是生成、评估和学习的多轮迭代.每轮迭代包含采样、筛选、更新3个环节.采样后从每个场景的成功轨迹中按RM综合评分rbase+δ 取Top-2, 轨迹以场景为单位独立筛选而非全局排序, 其中, rbase表示第1阶段奖励头输出的轨迹基础评分, δ 表示第2阶段偏好残差头输出的修正量, 二者之和为奖励模型的最终综合评分.在同一候选池中, 简单场景轨迹仅占26.6%, 但在按RM分数全局排序的前100条中占比为61.0%, 因此逐场景筛选可避免中等场景训练样本被压缩.筛选后仅提取RL策略实际决策的步骤以构建行为克隆数据集
$D_{B C}=\left\{\left(o_{t}, a_{t}\right)\right\}, $
其中, t表示入选轨迹中的RL策略决策时间步, ot表示第t个RL决策时间步的策略观测, at表示该时间步实际执行的归一化连续控制动作.RS步骤因其确定性极值控制特性而被排除, 避免破坏策略输出的平滑性.更新阶段应用MSE损失对策略网络进行监督学习, 即
$\begin{array}{l} L_{B C}\left(B_{B C}\right)= \\ \quad \frac{1}{\left|B_{B C}\right| d_{a}} \sum_{(o, a) \in B_{B C}}\left\|\operatorname{clip}\left(\mu_{\theta}(o), -1, 1\right)-a\right\|_{2}^{2}, \end{array}$
其中, BBC表示行为克隆训练的小批量, |BBC|表示批内样本数, da=2表示连续动作维数, μ θ (o)表示高斯策略的动作均值网络输出, clip(x, -1, 1)表示逐元素将x截断至[-1, 1]区间内.上式对批内样本和两个动作分量共同取均值, 与主实验入口中的MSE实现一致.策略标准差不参与该损失的计算, 因此在行为克隆阶段保持不变.设置学习率为3× 10⁻⁵, 批大小为64, 采用梯度范数裁剪, 最大梯度范数设为0.5, 每轮训练15个周期, 共训练15轮.更新后在全部500个测试场景中执行一次固定种子评估, 记录成功率与行为质量指标, 再进入下一轮采样.
实验基于HOPE自动泊车环境和自行车运动学模型.车辆轴距为2.9 m, 车长为4.82 m, 车宽为2.0 m, 最大转向角为± 0.75 rad.策略网络输出连续的转向角和速度.
实验对象为500个从真实停车场感知数据中提取的测试场景.各方法接收相同的起点、终点和障碍物信息, 并在评估中使用相同车辆外形与到达判据.
选择如下6种方法进行对比实验:RS[1]、HOPE[4]、SAC[13]、PPO[33]、Autoware Freespace Hybrid A* [34]、文献[35]方法.
PPO与SAC只使用预训练策略网络直接输出连续控制动作, 未使用RS规划器, 也不在本文测试场景中训练或微调.Autoware Freespace Hybrid A* 与文献[35]方法按各自官方规划器流程处理相同场景输入.
HOPE、MAPLE-HOPE、PPO、SAC与RS在同一闭环环境中执行, Autoware Freespace Hybrid A* 与文献[35]方法按各自官方规划流程在相同场景输入上运行.
Autoware Freespace Hybrid A* 官方接口以代价栅格、起点和终点为输入, 并返回搜索成败与轨迹.实验采用Freespace Hybrid A* 规划流程, 输出带前进/倒车标记的几何路点.所有Autoware轨迹均在规划器之外使用原始障碍物多边形、HOPE车辆外形、到达重叠阈值和曲率上限进行独立稠密复核.
文献[35]方法是基于动力学可行搜索初值、微分平坦表示和安全走廊优化的开源时空轨迹规划器.本文复现其官方流程后, 仅替换为相同的起点、终点和障碍物输入, 并采用其官方任务完成判据作为成功口径.
各方法在500个场景中的成功率和轨迹质量对比如表1所示, 表中黑体数字表示最优值.成功场景环境交互步数为完成任务的轨迹从开始交互至到达目标经历的环境步数; 文献[35]方法的优化轨迹点和Autoware Freespace Hybrid A* 的几何路点受各自离散分辨率影响, 不能等同于环境控制步, 因此不在该列报告.全场景路径效率为500个场景中起点到终点的直线距离与实际轨迹长度之比的平均值, 无有效路径的场景按0计入.成功场景最小间距为成功轨迹中车辆外形与原始障碍物多边形之间的最小距离, 数值越大表示已完成任务中的安全裕度越高.全场景换向次数为500个场景中前进与倒车方向切换次数的平均值.全场景震荡指数为500个场景中换向次数与累计行驶距离之比的平均值.Autoware Freespace Hybrid A* 与文献[35]方法在失败场景中没有完整执行轨迹, 直接纳入换向和震荡的全场景平均会引入口径偏差, 因此不在这两列报告.
 | 表1 各方法在500个场景中的成功率和轨迹质量对比 Table 1 Success rate and trajectory-quality comparison of different methods on 500 scenarios |
MAPLE-HOPE在500个场景中的成功场景为473个, HOPE为444个, 相比之下MAPLE-HOPE多完成29个场景, 成功率提高5.8%.逐场景配对结果中, 双方均失败20场、仅MAPLE-HOPE成功36场、仅HOPE成功7场、双方均成功437场.精确McNe- mar检验基于36个“ 仅 MAPLE-HOPE 成功” 和7个“ 仅HOPE成功” 的不一致配对场景计算, 得到p=8.963× 10⁻⁶, 表明成功率差异具有统计显著性.在全部500个场景中, 相比HOPE, MAPLE-HOPE的换向次数由21.924降至13.266, 全场景震荡指数由0.197 4降至0.164 1, 全场景路径效率由0.557 0升至0.582 3; 在各自成功场景中, 平均步数由20.703降至20.323, 最小间距由0.655 1 m降至0.647 3 m.上述成功状态和轨迹质量指标均基于相同的500个场景与评估流程得到, 说明MAPLE-HOPE在提高任务完成比例和减少反复调整的同时, 未明显增加成功轨迹的执行步数, 也未明显压缩安全裕度.
其余方法用于给出不同能力边界.PPO与SAC未使用RS规划器, 分别严格完成78个场景(15.6%)和 47个场景(9.4%), 反映纯策略网络在目标域中的表现.RS在500个场景中完成335个, 反映其在起点和终点之间一次性生成并执行无碰撞解析路径的能力.Autoware Freespace Hybrid A* 在独立几何复核下完成规划的378个场景.文献[35]方法按其官方任务口径完成210个场景.
简单场景每轮抽取80个, 15轮累计覆盖全部简单场景, 用于维持已学习的基础泊车能力.中等场景全部参与每轮采样, 是行为克隆训练的主要来源.困难场景不参与行为克隆训练.HOPE和MAPLE-HOPE在各类场景中的成功率如表2所示.由表可见, 相比HOPE, MAPLE-HOPE在困难场景中的成功率仍由18.2%升至48.5%, 说明策略改进并未局限于参与采样的简单场景和中等场景, 而是在同一数据集内部表现出跨难度迁移效果.该结果不能视为模型具有相当跨数据集泛化能力.
| 表2 HOPE和MAPLE-HOPE在各类场景中的成功率 Table 2 Success rates of HOPE and MAPLE-HOPE on different scenarios |
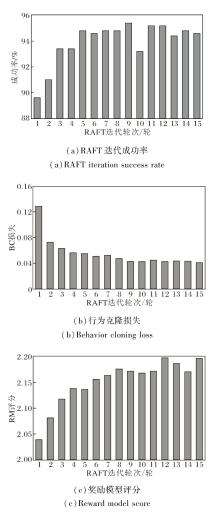
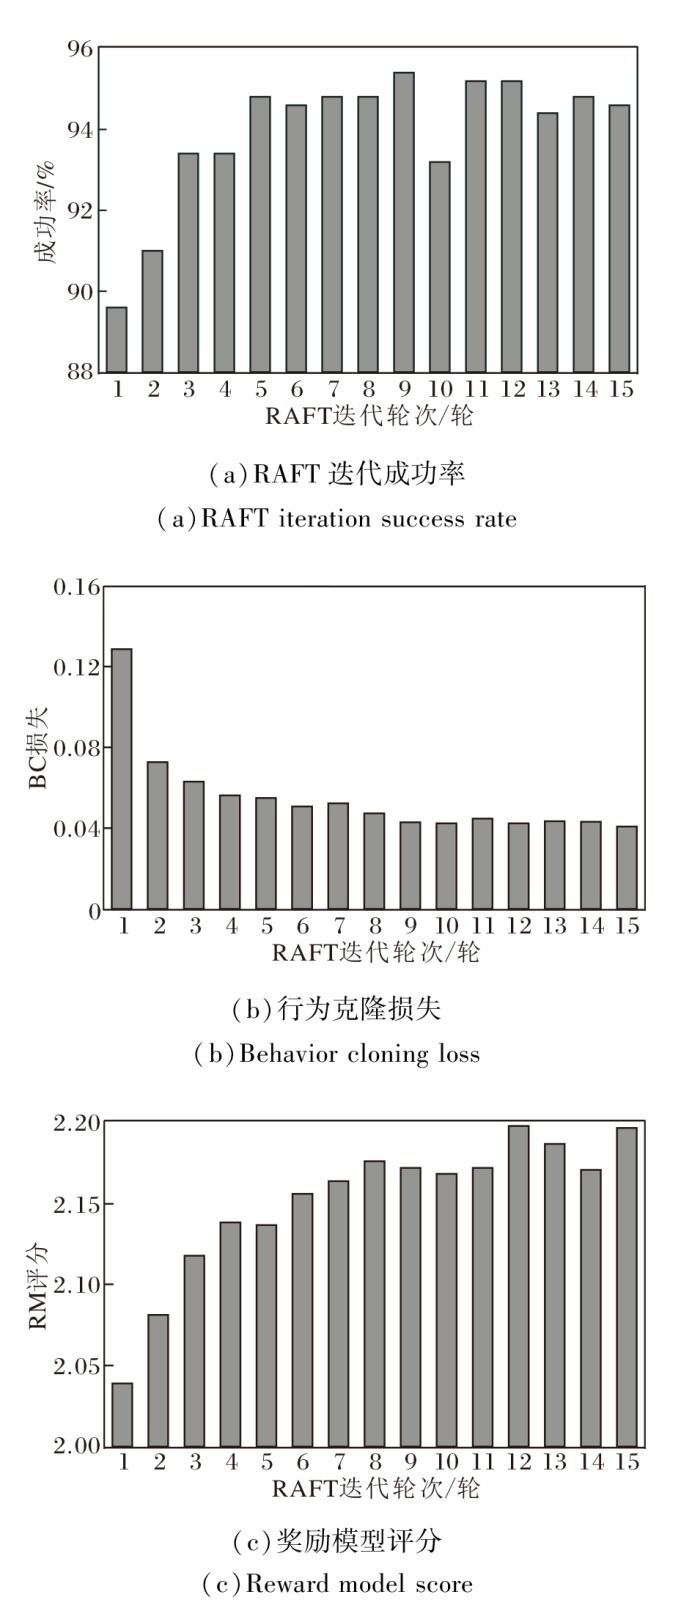
每个场景按奖励模型评分选取前2条成功轨迹(K=2)时, RAFT[8]的训练记录及最终评估结果如图4所示.第1~14轮作为训练过程中的在线监控记录, 成功率在前5轮由89.6%升至94.8%, 随后进入高性能平台.直到第15轮训练完成后, 模型再次在统一的500个场景评估流程下获得的最终成功率为94.6%.行为克隆损失随迭代执行呈整体下降趋势, 说明筛选后的轨迹示范能够被策略网络稳定拟合.
 | 图4 RAFT训练记录与最终评估结果Fig.4 Training records and final evaluation results of RAFT |
实验根据Top-K决定每个场景保留多少条成功候选轨迹作为后续行为克隆的示范.实验先尽量为每个采样场景收集最多10条成功候选轨迹, 再在同一候选池中按RM评分选取前K条.为了避免再次引入人工权重, 针对表3中不同物理量放弃加权求和, 而是使用倒数排名融合(Reciprocal Rank Fusion, RRF)汇总各项成功轨迹质量的排名, 相应公式如下:
$R R F=\sum_{i} \frac{1}{60+r_{i}}, $
其中, i表示评价指标索引, ri表示当前 K 配置在第i项指标上相对于所有候选K配置的排名, 最优者排名为1.步数、换向次数和震荡指数按升序排名, 路径效率和最小间距按降序排名.常数60为排名平滑参数, RRF得分越大表示综合排名越优.
| 表3 Top-K单轮敏感性指标对比 Table 3 Comparison of Top-K one-round sensitivity metrics |
根据Top-K敏感性结果, 固定候选轨迹池、K=2、单轮RAFT更新和500个测试场景, 仅替换每个场景内成功轨迹的排序依据, 对比不同轨迹筛选准则.4种筛选准则如下:RM评分rbase+δ 、人工规则评分、原环境累计回报、随机抽取成功轨迹.相应轨迹筛选准则如表4所示.
| 表4 单轮K=2时轨迹筛选准则 Table 4 One-round K=2 trajectory-selection criteria |
表4仅在成功轨迹上统计质量, 因为后续行为克隆阶段仅使用成功示范轨迹.K=10时单轮成功率最高, 但其成功轨迹的换向次数、震荡指数和最小间距均不占优.K=3时虽然成功率高于K=2时, 但成功轨迹步数、换向次数、震荡指数和路径效率均较差.当K=2时, 模型在保持接近成功率的同时, 取得最低换向次数、最低震荡指数和最高路径效率, 更符合后续行为克隆阶段对示范轨迹质量的需求.因此本文沿用K=2作为主流配置.
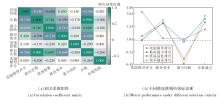
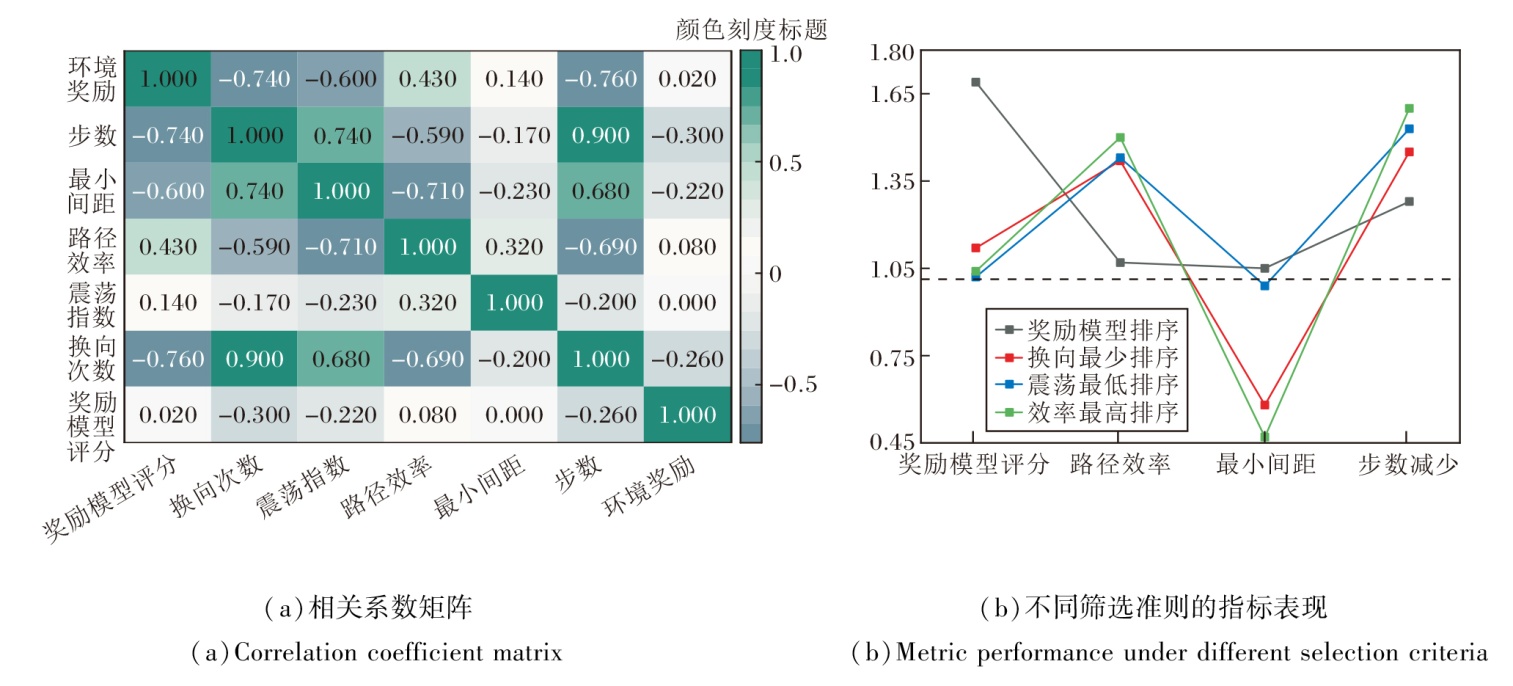
基于奖励模型训练阶段候选轨迹池的描述性统计如图5所示, 该图可解释RM评分的行为含义.(a)中显示:RM评分与换向次数、震荡指数和步数的Pearson相关系数分别为-0.740、-0.600和-0.760, 与路径效率的相关系数为0.430, 与最小间距的相关系数为0.140; RM评分与环境累计回报的线性相关性接近于0(r=0.02).这表明RM评分吸收减少反复调整、缩短执行过程和提高路径效率等行为偏好, 并非环境累计回报或任一单项物理指标的简单替代.
图5(b)进一步按RM评分、换向最少、震荡最低和效率最高分别选取前100条轨迹时的相对指标表现, 虚线1.00表示候选轨迹池总体均值.按RM评分筛选的轨迹在RM评分、路径效率、最小间距和步数减少量上的相对值分别为1.69、1.07、1.05和1.28; 单项物理指标排序可在对应维度取得更极端的结果, 但通常伴随其它维度下降.该结果与表4相互补充:RM的作用是提供多目标折衷排序, 而不是对某一人工指标进行机械优化.
 | 图5 奖励模型评分与物理指标的相关性及不同筛选准则的相对表现Fig.5 Correlation between reward-model scores and physical metrics, and relative performance under different selection criteria |
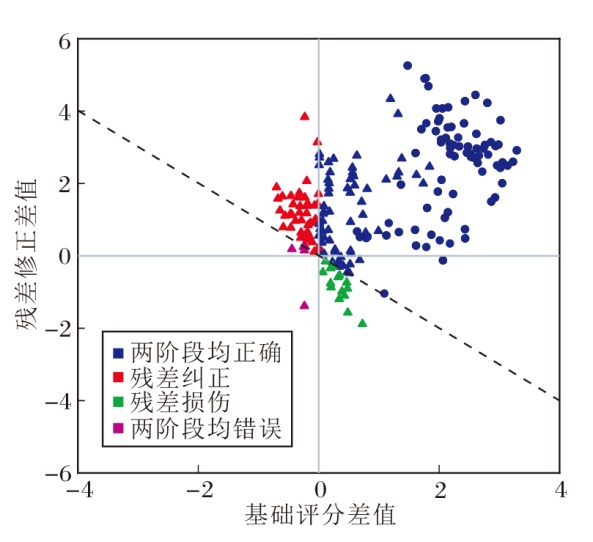
基于1 367组已接受偏好对, 以20个随机种子分别进行无放回划分, 每次取15%作为验证集, 即每次纳入205对, 计算均值± 标准差.第1阶段方法在验证集上的总体偏好预测准确率为72.6%± 2.9%, 加入第2阶段偏好残差头后准确率升至91.2%± 2.0%.对于成功-成功轨迹对, 准确率由56.0%± 4.2%升至85.7%± 3.3%, 提升29.7%; 对于成功-失败轨迹对, 两者均为100.0%.
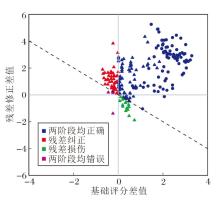
将随机种子设为42时, 固定验证集上的基础评分差值与残差修正差值分布如图6所示, 共205对, 其中成功-失败79对(图中用○表示)、成功-成功126对(图中用△ 表示).
 | 图6 两阶段奖励模型的基础评分差值与残差修正差值分布Fig.6 Distribution of base-score differences and residual-correction differences in two-stage reward model |
为了使所有散点具有一致方向, 横轴定义为LLM集成标记的更优轨迹相对另一条轨迹的基础评分差值:
$g_{\text {base }}=r_{\text {base }}^{w}-r_{\text {base }}^{l} .$
纵轴定义为残差修正差值:
$g_{\delta}=\delta^{w}-\delta^{l} .$
其中:
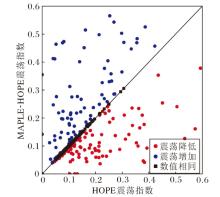
HOPE和MAPLE-HOPE均完成泊车时的逐场景震荡指数如图7所示.图中散点位于对角线下方表示震荡较低, 位于对角线上方表示震荡较高.由于样本主要分布在低震荡区间, 聚焦该区间以便观察密集区域的变化.共同成功场景的平均震荡指数由0.132 9降至0.127 5, 降幅为4.0%.
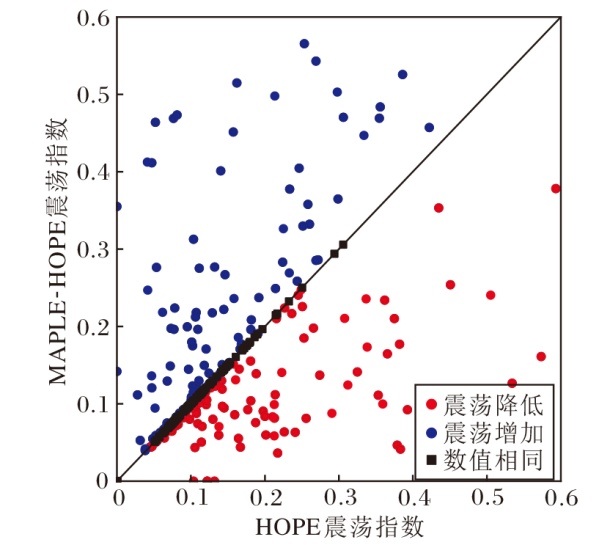 | 图7 HOPE与MAPLE-HOPE的逐场景震荡指数对比Fig.7 Per-scene oscillation-index comparison between HOPE and MAPLE-HOPE |
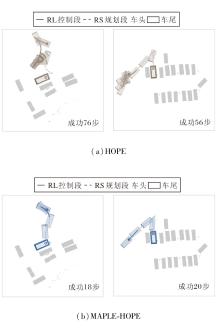
HOPE和MAPLE-HOPE在2个代表性泊车场景中的完整执行轨迹如图8所示.
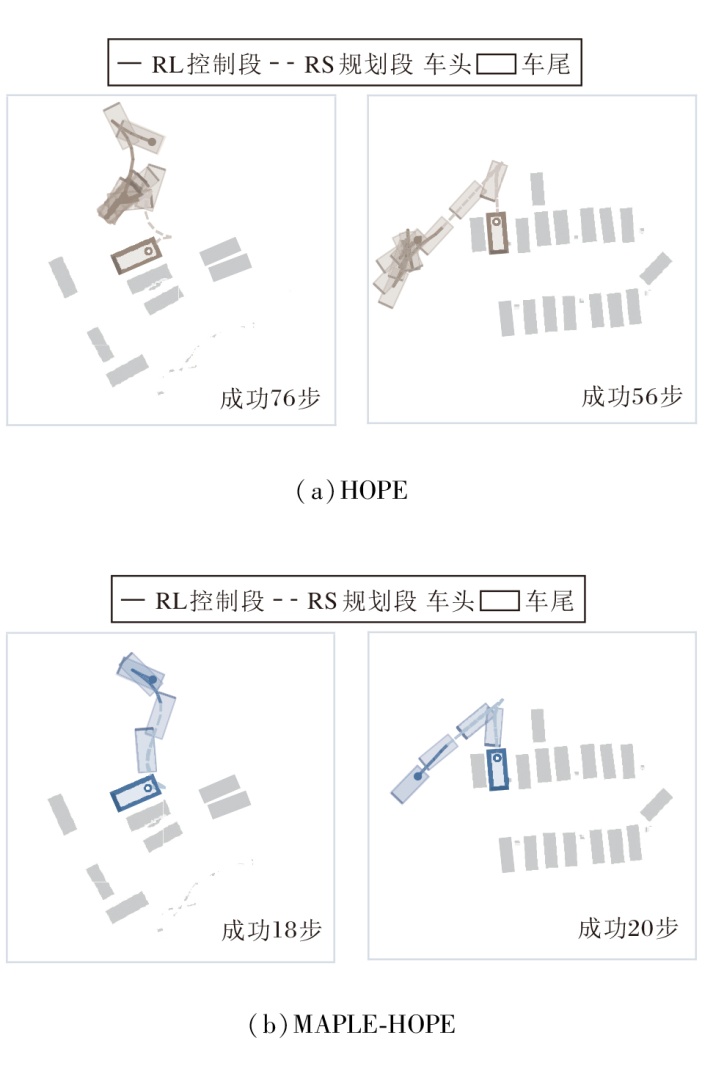 | 图8 HOPE与MAPLE-HOPE的典型场景轨迹对比Fig.8 Trajectory comparison between HOPE and MAPLE-HOPE in representative scenarios |
由图8可见, 两种方法在示例中均成功到达目标车位.相比HOPE, MAPLE-HOPE将执行步数分别由76步减至18步和由56步减至20步, 轨迹中的往复调整明显减少.
为了进一步审计LLM标签与人工直观偏好的一致性, 本文开发一个前端标注界面, 让标注者在同一起点、终点和障碍物条件下对两条候选轨迹进行A/B偏好选择.界面使用A/B匿名编号, 不显示生成方法、任务成败标签、LLM判断或奖励模型评分, 以此减少方法先验和答案提示造成的偏差.100组题目由9名人工标注者独立完成, 每名标注者均对全部题目作答.
从成功-成功质量比较和成功-失败比较两类样本中无放回分层抽取100组题目, 并额外纳入10组四模型投票仅3∶ 1的低共识难例, 同时限制同一场景最多入选2组.最终集合包含70组成功-成功质量比较和30组成功-失败比较, 用于审计LLM标签与人工直观偏好的一致性.9名标注者的Fleiss' κ =0.583, 平均两两一致率为79.9%.在100组样本中, 人类多数意见与LLM集成标签一致的有87组, 一致率为87.0%.当人类多数达到6∶ 3及以上时, 一致率为89.0%; 人类多数达到7∶ 2及以上时, 一致率为91.7%; 在8∶ 1或9∶ 0的更强一致样本中, 一致率为95.6%.人工投票强度分布为44组9∶ 0、24组8∶ 1、16 组7∶ 2、7组6∶ 3和9组5∶ 4.
在类型上看:30组成功-失败对中人类多数与LLM集成标签全部一致; 13组分歧均来自70组成功-成功质量比较.该结果说明:LLM集成能稳定识别明显的任务成败差异; 剩余分歧主要涉及安全裕度、路径效率、终端自然性和平滑性之间的多目标权衡.因此, LLM偏好标签可作为大规模一致标注信号.
实验表明, LLM既可用于在线决策或控制生成, 也可作为离线偏好标注信号, 通过奖励建模影响混合策略的行为质量.对于HOPE, 先在轨迹层面对行为偏好进行排序, 再将高质量示范反馈给策略网络, 是一种较易嵌入现有系统的策略优化路径.实验中成功率提升主要来自中等场景和困难场景, 说明偏好筛选并未只强化简单场景中的保守行为, 而是有助于减少复杂泊车过程中的无效往复调整.
本文仍有如下局限.1)实验基于静态障碍物场景, 并不能给出存在动态交通参与者条件下的结论.2)人工一致性实验使用难例增强的分层样本, 并不能代表专业驾驶员或一般驾驶人群的总体偏好.3)500个场景评估能支持当前仿真设置下的结论, 但仍需在真实车辆和感知噪声条件下验证sim-to-real鲁棒性.
本文提出基于大语言模型语义评判的奖励建模与自动泊车策略优化方法(MAPLE), 包括跨模态偏好特征提取与LLM集成标注、两阶段奖励模型训练及场景定向RAFT精调.在500个场景配对评估中, 应用MAPLE得到的MAPLE-HOPE泊车成功率为94.6%, 相比采用相同闭环评估流程的HOPE(成功率为88.8%), 提升5.8%, 单次泊车过程中车辆平均前进-后退切换次数降低39.5%.
RAFT的离线行为克隆机制适合包含不可微规划器步骤的混合泊车架构.在仿真评估设置下, LLM标注、RM蒸馏与RAFT精调能把果断入位、减少犹豫等难以直接写成标量奖励的偏好转化为可训练信号, 并传递至策略网络.今后可从如下3个方面开展研究.1)在真实车辆及包含动态交通参与者和感知噪声的场景中验证MAPLE从仿真到真实场景的迁移鲁棒性.2)扩大人工偏好评测规模, 纳入具有不同驾驶经验的标注者, 分析不同人群的偏好差异.3)研究奖励模型的不确定性估计与在线更新机制, 进一步提升其在分布外复杂场景中的可靠性和安全性.
本文责任编委 李贻斌
Recommended by Associate Editor LI Yibin
| [1] |
|
| [2] |
|
| [3] |
|
| [4] |
|
| [5] |
|
| [6] |
|
| [7] |
|
| [8] |
|
| [9] |
|
| [10] |
|
| [11] |
|
| [12] |
|
| [13] |
|
| [14] |
|
| [15] |
|
| [16] |
|
| [17] |
|
| [18] |
|
| [19] |
|
| [20] |
|
| [21] |
|
| [22] |
|
| [23] |
|
| [24] |
|
| [25] |
|
| [26] |
|
| [27] |
|
| [28] |
|
| [29] |
|
| [30] |
|
| [31] |
|
| [32] |
|
| [33] |
|
| [34] |
|
| [35] |
|