

基于安全增强交互建模的异构智能体轨迹预测方法
[李茜茜1, 2  , 任明仑
1, 2 ]
, 任明仑]
|
|


作者简介:
李茜茜,博士研究生,主要研究方向为自动驾驶车辆风险感知与轨迹预测.E-mail: 2023030080@mail.hfut.edu.cn.
在城市无信号交叉口等复杂场景中,自动驾驶车辆需与多类智能体密集交互,因此异构智能体的同步轨迹预测对行车安全与效率至关重要.现有方法忽略异构智能体交互中动态变化的风险因素,导致预测安全性和准确性不足.为此,文中提出基于安全增强交互建模的异构智能体轨迹预测分层方法(Heterogeneous Agent Trajectory Prediction Method Based on Safety-Enhanced Interaction Modeling, SEIM),综合考虑交互风险、异构交互特性、道路环境及个体动态.风险感知层采用基于安全势场的风险评估指标表征交互风险,提取交互风险特征.异构交互层构建两个异构图,设计异构交互编码器,提取异构交互特征,并引入基于安全势场的风险值作为安全增强有向边特征异构图的边属性,增强图结构的边特征.道路环境层基于构建的有向图提取道路结构特征.个体动态层提取智能体的个体动态特征.4类特征融合后输入轨迹解码器中,预测异构智能体的未来轨迹.在inD数据集上的实验表明SEIM在异构智能体轨迹预测中的有效性与准确性.
About Author:
LI Xixi, Ph.D. candidate. Her research interests include risk perception and trajectory prediction for autonomous vehicles.
In complex scenarios such as urban unsignalized intersections, autonomous vehicles interact intensively with heterogeneous agents. Synchronous trajectory prediction of heterogeneous agents is crucial for driving safety and efficiency. Existing methods neglect dynamic risk factors during interactions, resulting in insufficient prediction safety and accuracy. A heterogeneous agent trajectory prediction method based on safety-enhanced interaction modeling(SEIM) is proposed. Interaction risk, heterogeneous interaction characteristics, road environment, and individual dynamics are jointly considered. In the risk perception layer, interaction risks are characterized via the safety potential field and interaction risk features are extracted. In the heterogeneous interaction layer, two heterogeneous graphs are constructed and a heterogeneous interaction encoder is designed to capture heterogeneous interaction features. Safety potential field-based risk values are introduced as edge attributes of the safety- enhanced directed edge-feature heterogeneous graph to enhance edge features of the graph structure. In the road environment layer, road structure features are extracted from the directed graph. In the individual dynamic layer, individual motion features are captured. The four types of features are fused and fed into trajectory decoders to predict future trajectories of heterogeneous agents. Experiments on the inD dataset demonstrate the effectiveness and accuracy of SEIM in heterogeneous agent trajectory prediction.
得益于人工智能、传感器和车联网(Vehicle-to-Everything, V2X)等技术的突破, 自动驾驶技术现已成为提升通行效率、降低事故率的关键技术之一.在城市交叉口, 尤其是无信号交叉口, 路权不明确导致自动驾驶车辆与异构智能体(周围车辆、行人和骑行人)高度交互, 驾驶风险显著上升[1].准确预测异构智能体的轨迹, 对增强决策可靠性、保障通行安全至关重要.
目前轨迹预测方法主要分为基于物理模型的方法、基于机动的方法和交互感知方法[2].基于物理模型的方法利用动力学与运动学方程预测短期轨迹[3], 难以处理行为不确定性高的行人和骑行人, 且无法建模交互.基于机动的方法通过识别变道、转弯等机动行为预测轨迹, 采用统计学习或神经网络进行机动识别, 并结合高斯过程等生成轨迹[4].该类方法虽然优化长期预测效果, 但因单独建模各智能体而忽视交互关系.
在复杂交通场景中, 多智能体之间的相互作用不可忽视.近年来, 交互感知方法受到关注并发展出多种交互关系表征方式.Alahi等[5]提出Social LSTM, 通过社会池化层捕捉多智能体的社会交互.Agrim等[6]提出Social GAN, 结合生成对抗网络与社会关系, 生成符合社会规范的多模态轨迹.部分研究还在社会交互中加入对时间依赖性的处理[7].
然而, 上述方法难以显式刻画交互关系.为此, 学者提出基于图的交互表示方法, 节点对应交通参与者, 边定义节点间的交互关系.早期研究采用齐次图建模交互关系, 但忽略智能体类型差异[8].一些研究提出异构图表示方法, 却忽略边属性或边类型[9, 10].近期研究构建融合节点异质性、边属性和边类型的有向边特征异构图, 并设计HEAT(Heteroge-neous Edge-Enhanced Graph Attention Network)[11]和HDR-MAT(Heterogeneous Dynamic Relational Reaso-ning Graph Attention Network)[12]等图神经网络(Graph Neural Networks, GNNs), 提取异构智能体交互特征.但是, 这些有向边特征异构图均采用相对位置、速度和航向角这些简单的相对测量值作为边属性, 忽略智能体之间动态变化的风险因素, 限制预测轨迹的安全性.同时, 这些GNNs难以充分处理异构智能体的位置交互信息和运动交互信息, 限制预测精度的提升.
安全风险作为可量化的指标, 为进一步增强异构智能体交互关系建模提供可能性.目前已有多种风险评估指标, 如基于时间的指标、基于势场的指标和基于统计的指标[13].一些研究尝试将安全风险指标融入预测模型中.碰撞时间(Time-to-Collision, TTC)作为简单高效的指标, 被广泛纳入预测过程中.Fang等[14]利用TTC计算异构风险图的交互邻接矩阵.Sun等[15]提出HRGC(Heterogeneous Risk-Aware Graph Encoder with Continuous Parameterized Decoder for Trajectory Prediction), 设计异构风险感知边缘增强的图编码器, 计算节点间TTC, 增强边特征.
上述方法依赖于对交通环境和智能体状态的简化假设, 难以适用于智能体非规则运动的无信号交叉口.王建强等[16]提出人-车-路闭环系统的行车风险场, 为解决这一问题提供方向.基于安全势场理论的风险评估方法借鉴物理学中的势场理论, 利用排斥力场描述碰撞风险[17, 18].近期工作开始引入基于势场的风险评估方法.Liu等[19]提出DRM-DL(Driving Risk Map-Integrated Deep Learning), 利用构建的驾驶风险地图实现车辆与车辆及车辆与环境的交互表示, 但难以表征异构智能体交互关系.Li等[20]提出TMSTFF(Transformer Model Based on Spa-tio-Temporal Feature Fusion), Geng等[21]提出mm-STTN(Multimodal Spatial-Temporal Transformer Net-work), 将势场风险作为模型训练的损失, 生成风险规避的轨迹, 但未在轨迹生成阶段编码驾驶风险.这些将基于势场的风险评估指标融入预测的方法均缺乏表征多智能体异构关系的能力, 且未充分提取交互风险特征.如何利用基于势场的风险评估指标有效增强异构智能体交互关系建模值得进一步探索.
为此, 本文提出基于安全增强交互建模的异构智能体轨迹预测方法(Heterogeneous Agent Trajec-tory Prediction Method Based on Safety-Enhanced Inter-action Modeling, SEIM), 包含风险感知层、异构交互层、个体动态层和道路环境层, 综合考虑异构智能体的个体动态、交互风险、道路环境信息及异构交互特性.考虑到异构智能体交互中的安全风险变化的潜在特性, 在风险感知层采用基于安全势场的风险评估指标表征异构智能体交互风险, 并利用风险感知编码器提取交互风险特征, 提升预测准确性与安全性.为了进一步增强对异构智能体之间的动态交互风险感知的能力, 并充分捕捉异构智能体的位置交互信息和多维运动信息, 在异构交互层构建有向边特征异构图和安全增强有向边特征异构图, 并设计基于安全增强双重动态异构图注意力网络(Safety-Enhanced Dual Dynamic Heterogeneous Graph Atten-tion Network, SDDHGAT)的异构交互编码器, 提取异构交互特征.引入基于安全势场的风险值作为安全增强有向边特征异构图的边属性, 增强该图结构的边特征, 进一步提高预测精度, 并且生成的预测轨迹在定义的风险度量指标下具有较低的风险水平.在inD数据集[22]上的实验表明, SEIM在长时域预测任务中取得较优的预测准确性.风险评估实验验证SEIM预测轨迹的低风险特性.消融研究验证关键模块的有效性, 尤其是风险感知层与安全增强边特征的贡献.
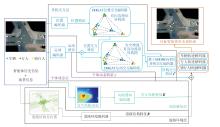
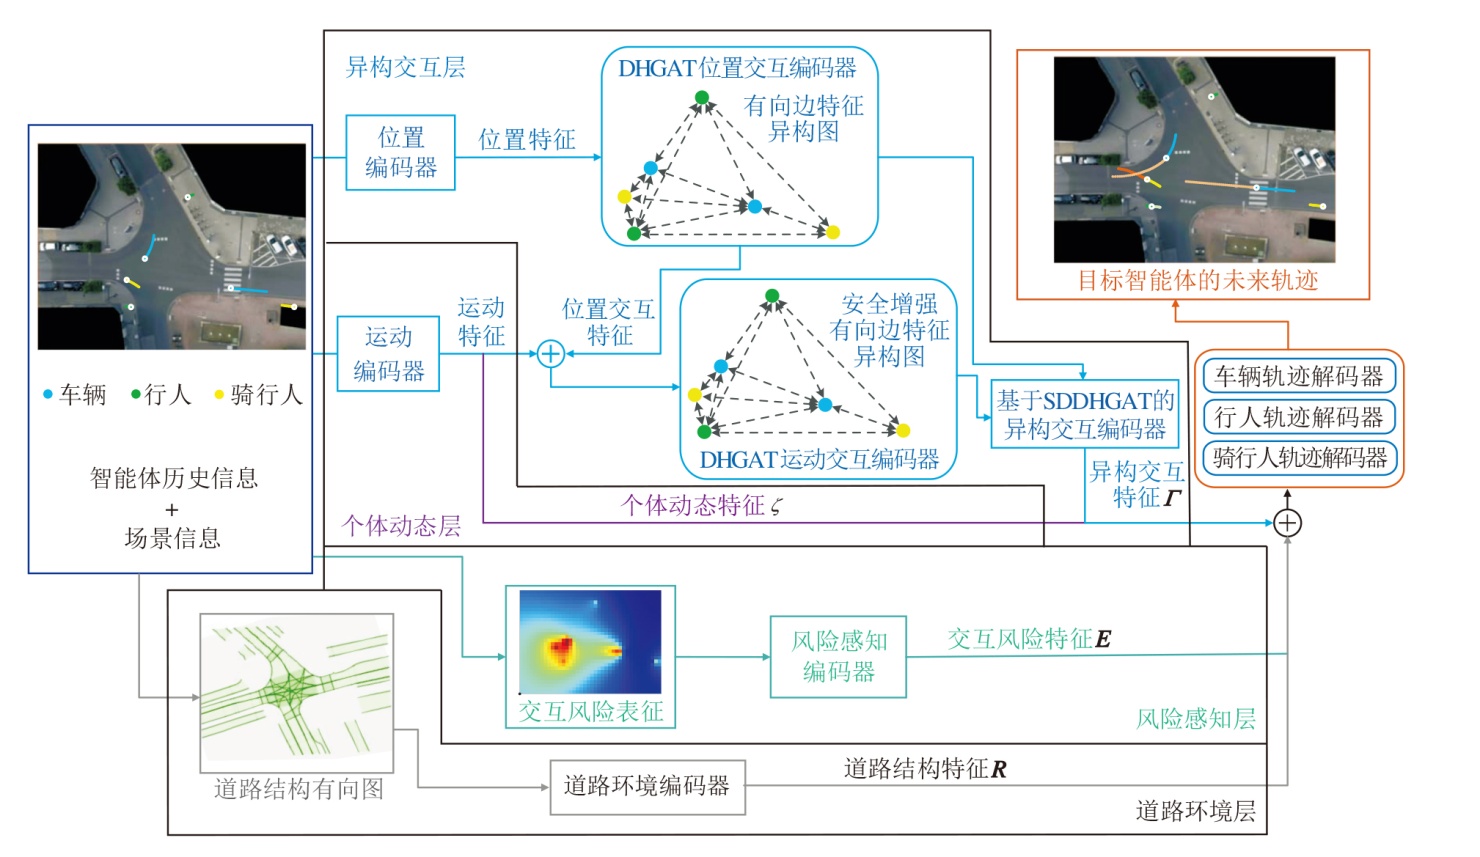
本文提出基于安全增强交互建模的异构智能体轨迹预测方法(SEIM), 整体架构如图1所示.SEIM由风险感知层、异构交互层、个体动态层、道路环境层构成.
 | 图1 SEIM架构图Fig.1 Architecture of SEIM |
风险感知层采用基于安全势场的风险评估指标表征智能体交互风险, 并利用风险感知编码器提取交互风险特征.异构交互层构建基于位置信息的有向边特征异构图和基于运动信息的安全增强有向边特征异构图, 并设计基于安全增强双重动态异构图注意力网络(SDDHGAT)的异构交互编码器, 提取异构交互特征.个体动态层利用运动编码器从智能体运动信息中提取智能体的个体动态特征.道路环境层将道路拓扑结构建模为有向图, 并利用道路环境编码器提取道路结构特征.融合上述4类特征后输入轨迹解码器, 生成目标智能体的未来轨迹.
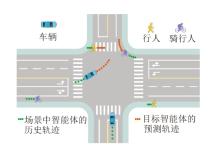
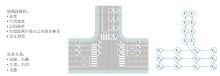
本文的异构智能体(即目标智能体)的轨迹预测问题是指在无信号交叉口场景中根据智能体(包括目标智能体及其周围交通参与者)之间的历史信息及环境信息, 预测目标智能体的未来轨迹, 示例如图2所示.
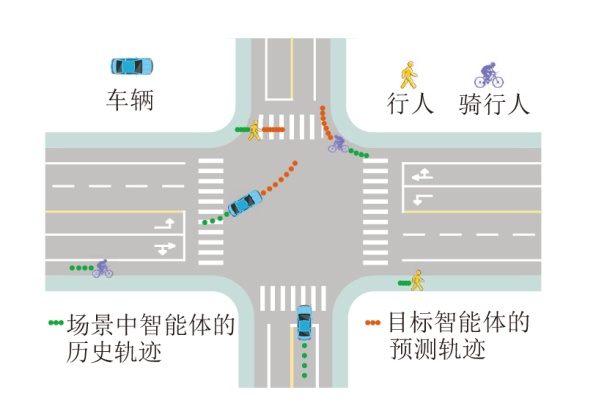 | 图2 无信号交叉口场景的异构智能体轨迹预测示例Fig.2 Illustration of heterogeneous agent trajectory prediction at a non-signalized intersection |
在一个时间步p时, 输入
$ \boldsymbol{I}_{p}=\left\{\boldsymbol{S}_{p}, M^{\prime}\right\}, $
其中:
$ \boldsymbol{S}_{p}=\left\{\boldsymbol{S}_{t}^{i} \mid i=1, 2, \cdots, m\right\}_{t=p-T_{h}+1}^{p}$
表示在时间步p时m个智能体在过去Th时间步长的历史状态,
$ \boldsymbol{S}^{i}=\left\{x_{t}^{i}, y_{t}^{i}, v_{x, t}^{i}, v_{y, t}^{i}, a_{x, t}^{i}, a_{y, t}^{i}, \varphi_{t}^{i}\right\}_{t=p-T_{h}+1}^{p}, $
表示智能体i的历史状态,
输出Op包含n个目标智能体未来Tf时间步长的预测轨迹:
$ \boldsymbol{O}_{p}=\left\{\widehat{\boldsymbol{F}}_{t}^{j} \mid j=1, 2, \cdots, n\right\}_{t=p+1}^{p+T_{f}}, $
其中,
$ \widehat{\boldsymbol{F}}_{t}^{j}=\left\{\hat{x}_{t}^{j}, \hat{y}_{t}^{j}\right\}_{t=p+1}^{p+T_{f}}$
表示智能体j的预测轨迹,
风险感知层旨在探索异构智能体交互中安全风险变化的潜在特性, 提升预测准确性与安全性.本文采用基于势场的风险评估指标表征异构智能体交互风险, 并利用风险感知编码器提取交互风险特征.
每个智能体会在道路空间中形成潜在的风险分布, 即风险场.首先, 对场景进行点采样, 即在场景交互范围内定义一个矩形感兴趣区域, 并采用均匀网格采样策略对该区域进行离散化处理.具体而言:首先, 以固定空间步长将该区域划分为二维网格, 每个网格节点作为一个采样点.然后, 利用基于势场的风险评估指标计算每个采样点处的安全势能, 即量化的风险.根据安全势场理论[16, 18], 场景中的每个点处的安全势能是所有智能体产生的风险场在该点处的场强的累积.对于场景中点q=(xq, yq), 此处的安全势能
$ E_{q}=\left|\sum_{i=1}^{m} \boldsymbol{E}_{i q}\right|$ (1)
表示所有智能体在该点产生的场强累计值, 其中,
$ \boldsymbol{E}_{i q}=M_{i} \frac{\boldsymbol{r}_{i q}}{\left|\boldsymbol{r}_{i q}\right|} \cdot \frac{\exp \left(l_{2} v^{i} \cos \theta^{i}\right)}{\left|\boldsymbol{r}_{i q}\right|^{l_{1}}}, $
表示智能体i在q点产生的场强(即潜在危险程度), 场强方向与riq相同,
$ M_{i}=\left\{\begin{array}{ll} m_{i}\left[1.566 \times 10^{-14}\left(v^{i}\right)^{6.687}+0.3345\right], & i \text { 为车辆 } \\ m_{i}, & i \text { 为行人或骑行人 } \end{array}\right.$
表示智能体i的等效质量, mi表示智能体i的实际质量, vi表示智能体i的速度, riq=(xq-xi, yq-yi)表示智能体i到点q的距离向量, |riq|表示智能体i和点q之间的欧几里得距离, θ i表示智能体i的运动方向与riq的夹角, l1、l2表示待定系数.
利用式(1)求得各采样点处的安全势能, 得到由离散的安全势点组成的数值图像或矩阵.在既定场景范围内, 采样点越多, 图像蕴含的交互风险信息也就越详细、丰富.
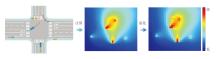
交叉口中智能体的安全势场的量化数值图像如图3所示, 图中颜色越深表示安全势能越高, 即风险越大.
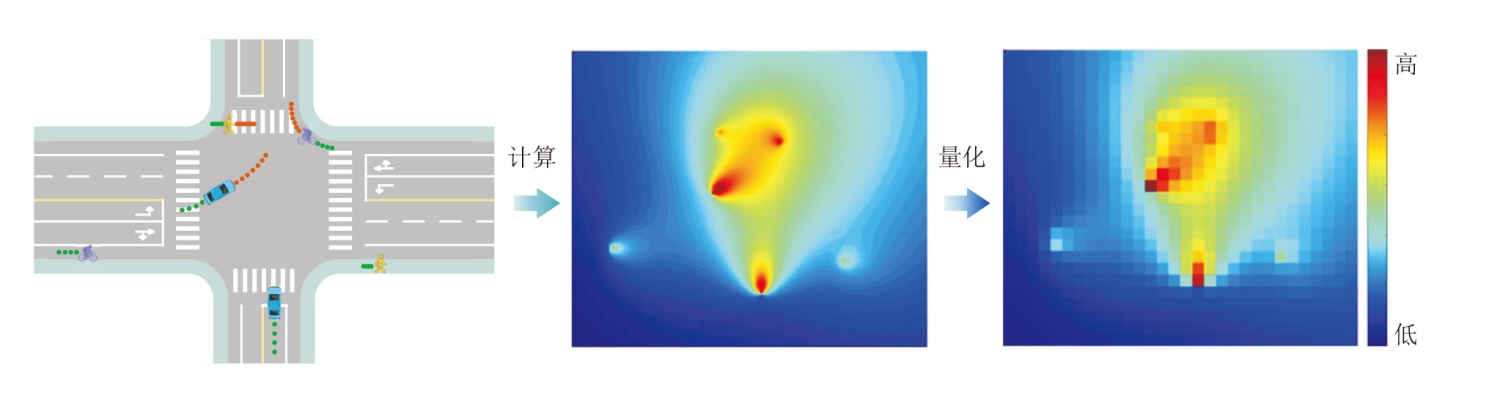 | 图3 交叉口中智能体安全势场的量化数值图像Fig.3 Quantified numerical image of safety potential field of agents at an intersection |
最后, 利用风险感知编码器处理所有历史时刻的数值图像.先利用卷积神经网络(Convolutional Neural Network, CNN)提取每个历史时刻的数值图像的风险特征.再将所有历史时刻的风险特征输入GRU(Gated Recurrent Unit)编码器中, 最终得到交互风险特征E.
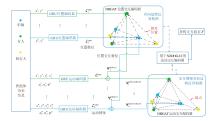
为了充分处理异构智能体的位置交互信息和运动交互信息, 并增强对动态交互风险感知的能力, 设计基于SDDHGAT的异构交互编码器, 提取异构交互特征.该编码器根据构建的有向边特征异构图和安全增强有向边特征异构图, 由GRU位置编码器、动态异构图注意力网络(Dynamic Heterogeneous Gra-ph Attention Network, DHGAT)位置交互编码器、GRU运动编码器、DHGAT运动交互编码器构成.首先, 利用GRU位置编码器处理历史位置数据, 提取位置特征.再基于有向边特征异构图, 利用DHGAT位置交互编码器提取位置交互特征, 其中节点特征由位置特征组成.然后, 利用GRU运动编码器处理历史运动数据, 提取运动特征.最后, 基于安全增强有向边特征异构图, 利用DHGAT运动交互编码器提取异构交互特征Γ , 其中节点特征由运动特征和位置交互特征组成.异构交互层的整体架构如图4所示.
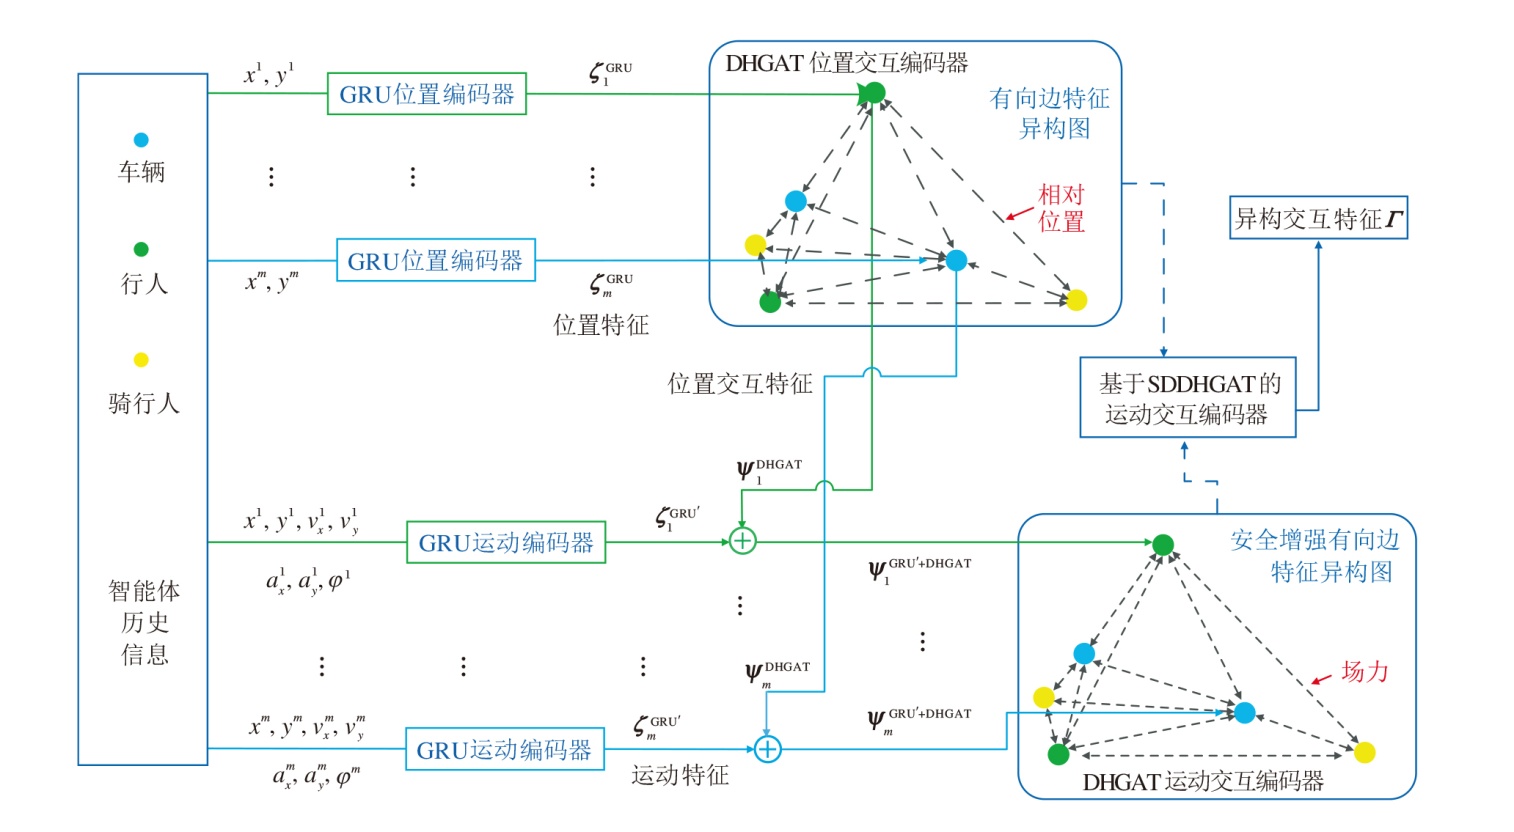 | 图4 异构交互层架构图Fig.4 Architecture of heterogeneous interaction layer |
1.3.1 GRU位置编码器
位置(横坐标和纵坐标)是轨迹的基本要素, 表示智能体在某个时刻的具体坐标.对于智能体i(i=1, 2, …, m), 利用GRU处理其在t(t=p-Th+1, p-Th+2, …, p)时刻的历史位置数据
$ \left\{\left(x_{1}^{i}, y_{1}^{i}\right), \left(x_{2}^{i}, y_{2}^{i}\right), \cdots, \left(x_{t}^{i}, y_{t}^{i}\right)\right\}, $
得到位置特征
1.3.2 DHGAT位置交互编码器
DHGAT位置交互编码器用于从智能体位置的角度捕捉异构智能体的时空交互信息.编码器输入有向边特征异构图G=(V, E).
$ \boldsymbol{V}=\left\{\boldsymbol{\zeta}_{1}^{\mathrm{GRU}}, \cdots, \boldsymbol{\zeta}_{i}^{\mathrm{GRU}}, \cdots, \boldsymbol{\zeta}_{m}^{\mathrm{GRU}}\right\}, $
表示节点特征, 由智能体的位置特征组成, 并且每个节点都属于特定类型.
$ \boldsymbol{E}=\left\{\boldsymbol{e}_{i k} \mid i=1, 2, \cdots, m ; k \in \Lambda_{i}\right\}, $
表示边特征, 由智能体之间的有向边组成, 其中, eik表示一条从智能体k指向智能体i的有向边, 且智能体k在智能体i的位置邻域范围内, Λ i表示智能体i的位置邻域.边特征eik由边属性
$ \boldsymbol{e}_{i k}=\left[e_{i k}^{\text {value }} \| e_{i k}^{\text {type }}\right] .$
其中:边属性
$ e_{i k}^{\text {value }}=\left(\left|x^{i}-x^{k}\right|^{2}+\left|y^{i}-y^{k}\right|^{2}\right)^{\frac{1}{2}}$
表示智能体k到智能体i的相对位置的值; 边类型
理论上, 智能体之间的距离越近, 相互影响越大, 而相距较远的智能体之间的影响可忽略不计.因此, 对于智能体i, 根据智能体k与其之间的距离可确定智能体i的位置邻域Λ i.定义
$ \delta_{i k}=\left\{\begin{array}{ll} 1, & \left|x^{i}-x^{k}\right| \leqslant L_{x} \text { and }\left|y^{i}-y^{k}\right| \leqslant L_{y} \\ 0, & \text { 其它 } \end{array}\right.$ (2)
用于判断智能体k是否在智能体i的位置邻域Λ i内, 其中Lx、Ly分别表示智能体i和智能体k之间的横向距离阈值和纵向距离阈值.若δ ik=1, 智能体k在智能体i的位置邻域Λ i内, 否则不在.
将所有历史时刻的有向边特征异构图输入DHGAT位置交互编码器中.先将每个历史时刻的有向边特征异构图输入异构图注意力网络[11, 23]中, 得到每个历史时刻聚合和更新后的节点特征.再将每个历史时刻更新后的节点特征按照时间序列输入基于GRU的时序建模模块, 最终得到节点的位置交互特征
$ \boldsymbol{\psi}=\left\{\boldsymbol{\psi}_{1}^{\mathrm{DHGAT}}, \cdots, \boldsymbol{\psi}_{i}^{\mathrm{DHGAT}}, \cdots, \boldsymbol{\psi}_{m}^{\mathrm{DHGAT}}\right\} .$
位置交互特征将作为DHGAT运动交互编码器节点特征的一部分.
1.3.3 GRU运动编码器
为了充分提取智能体的运动特征, 除了位置以外, 还考虑速度(横向速度和纵向速度)、加速度(横向加速度和纵向加速度)和航向角.综合考虑位置、速度、加速度和航向角之间的关系有利于准确预测智能体的轨迹.对于智能体i(i=1, 2, …, m), 利用GRU处理其在t(t=p-Th+1, p-Th+2, …, p)时刻的历史运动数据
$ \begin{array}{l} \left\{\left(x_{1}^{i}, y_{1}^{i}, v_{x, 1}^{i}, v_{y, 1}^{i}, a_{x, 1}^{i}, a_{y, 1}^{i}, \varphi_{1}^{i}\right), \left(x_{2}^{i}, y_{2}^{i}, v_{x, 2}^{i}, v_{y, 2}^{i}, a_{x, 2}^{i}, \right.\right. \\ \left.\left.a_{y, 2}^{i}, \varphi_{2}^{i}\right), \cdots, \left(x_{t}^{i}, y_{t}^{i}, v_{x, t}^{i}, v_{y, t}^{i}, a_{x, t}^{i}, a_{y, t}^{i}, \varphi_{t}^{i}\right)\right\}, \end{array}$
得到运动特征
1.3.4 DHGAT运动交互编码器
DHGAT运动交互编码器用于提取异构智能体多维运动特征, 进一步提升预测精确性和安全性.编码器输入安全增强有向边特征异构图G'=(V', E').值得注意的是, 为了增强SEIM对异构智能体之间的动态交互风险的感知能力, 利用基于势场的风险评估指标增强该图结构的边特征.
$ \boldsymbol{V}^{\prime}=\left\{\boldsymbol{\psi}_{1}^{\mathrm{GRU}^{\prime}+\text { DHGAT }}, \cdots, \boldsymbol{\psi}_{i}^{\mathrm{GRU}^{\prime}+\text { DHGAT }}, \cdots, \boldsymbol{\psi}_{m}^{\mathrm{GRU}^{\prime}+\mathrm{DHGAT}^{\prime}}\right\}$
表示节点特征, 由智能体的运动特征
$ \left\{\boldsymbol{\zeta}_{1}^{\mathrm{GRU}^{\prime}}, \cdots, \boldsymbol{\zeta}_{i}^{\mathrm{GRU}^{\prime}}, \cdots, \boldsymbol{\zeta}_{m}^{\mathrm{GRU}^{\prime}}\right\}$
和位置交互特征
$ \left\{\boldsymbol{\psi}_{1}^{\text {DHGAT }}, \cdots, \boldsymbol{\psi}_{i}^{\text {DHGAT }}, \cdots, \boldsymbol{\psi}_{m}^{\text {DHGAT }}\right\}$
联合组成, 其中,
$ \boldsymbol{E}^{\prime}=\left\{\boldsymbol{e}_{i k}^{\prime} \mid i=1, 2, \cdots, m ; k \in \Lambda_{i}^{\prime}\right\}$
表示边特征, 由智能体之间的有向边组成, 其中, e'ik表示一条从智能体k指向智能体i的有向边, 且智能体k在智能体i的运动邻域范围内, Λ 'i表示智能体i的运动邻域.边特征e'ik由边属性
$ \boldsymbol{e}_{i k}^{\prime}=\left[e_{i k}^{\text {value }} \| e_{i k}^{\text {type }^{\prime}}\right] .$
边类型
$ \boldsymbol{E}_{i k}=\frac{\boldsymbol{r}_{k i}}{\left|\boldsymbol{r}_{k i}\right|} \cdot \frac{\exp \left(l_{2} v^{k} \cos \theta^{k}\right)}{\left|\boldsymbol{r}_{k i}\right|^{l_{1}}} .$ (3)
在智能体k产生的风险场中智能体i受到的场力为:
$ \boldsymbol{F}_{i k}=\frac{\boldsymbol{r}_{k i}}{\left|\boldsymbol{r}_{k i}\right|} \cdot \frac{\exp \left(l_{2} v^{k} \cos \theta^{k}\right) \exp \left(-l_{3} v^{i} \cos \theta^{i}\right)}{\left|\boldsymbol{r}_{k i}\right|^{l_{1}}} .$ (4)
其中:rki=(xi-xk, yi-yk), 表示智能体k到智能体i的距离向量; vk表示智能体k的速度, vi表示智能体i的速度; θ k表示智能体k的运动方向与rki的夹角, θ i表示智能体i的运动方向与rki的夹角; l1、l2、l3表示待定系数; |rki|表示智能体k和智能体i之间的欧几里得距离.Fik表示在智能体k产生的风险场中智能体i运动状态的危险程度, 方向与rki相同.根据式(4)可得到场力值|Fik|, 并将该值作为边属性
此外, 对于智能体i, 运动邻域Λ 'i同样根据智能体k与其之间的距离确定.然而, DHGAT运动交互编码器重点关注相距较近的智能体的运动交互影响, 以便进一步提高预测精度.因此, 选择较小的横向距离阈值L'x和纵向距离阈值L'y确定智能体i的运动邻域Λ 'i.定义
$ \delta_{i k}^{\prime}=\left\{\begin{array}{l} 1, \left|x^{i}-x^{k}\right| \leqslant L_{x}^{\prime} \text { and }\left|y^{i}-y^{k}\right| \leqslant L_{y}^{\prime} \\ 0, \text { 其它 } \end{array}\right.$
用于判断智能体k是否在智能体i的运动邻域Λ 'i内.若δ 'ik=1, 智能体k在智能体i的运动邻域Λ 'i内, 否则不在.
将所有历史时刻的安全增强有向边特征异构图输入DHGAT运动交互编码器中.先将每个历史时刻的安全增强有向边特征异构图输入异构图注意力网络[11, 23]中, 得到每个历史时刻聚合和更新后的节点特征.再将每个历史时刻更新后的节点特征按照时间序列输入基于GRU的时序建模模块, 最终得到异构交互特征:
$ \boldsymbol{\Gamma}=\left\{\boldsymbol{\Gamma}_{1}^{\mathrm{DHGAT}}, \cdots, \boldsymbol{\Gamma}_{i}^{\mathrm{DHGAT}}, \cdots, \boldsymbol{\Gamma}_{m}^{\mathrm{DHGAT}}\right\} .$
道路环境层基于构建的有向图, 利用道路环境编码器提取无信号交叉口场景的道路结构特征.将高精(High Definition, HD)地图中的道路拓扑结构建模为一个有向图$ \boldsymbol{G}^{\prime \prime}=\left(\boldsymbol{V}^{\prime \prime}, \boldsymbol{E}^{\prime \prime}\right)$.
以道路段为节点, 描述每个道路段自身的属性.首先, 对每个道路段的左右边界线重采样, 确保不同长度的道路都能用固定数量的点表示, 实现特征对齐.然后, 将点的坐标从全局地图坐标系转换到以其中一个智能体位置为原点的局部坐标系.最后, 从两个层次表示点特征:
一方面, 计算每个道路段的长度
另一方面, 道路段的语义类型
$ \boldsymbol{V}_{r}^{v}=\left[l_{r}^{v}, d_{r}^{v}, \boldsymbol{\gamma}_{r}^{v}, \boldsymbol{\omega}_{r}^{v}, \boldsymbol{\tau}_{r}^{v}\right], $
最终形成整个图的节点特征矩阵V″.
针对每个节点, 考虑3类拓扑关系:1)表示道路连通性的序列关系(前驱、后继); 2)表示道路并行关系的邻接关系(左邻、右邻); 3)冲突关系, 表示在交叉口等区域的潜在交叠.所有节点之间的拓扑关系构成边E″.交叉口的道路矢量拓扑图如图5所示.
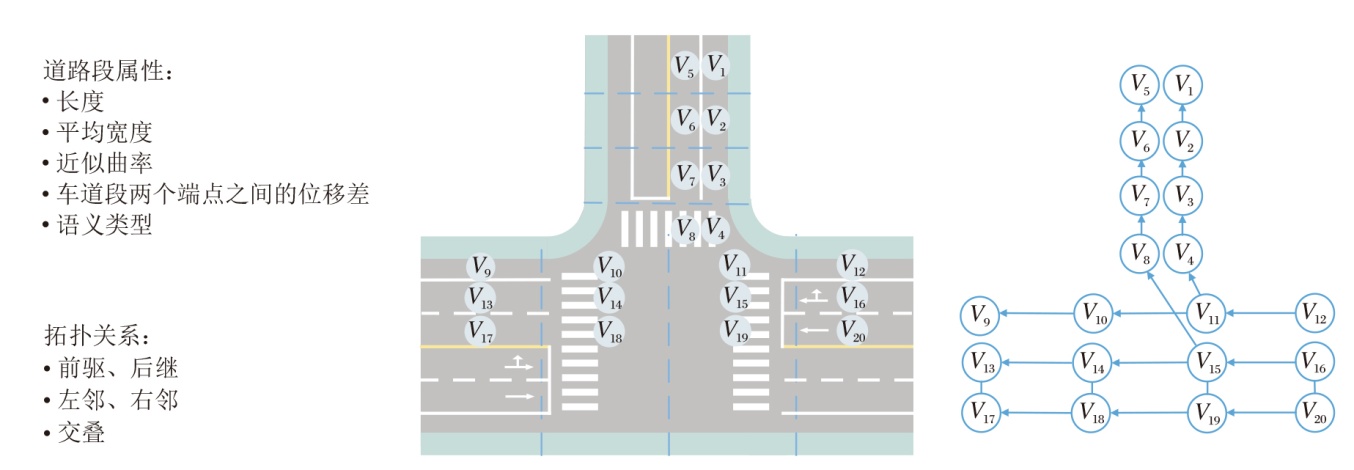 | 图5 道路矢量拓扑图Fig.5 Topology graph of road vector |
将构建的有向图G″=(V″, E″)输入基于三层图卷积网络(Graph Convolutional Network, GCN)的道路环境编码器中, 得到道路结构特征 .
为了有效整合来自不同层级的特征, 设计如下特征融合模块.
首先, 采用跨模态注意力机制, 融合个体动态特征与道路结构特征, 由于智能体的运动意图受道路拓扑结构的物理约束, 该机制以智能体的个体动态特征ζ (即运动特征)作为查询(Query)向量, 道路结构特征作为键(Key)向量和值(Value)向量, 计算注意力权重, 使每个智能体能自适应关注与其运动最相关的道路结构信息.该过程可表述为:
$ \operatorname{Attention}(\boldsymbol{Q}, \boldsymbol{K}, \boldsymbol{V})=\operatorname{softmax}\left(\frac{\boldsymbol{Q K}^{\mathrm{T}}}{\sqrt{d_{k}}}\right) \boldsymbol{V}, $
其中, Q、K、V表示注意力机制的输入, dk表示向量维度, softmax(· )表示归一化指数函数.通过注意力机制得到在道路环境约束下包含智能体运动倾向的道路感知动态特征Rdyn.
然后, 将道路感知动态特征Rdyn、交互风险特征E及异构交互特征Γ 在特征维度上进行拼接, 形成包含个体运动历史、群体交互、交互风险及道路约束的统一特征表示:
$ \boldsymbol{H}_{\text {fused }}=\operatorname{Concat}\left(\boldsymbol{R}_{\text {dyn }}, \boldsymbol{E}, \boldsymbol{\Gamma}\right), $
其中Concat(· )表示拼接操作.
最后, Hfused被输入与智能体类型对应的基于LSTM(Long Short-Term Memory)的轨迹解码器(包括车辆、行人及骑行人解码器)中, 生成目标智能体的未来轨迹
$ \left\{\left(\hat{x}_{t}^{j}, \hat{y}_{t}^{j}\right) \mid j=1, 2, \cdots, n\right\}_{t=p+1}^{p+T_{f}} .$
为了评估SEIM在实际无信号交叉口的性能, 在inD数据集[22]上进行训练和测试.该数据集包含德国4个无信号交叉口的数据, 包含异构智能体(车辆、行人和骑行人)的轨迹、状态信息及HD地图.
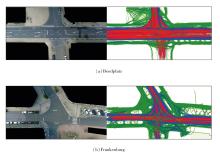
选择行人和骑行人占比较高的Bendplatz、Frankenburg交叉口作为测试场景, 具体示例如图6所示, 图中红线表示车辆轨迹, 绿线表示行人轨迹, 蓝线表示骑行人轨迹.在这两个交叉口, 车辆、行人和骑行人的复杂交互情况有利于验证SEIM的有效性.
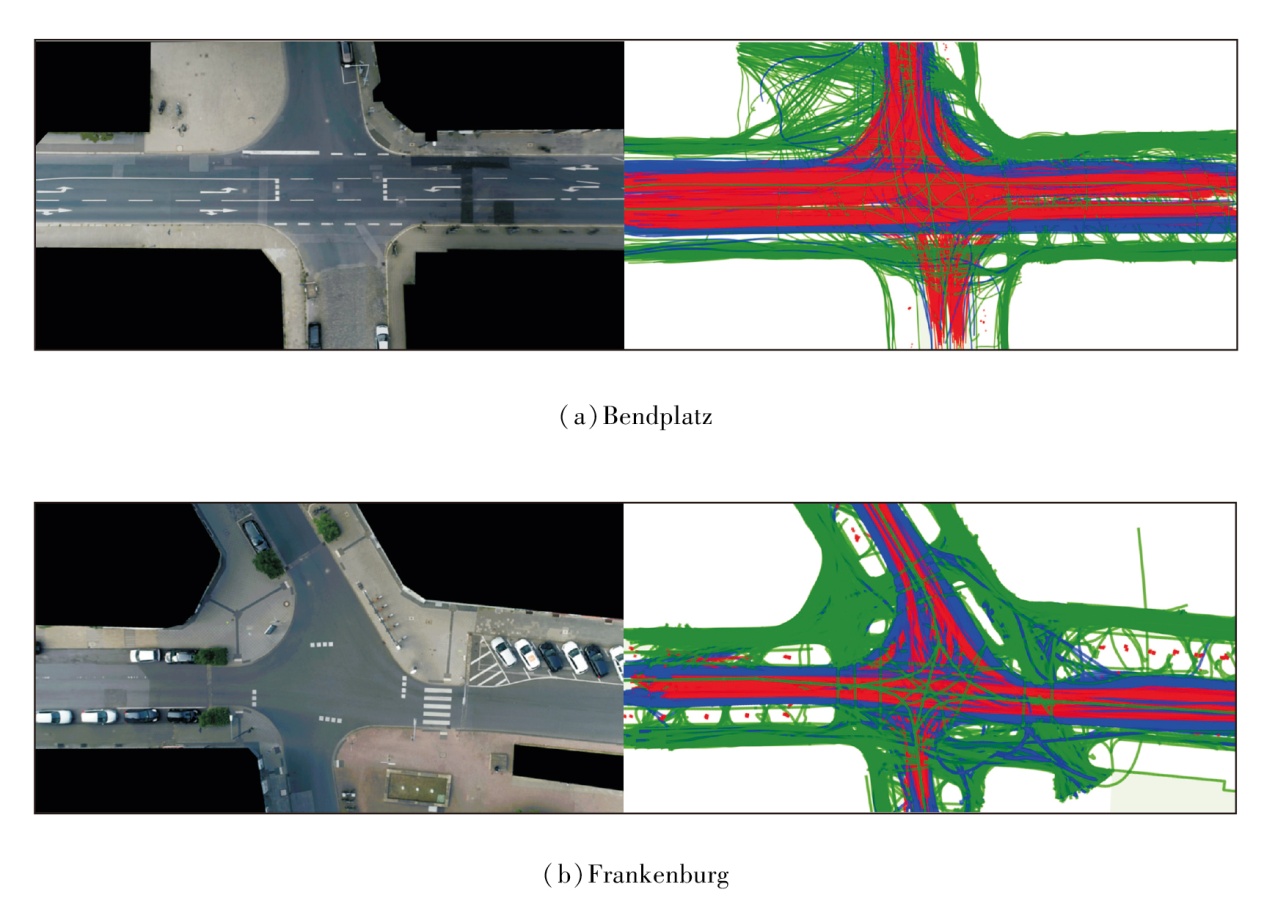 | 图6 两个交叉口记录轨迹示例Fig.6 Examples of trajectories recorded at two intersections |
inD数据集在Bendplatz交叉口记录3 738个智能体的轨迹(2 503辆车、801位行人和434位骑行人), 在Frankenburg交叉口记录6 235个智能体的轨迹(2 436辆车、2 099位行人和1 700位骑行人), 这些数据包含在23个录像中.
在数据预处理期间, 时间步长调整为0.08 s.对于每个录像, 以55帧(含历史20帧和未来35帧)作为时间窗长度, 提取同一时间窗内存在的智能体轨迹, 构建交互场景样本.设定滑动步长等于时间窗长度(即55帧), 共得到5 290个交互场景样本.该设置确保相邻场景窗口在时间帧上不存在直接重叠, 降低由窗口帧级重复导致的数据相关性.值得说明的是, 上述样本量对应时间窗口实例, 而非独立的完整轨迹实例, 因此同一智能体的较长时间轨迹可能跨越多个时间窗样本.按照8∶ 1∶ 1的比例将总样本随机划分为训练集(4 232个样本)、验证集(529个样本)和测试集(529个样本).
利用平均位移误差(Average Displacement Error, ADE)和最终位移误差(Final Displacement Error, FDE)评价方法的预测准确性.此外, 为了定量分析目标智能体的安全风险, 定义两个风险度量指标:平均场强(Mean Field Strength, MFS)和平均场力(Mean Field Force, MFF).MFS表示从时间步p+1到p+Tf, 目标智能体j周围所有交通参与者产生的驾驶风险场强的平均值.MFF表示从时间步p+1到p+Tf, 目标智能体j在周围所有交通参与者产生的驾驶风险场中受到的场力的平均值.两者公式如下:
$ \begin{array}{l} M F S=\frac{1}{n \cdot T_{f}} \sum_{j=1}^{n} \sum_{t=p+1}^{p+T_{f}}\left|\sum_{k \in \Lambda_{j}} \boldsymbol{E}_{j k}\right|, \\ M F F=\frac{1}{n \cdot T_{f}} \sum_{j=1}^{n} \sum_{t=p+1}^{p+T_{f}}\left|\sum_{k \in \Lambda_{j}} \boldsymbol{F}_{j k}\right| . \end{array}$
其中:Ejk表示周围交通参与者k产生的风险场在j点处的场强, 由式(3)求得; Fjk表示在周围交通参与者k产生的风险场中目标智能体j受到的场力, 由式(4)求得; Λ j表示目标智能体j的邻域, 利用式(2)筛选位于该邻域内的智能体k.
本文旨在根据场景中智能体在过去1.6 s内的历史状态及环境信息, 预测目标智能体在未来2.8 s内的轨迹, 由此设置Th=20, Tf=35, Lx=50 m, Ly=40 m, L'x=40 m, L'y=30 m.汽车、行人和骑行人的实际质量mi分别为1 500 kg、70 kg和90 kg.幂函数的指数l1=0.5, l2=0.06, l3=0.06, 以此确保场强和场力值的合理性及训练收敛速度.SEIM各模块的网络结构参数详见表1.
 | 表1 SEIM各模块网络结构参数 Table 1 Network structure parameters of each module in SEIM |
训练采用Adam(Adaptive Moment Estimation)优化器, 迭代周期为36, 批量大小为32, 学习率为0.001, 损失函数采用平滑L1损失进行轨迹回归:
$ L_{r}=\sum_{t=p+1}^{p+T_{f}} \sum_{j=1}^{n} \operatorname{smooth}_{L 1}\left(\widehat{F}_{t}^{j}-F_{t}^{j}\right) .$
其中:
$ \operatorname{smooth}_{L 1}(x)=\left\{\begin{array}{ll} 0.5 x^{2}, & |x|< 1 \\ |x|-0.5, & |x| \geqslant 1 \end{array}\right.$
$ x=\widehat{F}_{t}^{j}-F_{t}^{j}$, 表示预测轨迹与真实轨迹之间的偏差;
本文选择如下基线方法测试SEIM性能:ReCoG(Recurrent Convolutional and Graph Neural Net-works)[10]、HEAT-I-R[11]、HDR-MAT[12]、HRG-HSG(Heterogeneous Risk Graph-Hierarchical Scene Gra-ph)[14]、HRGC[15]、MultiPath[24]、DenseTNT[25]、HDGT(Heterogeneous Driving Graph Transformer)[26].
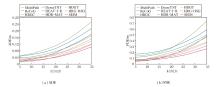
各方法的ADE和FDE指标对比如表2和图7所示, 其中, SEIM对应单条预测轨迹的误差, 而部分基线方法的min6结果表示取6条预测轨迹中的最小值.
| 表2 各方法的预测误差指标(每步0.08 s) Table 2 Prediction error of different methods(0.08 s per time step) |
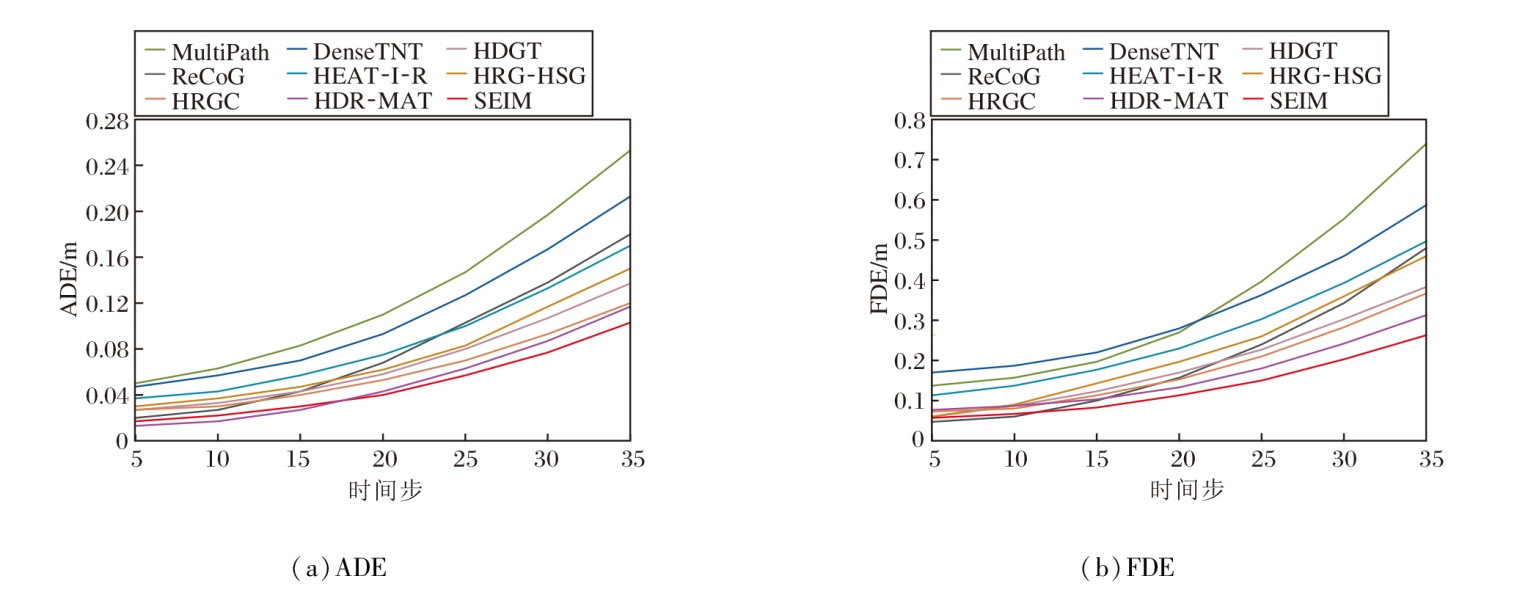 | 图7 各方法的预测性能Fig.7 Prediction performance of different methods |
由表2和图7可看出, SEIM在所有预测时域上均取得较低或最低的预测误差, 整体表现优于绝大多数对比方法.具体而言, 虽然在短时预测(0.4 s和1.2 s)中, SEIM的ADE值略高于取得最小ADE值的HDR-MAT, 但在长时预测(2.0 s和2.8 s)中, SEIM的ADE值均最小.此外, 在短时预测(0.4 s)中, 虽然SEIM的FDE值略高于取得最小值的Re-CoG, 但ReCoG只能预测单一智能体的轨迹.随着预测时长的增加, SEIM的FDE值增长最平缓, 且在2.8 s时达到最低值.值得注意的是, 在2.8 s时, 相比HEAT-I-R、HDG-T、HRG-HSG、HRGC、HDR-MAT等多智能体预测方法, SEIM的ADE和FDE指标分别降低12.0%~39.8%和16.0%~47.1%, 验证其在长时预测中的优越性.SEIM在短时预测中略逊于部分对比方法, 可能是因为极短时域内智能体的交互尚未产生显著影响, 引入安全势场增加的风险特征与异构交互特征对短时运动预测的贡献有限.在长时预测中, 交互演化成为主导因素, SEIM通过风险感知与异构交互建模能更准确地推演交互关系对轨迹的影响, 具有一定的优越性.对比实验充分表明SEIM在异构智能体轨迹预测中的有效性与准确性.
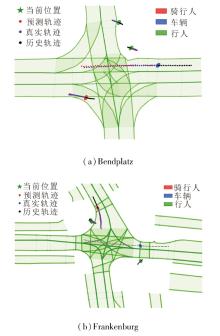
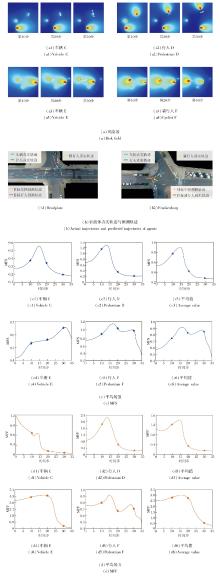
SEIM在Bendplatz、Frankenburg交叉口的预测结果可视化如图8所示.由图可看出, 两种场景中多个异构智能体的预测轨迹与实际轨迹均高度对齐, 进一步表明SEIM能准确预测不同场景中多个异构智能体的轨迹.
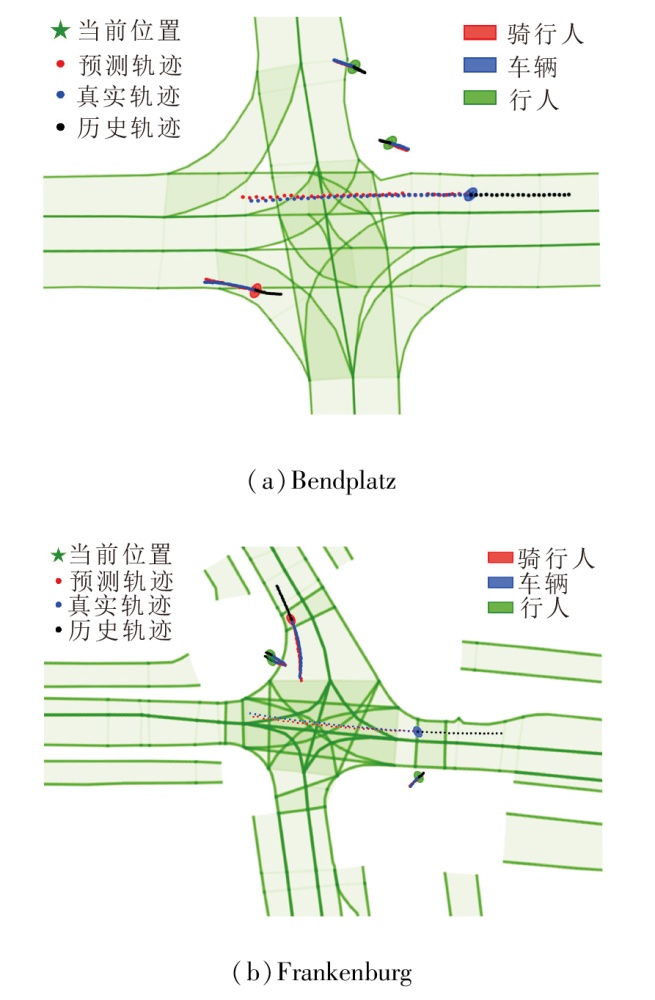 | 图8 SEIM在2个交叉口的预测结果可视化Fig.8 Visualization of SEIM prediction results at two intersections |
模型具备较高预测精度时, 安全风险评估才有实际意义.下面分别评估HRGC、HDR-MAT、SEIM预测轨迹的安全风险.l1为影响场强和场力的重要系数, 因此在训练过程中, 设定l1=0.5, 1, 1.5, 2, 作为安全势场公式中的系数输入, 并在测试集上利用预测误差指标与风险度量指标评估设定值对应的方法性能.实验利用相同的风险度量指标MFS和MFF量化预测轨迹的风险水平, 确保结果的可比性.
各方法的安全风险评估如表3所示, 表中黑体数字表示最优值.由表可见, l1=0.5时, 各项指标均为最低值, 轨迹兼具高精度与低风险的特征, 因此本文统一将l1设定为0.5进行实验.
| 表3 各方法预测轨迹的误差和安全风险 Table 3 Prediction errors and safety risks of trajectories predicted by different methods |
此外, 相比HRGC, 虽然HDR-MAT预测轨迹的误差较低, 风险却较高, 这说明对于预测轨迹, 低误差并不等于低风险.相比HRGC和HDR-MAT, SEIM的MFS指标分别降低7.85%和13.46%, MFF指标分别降低35.34%和42.36%, 这表明在定义的风险度量指标下, SEIM预测轨迹风险水平较低.
为了探究目标智能体预测轨迹上的风险演变, 选取两个交叉口中的高交互场景进行轨迹的风险可视化.选取Bendplatz交叉口中车辆C和行人D、Frankenburg交叉口中车辆E和骑行人F作为目标智能体, 结果如图9所示, 图中的红点和五角星分别表示目标智能体在第10、20和30个时间步的轨迹点和风险.由图可见, 在Bendplatz交叉口上, 车辆C右转时, 行人D试图横穿马路, 极有可能在冲突点发生碰撞.SEIM预测车辆C先通过冲突点, 行人D后通过冲突点, 从而避免碰撞.车辆C的风险始终较小, 而行人D的风险先升后降.在Frankenburg交叉口上, 在车辆E右转时, 骑行人F向同一方向左转, 两者的碰撞风险较高.SEIM预测车辆E先减速让行, 骑行人F同时加速通过冲突点, 车辆E再加速驶离骑行人F, 从而避免碰撞.车辆E的风险先增后减, 骑行人F的风险随着车辆E的靠近先增加后减小再增加, 并随着车辆E的驶离最终减小到较低值.实验结果进一步表明SEIM在定义的风险度量指标下预测轨迹的安全性.
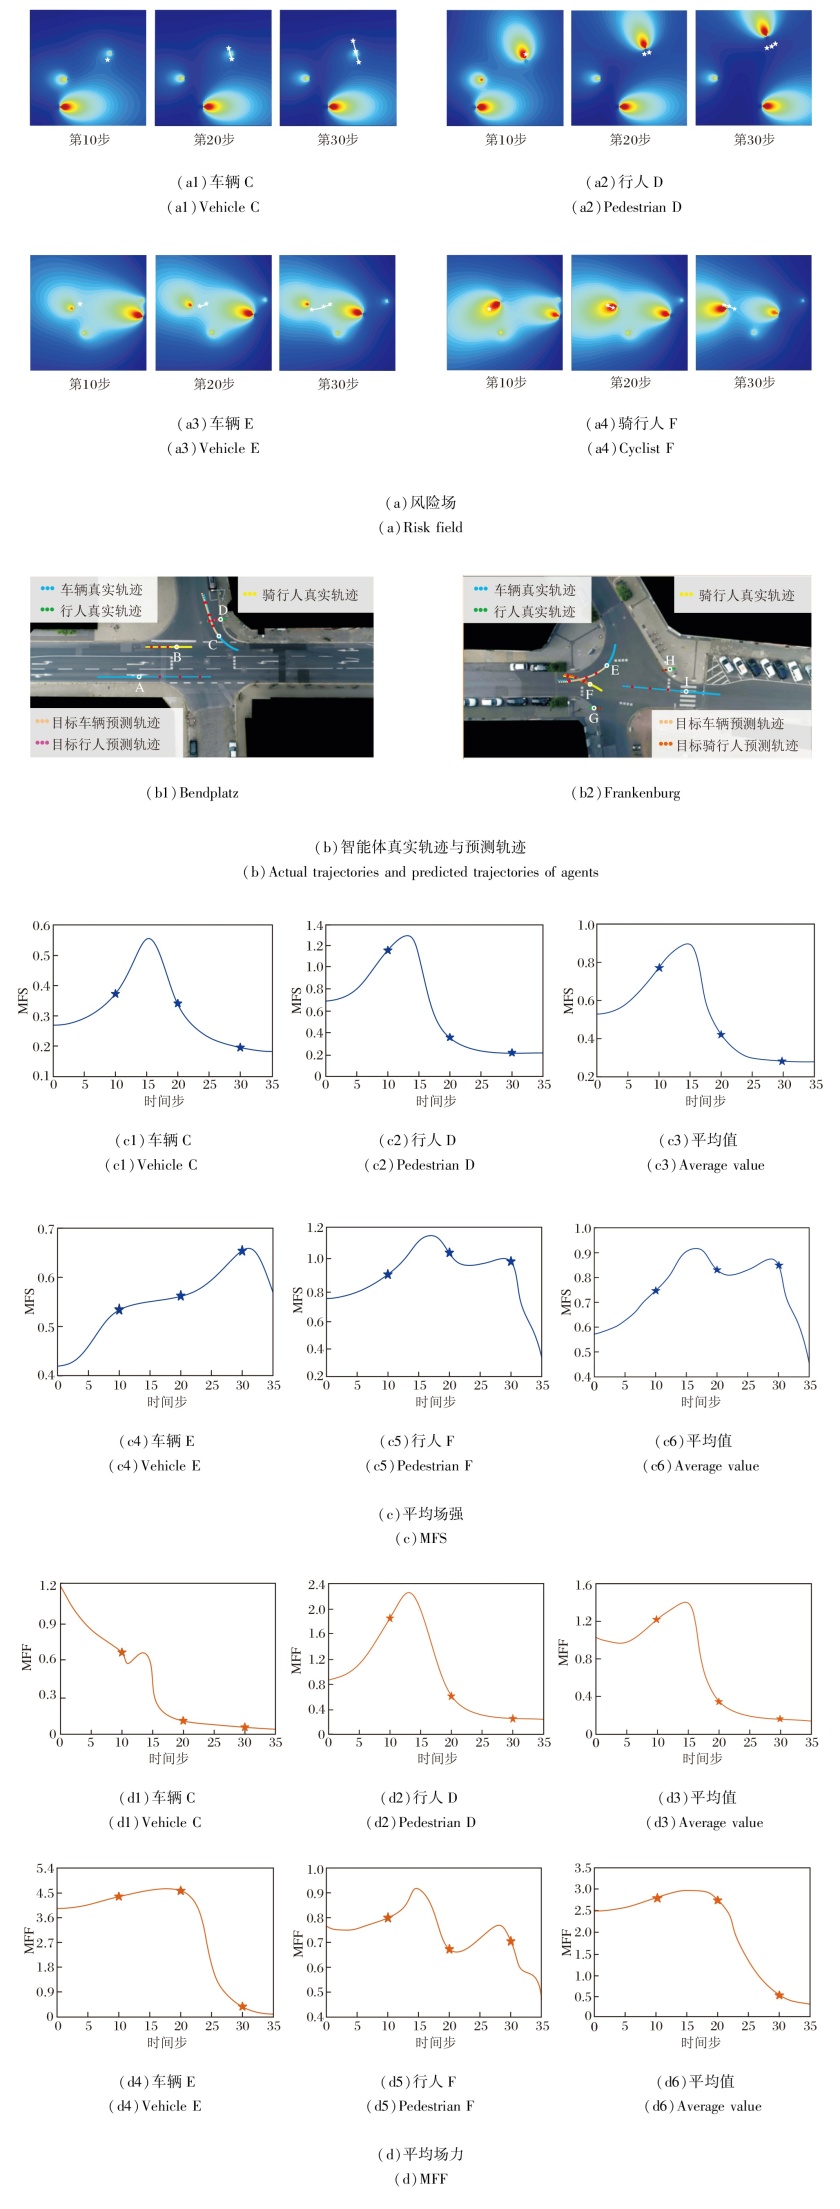 | 图9 SEIM在2个交叉口的安全风险可视化Fig.9 Safety risk visualization of SEIM at two intersections |
本节评估SEIM中各模块对预测准确性和安全性的贡献.在inD数据集上训练和验证, 预测未来2.8 s的轨迹.设置如下9种变体模块.
1)G:GRU运动编码器(提取个体动态特征).
2)DHGAT1:DHGAT位置交互编码器.
3)DHGAT2:DHGAT运动交互编码器(SDDHGAT).
4)SDDHGAT:异构交互编码器.
5)SDDHGAT':在SDDHGAT的基础上, 将SDD-HGAT的边属性由基于势场的风险值替换为智能体的相对状态(相对位置、速度、加速度和航向角).
6)SDDHGAT-G:异构交互编码器和GRU运动编码器.
7)SDDHGAT-G-E:异构交互编码器、GRU运动编码器和风险感知编码器.
8)SDDHGAT-G-R:异构交互编码器、GRU运动编码器和道路环境编码器.
9)SDDHGAT'-G-E-R:在SEIM基础上, 将SDD-HGAT的边属性由基于势场的风险值替换为智能体的相对状态(相对位置、速度、加速度和航向角).
相应消融实验结果如表4所示.
| 表4 各模块消融实验结果 Table 4 Ablation experiment results of different modules |
由表4可见, SEIM的ADE和FDE指标均优于G、SDDHGAT、SDDHGAT-G、SDDHGAT-G-E和SDD-HGAT-G-R, 表明构建的4个层次均有益于预测精度提高.SDDHGAT在各指标值上均小于SDDH-GAT', 且SEIM在各指标值上也均小于SDDHGAT'-G-E-R, 说明利用基于势场的风险值增强异构图的边特征, 可有效增强方法的准确性和安全性.SDD-HGAT-G-E在各指标值上均小于SDDHGAT-G, 且SEIM在各指标值上也均小于SDDHGAT-G-R, 表明风险感知层通过提取智能体交互风险特征, 可进一步提高预测精确性和安全性.值得注意的是, 相比SEIM, SDDHGAT'-G-E-R的MFS和MFF指标分别提高3.52%和4.31%, 而SDDHGAT-G-R相应指标分别提高7.59%和9.53%, 说明相比增强异构图的边特征, 风险感知层的构建对SEIM预测安全性的贡献更大.此外, SDDHGAT的ADE和FDE指标均低于DHGAT1和DHGAT2, 验证异构交互层通过对智能体的位置交互信息和运动交互信息的充分捕捉, 进一步提高方法预测精度.
消融实验表明SEIM各关键模块的有效性, 尤其是风险感知层的构建和异构图边特征的增强对降低预测轨迹在定义的风险度量指标下的风险水平至关重要.
本文针对城市无信号交叉口中异构多智能体轨迹预测面临的动态交互风险与异构交互复杂性, 提出基于安全增强交互建模的异构智能体轨迹预测方法(SEIM).SEIM由风险感知层、异构交互层、个体动态层与道路环境层构成.风险感知层基于安全势场表征交互风险, 并提取交互风险特征.异构交互层构建2个异构图, 设计异构交互编码器, 提取异构交互特征, 并引入基于安全势场的风险值作为安全增强有向边特征异构图的边属性, 增强图结构的边特征.道路环境层基于构建的有向图提取道路结构特征.个体动态层提取个体动态特征.4类特征融合后输入轨迹解码器, 同步预测异构多智能体的未来轨迹.在inD数据集上的实验表明, SEIM在2.8 s长时预测任务中, ADE与FDE指标分别低至0.103 m与0.263 m, 显著优于对比方法.风险评估实验利用MFS和MFF指标, 定量验证SEIM预测轨迹的低风险特性.消融实验进一步表明风险感知层与安全增强边特征对提升预测精度及在定义的风险度量指标下降低预测轨迹风险水平的核心贡献.
未来工作将针对SEIM在短时预测中略逊于部分对比方法的问题, 引入自适应特征权重分配机制, 根据预测时域动态调整对各模块特征的依赖程度, 兼顾短时精度与长时安全性.同时, 探索SEIM与端到端自动驾驶框架的深度融合, 将提取的风险与交互特征作为先验信息注入端到端网络, 增强对复杂交互场景的感知能力.同时将基于安全势场的风险度量指标作为正则化项引入端到端模型的损失函数, 使物理安全约束显式嵌入训练过程, 提升自动驾驶系统的可解释性与可靠性.此外, 还将探索基于深度学习的风险场建模方法, 构建可学习势场或风险感知模块, 生成更具场景适应性的风险表征, 进一步增强方法在复杂交互场景中的感知能力.
本文责任编委 吴飞
Recommended by Associate Editor WU Fei
| [1] |
|
| [2] |
|
| [3] |
|
| [4] |
|
| [5] |
|
| [6] |
|
| [7] |
|
| [8] |
|
| [9] |
|
| [10] |
|
| [11] |
|
| [12] |
|
| [13] |
|
| [14] |
|
| [15] |
|
| [16] |
|
| [17] |
|
| [18] |
|
| [19] |
|
| [20] |
|
| [21] |
|
| [22] |
|
| [23] |
|
| [24] |
|
| [25] |
|
| [26] |
|