

基于分层触觉引导空间注意力和动态时序融合的视觉-触觉多模态学习方法
[范成龙1  , 胡立华
1 , 胡建华2 ]
, 胡立华, 胡建华]
|
|


作者简介:
范成龙, 硕士研究生,主要研究方向为机器人智能感知、视觉-触觉融合、多模态深度学习.E-mail: 927895523@qq.com.
胡建华, 博士,研究员,主要研究方向为智能机器人、三维视觉.E-mail:hujianhua.jianhua@163.com.
视觉与触觉在感知范围和信息形式上存在差异,现有方法难以有效关联触觉接触信息与视觉局部区域,并且固定融合策略难以适应不同交互阶段两种模态贡献的动态变化.针对上述问题,文中提出基于分层触觉引导空间注意力和动态时序融合的视觉-触觉多模态学习方法.首先,以触觉特征为查询条件,引导视觉分支关注接触关联区域,并融合中、高层视觉特征,兼顾局部纹理细节与高层语义信息.然后,采用双流Mamba对视觉序列与触觉序列进行时序建模,并通过动态门控机制自适应调节两种模态的融合比例.最后,利用时序注意力池化模块对融合序列进行加权汇聚,突出关键交互时刻并抑制冗余时间步的干扰.在Touch and Go材料识别数据集上的实验表明,文中方法的材料类别识别准确率较高,消融实验和可视化分析进一步验证方法各组成模块的有效性.
About Author:
FAN Chenglong, Master student. His research interests include robotic intelligent per-ception, visual-tactile fusion, and multimodal deep learning.
HU Jianhua, Ph.D., professor. His research interests include intelligent robotics and 3D vision.
Visual and tactile modalities differ in perceptual scope and information form. Existing methods fail to effectively associate tactile contact information with local visual regions. Moreover, fixed fusion strategies cannot adapt to the dynamic variations in the contributions of the two modalities across different interaction stages. To address these issues, a visual-tactile multimodal learning method via hierarchical tactile-guided spatial attention and dynamic temporal fusion(HTA-DTF) is proposed. First, tactile features are utilized as queries to guide the visual branch to focus on contact-related regions, while intermediate- and high-level visual features are integrated to capture both local texture details and high-level semantic information. Second, a dual-stream Mamba architecture is employed to model the temporal dependencies of visual and tactile sequences, and a dynamic gating mechanism is adopted to adaptively adjust the fusion proportions of the two modalities across different interaction stages. Finally, temporal attention pooling performs weighted aggregation over the fused sequence, emphasizing key interaction moments while suppressing interference from redundant time steps. Experiments on the Touch and Go material recognition dataset demonstrate that HTA-DTF achieves high material recognition accuracy. Ablation studies and visualization analyses further verify the effectiveness of the proposed components.
人类在感知环境时通常依赖多种感官的协同作用, 视觉和触觉是其中最关键的感知方式.视觉能反映物体的整体外观、形状和空间结构, 是获取环境信息的主要来源; 触觉侧重于感知表面纹理、硬度、材料属性及接触状态等局部物理信息.两者在信息来源和感知范围上具有明显的互补性, 使人类能更准确地识别物体并完成复杂的操作任务[1].同样地, 对于机器人而言, 仅依赖视觉难以获得物体的局部物理属性或接触状态[2].例如在物体识别任务中, 视觉能有效区分物体的形状和外观, 但对材质、表面粗糙度等属性的判断能力有限; 在机器人的抓取和操作过程中, 视觉可确定目标位置并规划抓取姿态, 而抓取是否稳定、是否发生滑移及接触力是否合理, 则需要通过触觉信息进行辅助判断[3].因此, 如何有效结合视觉与触觉, 已成为提升机器人操作与感知能力的重要研究方向.
目前, 基于视觉-触觉的多模态融合主要采用神经网络方法, 包括直接融合视觉与触觉特征[4]、利用注意力机制增强跨模态交互[5]、采用对比学习增强跨模态特征表示能力[6].然而由于视觉与触觉在感知范围和信息形式上存在天然差异, 上述方法仍存在如下问题.首先, 视觉提供物体的整体外观信息, 而触觉仅感知局部接触区域, 上述两种模态之间难以建立准确的空间对应关系.同时, 现有方法未能充分利用不同层级特征之间的互补信息, 进一步限制与触觉相关视觉区域的有效表达.其次, 在涉及连续交互过程的任务中, 视觉数据与触觉数据往往具有一定的时序特性, 现有研究对于视觉与触觉在不同交互阶段的动态交互关系缺乏充分建模.最后, 现有方法大多采用固定融合策略, 难以根据交互过程中两种模态贡献的动态变化自适应调整融合权重.
针对上述问题, 本文提出基于分层触觉引导空间注意力与动态时序融合的视觉-触觉多模态学习方法(Visual-Tactile Multimodal Learning via Hierar-chical Tactile-Guided Spatial Attention and Dynamic Temporal Fusion, HTA-DTF).从视觉-触觉相关空间关联和交互过程动态融合两个角度出发, 利用触觉信息引导视觉分支关注与接触相关的局部区域, 并结合不同层级的视觉特征增强局部区域表达, 用于增强视觉全局信息与触觉局部接触信息之间的空间关联.在此基础上, 设计动态跨模态时序融合模块(Dynamic Cross-Modal Temporal Fusion, DCMTF), 引入状态空间模型(State Space Model, SSM), 分别建模视觉序列特征与触觉序列特征, 并根据序列变化动态调整两种模态的融合比重.同时结合时序注意力池化模块(Temporal Attention Pooling, TAP)对融合序列进行加权汇聚, 突出关键交互时刻的判别性信息.
视觉-触觉融合旨在整合两种模态的互补信息, 形成有利于下游任务的联合特征表示.空间关联则关注触觉局部接触信息与视觉图像中相应区域之间的对应关系.由于视觉数据与触觉数据在感知范围和信息形式上存在差异, 采用准确的空间关联能减少无关视觉区域的干扰, 是实现有效视觉-触觉融合的重要基础.现有方法从如下方式为视觉-触觉模态之间建立空间关联.
1)直接特征融合与注意力交互.早期视觉-触觉研究主要采用直接融合策略.Calandra等[3]在输入层拼接视觉图像与触觉图像, 实现视觉-触觉信息的早期融合.Lee等[4]在高层特征空间融合两种模态的信息.这类方法结构相对简单, 但通常将视觉与触觉作为整体特征进行融合, 对触觉接触信息与视觉局部区域之间的对应关系考虑不足.随着注意力机制的发展, 研究者开始利用注意力建模, 增强视觉与触觉之间的信息交互.Cui等[5]提出VTFSA(Visual-Tactile Fusion Learning Method Based on Self-Attention Mechanism), 通过自注意力机制学习视觉特征与触觉特征之间的关系, 增强两种模态的信息交互能力.然而, 该类方法主要关注模态特征之间的整体交互, 对如何根据触觉接触状态选择相应视觉区域仍缺乏充分研究.
2)跨模态表示一致性.近年来, 对比学习广泛应用于视觉-触觉表示学习.Yang等[6]通过跨模态对比学习, 增强视觉特征与触觉特征表示的一致性.Kerr等[7]提出SSVTP(Self-Supervised Visuo-Tactile Pretraining), 以自监督方式预训练视觉-触觉编码器.Dave等[8]提出MViTac(Multi-modal Visual-Tac- tile), 利用多模态对比学习提升视觉-触觉特征的判别能力.Wu等[9]提出ConViTac, 结合对比表示学习与监督学习, 在Touch and Go数据集[6]上取得较优性能.这类方法通过缩小视觉表征与触觉表征之间的差异, 为后续特征融合提供更一致的特征空间, 但其主要关注模态之间的全局表示对齐, 通常不能直接建立触觉接触信息与视觉局部区域之间的空间对应关系.
3)视觉区域选择与多层级特征表示.为了增强触觉局部接触信息与视觉区域之间的空间关联, 视觉区域选择和多层级特征表示提供两种可行思路.Lin等[10]提出FPN(Feature Pyramid Network), 表明不同层级视觉特征具有不同的信息表达能力:较浅层特征和中间层特征保留较多的空间细节, 深层特征包含更抽象的语义信息.从频域角度上看, Xu等[11]认为, 卷积神经网络浅层特征更容易响应高频纹理信息, 深层特征更关注低频结构信息.因此, 融合不同层级的视觉特征有助于同时利用局部纹理细节和高层语义信息, 为接触相关视觉区域的特征表示提供更丰富的信息.
4)除了视觉-触觉任务以外, 在视觉-语言任务中, Anderson等[12]通过条件注意力机制, 根据语言上下文为不同视觉区域分配权重, 选择与当前任务相关的区域信息.尽管上述研究并非直接面向视觉-触觉融合, 但多层级视觉表达及利用一种模态引导另一种模态进行区域选择的思想, 为建立触觉接触信息与视觉局部区域之间的关联提供方法依据.
总之, 上述方法虽然建立视觉与触觉之间的关联信息, 但对触觉接触信息与视觉局部区域之间的空间关联考虑仍不充分.具体而言, 部分方法在输入层或高层特征空间对两种模态进行整体融合, 较少根据触觉接触状态选择相应的视觉区域.同时, 现有方法对中层视觉特征中的局部纹理细节和高层视觉特征中的语义信息利用不足.因此, 如何以触觉接触状态为条件引导视觉区域选择, 并发挥不同层级视觉特征的互补作用, 仍是视觉-触觉融合需要进一步解决的问题.
在机器人抓取、操作和接触感知等任务中, 视觉信息与触觉信息会随交互过程发生变化, 因此时序信息对于理解视觉与触觉之间的动态交互关系具有重要作用.现有研究主要围绕时序依赖建模、动态模态融合和序列特征聚合3个方面展开.
1)时序依赖建模.早期研究通常采用循环神经网络(Recurrent Neural Network, RNN)或长短期记忆网络(Long Short-Term Memory, LSTM)[13]处理序列信息.此类方法采用递归计算方式, 并行计算效率较低, 在处理较长序列时也可能出现长期依赖信息衰减.随后, 时序卷积网络(Temporal Convolutional Network, TCN)[14]通过膨胀卷积和残差连接扩大时间感受野, 提高序列处理的并行性; Transformer[15]利用自注意力机制直接建立不同时间步之间的依赖关系.
在视觉-触觉感知领域, Doherty等[16]对视觉图像与触觉时序信号进行联合建模, 并结合Trans-former学习两种模态之间的关联关系, 实现视觉-触觉目标识别.Jiang等[17]通过三维视觉点云序列与高密度可拉伸触觉阵列的联合建模, 实现可变形物体操作过程中手-物体状态的动态重建.这些研究表明, 连续交互序列能提供单个时刻难以充分表达的动态信息.
近年来, Gu等[18]提出S4(Structured State Space Sequence Model), 为长序列建模提供新的技术路线.Gu等[19]提出Mamba, 通过选择性状态空间机制实现线性复杂度的序列处理, 同时能有效捕捉长距离依赖关系.在视觉领域, Liu等[20]提出VMamba(Visual State Space Model).Hatamizadeh等[21]提出MambaVision.相比传统循环结构和标准Transfor-mer, Mamba在保持较低计算复杂度的同时具有较好的长程依赖建模能力, 为视觉-触觉交互序列处理提供新的选择.
2)动态模态融合.除了时序依赖关系以外, 不同交互阶段视觉与触觉对任务的贡献也可能发生变化.已有研究表明, 门控机制能根据输入特征生成相应的融合权重, 从而自适应调节不同信息对融合表示的贡献[22].相比采用固定加法、平均或拼接的融合策略, 动态门控能根据当前输入状态调整融合比例, 为建模不同交互阶段视觉与触觉贡献的变化提供方法基础.
3)序列特征聚合.在完成时序建模与跨模态融合后, 还需要将不同时刻的特征聚合为序列级表示.Cao等[23]提出STAM(Spatio-Temporal Attention Mo-del), 通过空间注意力和时间注意力提取触觉序列中的纹理特征, 表明注意力机制能突出序列中的重要时空信息.在特征汇聚方面, Ilse等[24]提出Atten-tion-Based Deep Multiple Instance Learning, 学习不同实例的注意力权重, 突出更具判别性的信息.尽管该方法并非专门用于视觉-触觉时序融合, 但其自适应加权思想为选择关键交互时刻提供一定参考.
总之, 现有视觉-触觉时序研究主要关注交互序列中时序依赖关系的提取, 而对不同交互阶段视觉与触觉贡献的动态变化考虑相对有限, 难以根据交互状态自适应调整两种模态的融合比例.此外, 平均池化或统一聚合策略可能削弱关键交互时刻包含的判别信息.因此, 如何在建模视觉时序与触觉时序依赖关系的基础上, 动态调节不同交互阶段的模态贡献, 并突出对最终预测更关键的交互时刻, 仍有待进一步研究.
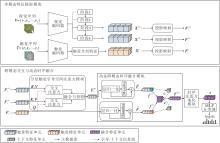
本文提出基于分层触觉引导空间注意力和动态时序融合的视觉-触觉多模态学习方法(HTA-DTF), 整体架构如图1所示.HTA-DTF以同步采集的视觉-触觉序列为输入, 从接触相关空间关联和交互过程动态融合两个方面开展视觉-触觉特征学习, 依次包括多模态特征提取模块、分层触觉引导空间注意力模块(Hierarchical Tactile-Guided Spatial Attention, HTGSA)、动态跨模态时序融合模块(DCMTF)和时序注意力池化模块(TAP).
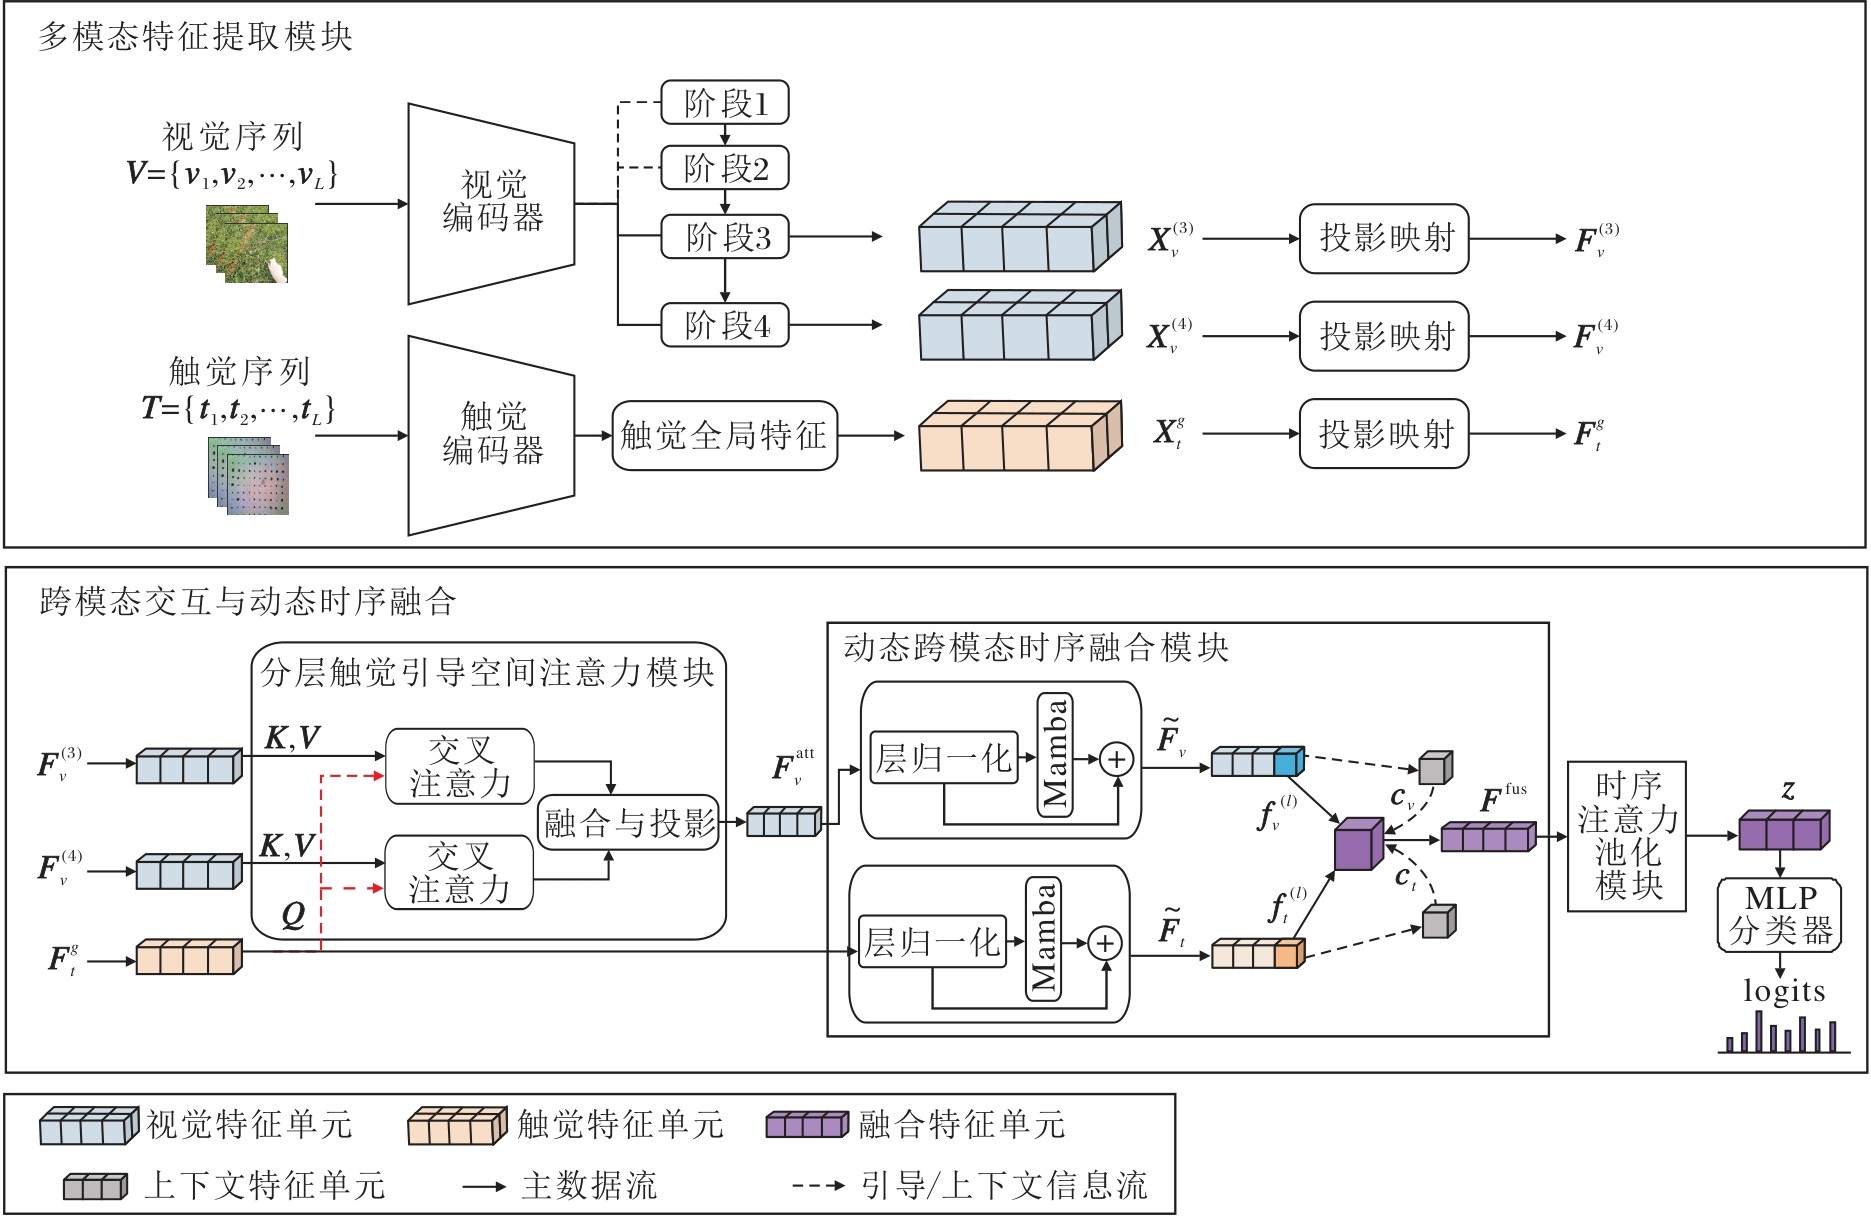 | 图1 HTA-DTF总体架构Fig.1 Overall architecture of HTA-DTF |
首先, 视觉编码器和触觉编码器分别提取多层级视觉空间特征和触觉全局特征.HTGSA再以触觉特征为查询, 引导视觉分支关注与当前接触状态相关的局部区域, 并融合不同层级的视觉特征, 得到空间增强的视觉特征序列.然后, DCMTF分别对视觉序列和触觉序列进行时序建模, 并通过动态门控机制自适应调节不同交互阶段两种模态的融合比例, 生成跨模态融合特征序列.最后, TAP对融合特征序列进行加权汇聚, 突出具有较强判别信息的关键交互时刻, 并将得到的序列级全局特征输入多层感知机(Multilayer Perceptron, MLP)分类头, 输出相应任务的类别预测结果.
给定由相机和视触觉传感器同步采集的视觉-触觉交互序列, 视觉序列V={v1, v2, …, vL}, 触觉序列T={t1, t2, …, tL}, 其中, L表示序列长度, vl表示第l帧视觉图像, tl表示与其同步采集的第l帧触觉图像.由于视觉数据与触觉数据是在同一交互过程中同步采集的, 因此二者在时间维度上一一对应.在输入网络之前, 视觉帧和触觉帧均被调整为统一尺寸, vl∈ RH× W× 3, tl∈ RH× W× 3, 其中, H、W分别表示图像高度和宽度, 3表示图像的通道数.视觉编码器和触觉编码器均采用MambaVision结构[21]进行特征提取.
在视觉分支中, 本文选取视觉编码器第3阶段的输出和第4阶段的输出作为多层级视觉特征.对于第l帧视觉图像, 第3阶段输出特征表示为
$\begin{array}{l} \boldsymbol{F}_{v, l}^{(3)}=P_{3}\left(\operatorname{Flatten}\left(\boldsymbol{X}_{v, l}^{(3)}\right)\right) \in \mathbf{R}^{N_{3} \times D}, \\ \boldsymbol{F}_{v, l}^{(4)}=P_{4}\left(\operatorname{Flatten}\left(\boldsymbol{X}_{v, l}^{(4)}\right)\right) \in \mathbf{R}^{N_{4} \times D}, \end{array}$
其中, N3、N4分别表示第3阶段特征图和第4阶段特征图展开后的空间token数, Flatten(· )表示空间展平操作, P3(· )、P4(· )分别表示对应层级上的线性投影操作.由于两个层级的特征图分辨率不同, 二者对应的空间token数通常不同, 但经过投影后特征维度均为D.对序列中的所有视觉帧执行相同处理后, 可得到两个层级的视觉特征序列:
$\begin{array}{l} \boldsymbol{F}_{v}^{(3)}=\left\{\boldsymbol{F}_{v, 1}^{(3)}, \boldsymbol{F}_{v, 2}^{(3)}, \cdots, \boldsymbol{F}_{v, L}^{(3)}\right\}, \\ \boldsymbol{F}_{v}^{(4)}=\left\{\boldsymbol{F}_{v, 1}^{(4)}, \boldsymbol{F}_{v, 2}^{(4)}, \cdots, \boldsymbol{F}_{v, L}^{(4)}\right\} . \end{array}$
在触觉分支中, 第l帧触觉图像tl经过触觉编码器后提取全局特征, 并通过线性投影映射至与视觉特征相同的特征维度D, 可得触觉全局特征:
f
其中,
经过上述处理, 得到每帧对应的多层级视觉空间特征
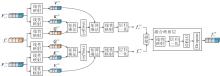
由于视觉与触觉在感知范围存在显著差异, 若直接将视觉全局特征和触觉全局特征进行拼接或加权融合, 难以准确建立触觉接触信息与视觉局部区域之间的对应关系.为此, 本文设计分层触觉引导空间注意力模块(HTGSA), 在单帧层面利用触觉特征引导视觉分支关注与当前接触状态相关的区域, 缓解视觉与触觉之间跨模态空间对应关系不足的问题.HTGSA结构如图2所示.
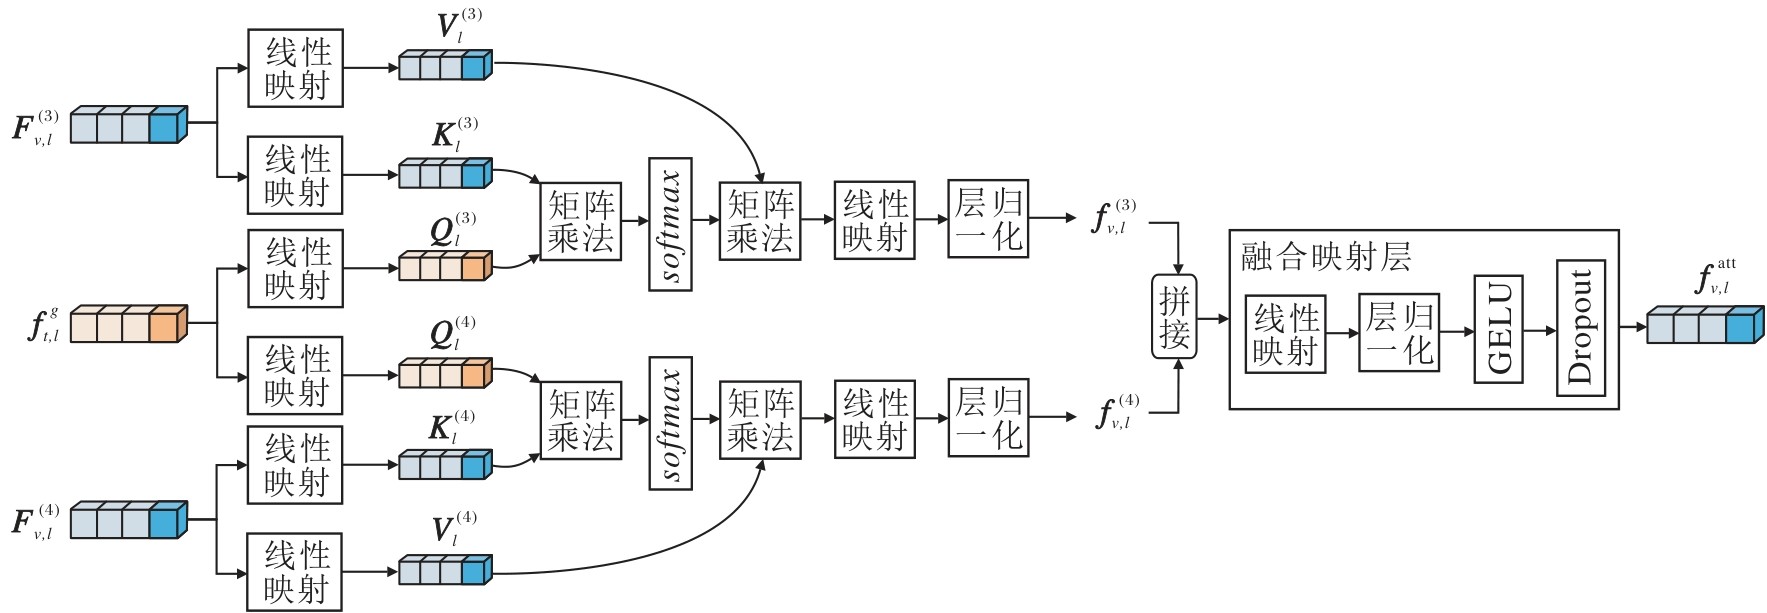 | 图2 HTGSA结构图Fig.2 Architecture of HTGSA |
为了兼顾局部纹理细节与高层语义信息, 分别在第3阶段和第4阶段执行触觉引导空间注意力的操作.前者有助于保留局部纹理和接触细节, 后者更侧重于表达目标整体结构和高层语义信息, 二者结合能增强触觉接触信息与视觉局部区域之间的对应关系.
在完成视觉特征与触觉特征提取后, 对于第l帧视觉-触觉同步数据, HTGSA将当前帧的触觉全局特征f
$\begin{array}{l} \boldsymbol{Q}_{l}^{(s)}=\boldsymbol{f}_{t, l}^{g} \boldsymbol{W}_{Q}^{(s)} \in \mathbf{R}^{1 \times D}, \\ \boldsymbol{K}_{l}^{(s)}=\boldsymbol{F}_{v, l}^{(s)} \boldsymbol{W}_{K}^{(s)} \in \mathbf{R}^{N_{s} \times D}, \\ \boldsymbol{V}_{l}^{(s)}=\boldsymbol{F}_{v, l}^{(s)} \boldsymbol{W}_{V}^{(s)} \in \mathbf{R}^{N_{s} \times D} . \end{array}$
其中:
$\boldsymbol{A}_{l}^{(s)}=\operatorname{Softmax}\left(\frac{\boldsymbol{Q}_{l}^{(s)}\left(\boldsymbol{K}_{l}^{(s)}\right)^{\mathrm{T}}}{\sqrt{D}}\right) \in \mathbf{R}^{N_{s}}, $
其中Softmax(· )表示沿视觉空间token维度Ns进行归一化.随后利用注意力权重对视觉特征V进行加权求和, 得到第s个层级上的触觉引导视觉表示:
经过线性映射和归一化处理后, 可得到该层级上的触觉引导的视觉特征:
f
其中,
f
其中:[· ; · ]表示特征拼接操作; Φ (· )表示轻量级融合映射层, 由线性映射、层归一化、高斯误差线性单元(Gaussian Error Linear Unit, GELU)激活函数和Dropout组成, 用于将拼接后的2D维特征重新映射为D维.对于单层触觉引导模式, 仅保留第4阶段的触觉引导输出作为当前帧的空间增强视觉特征.
对序列中的所有帧重复上述过程, 并沿序列顺序进行堆叠后, 可得到空间增强后的视觉特征序列
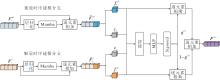
在获得空间增强视觉特征后, 由于不同时间步上视觉模态与触觉模态的判别贡献可能发生变化, 固定融合策略难以充分适应这一动态过程.为此, 本文设计动态跨模态时序融合模块(DCMTF), 通过双流时序建模和逐帧门控机制, 实现视觉特征与触觉特征的自适应融合.DCMTF结构如图3所示.
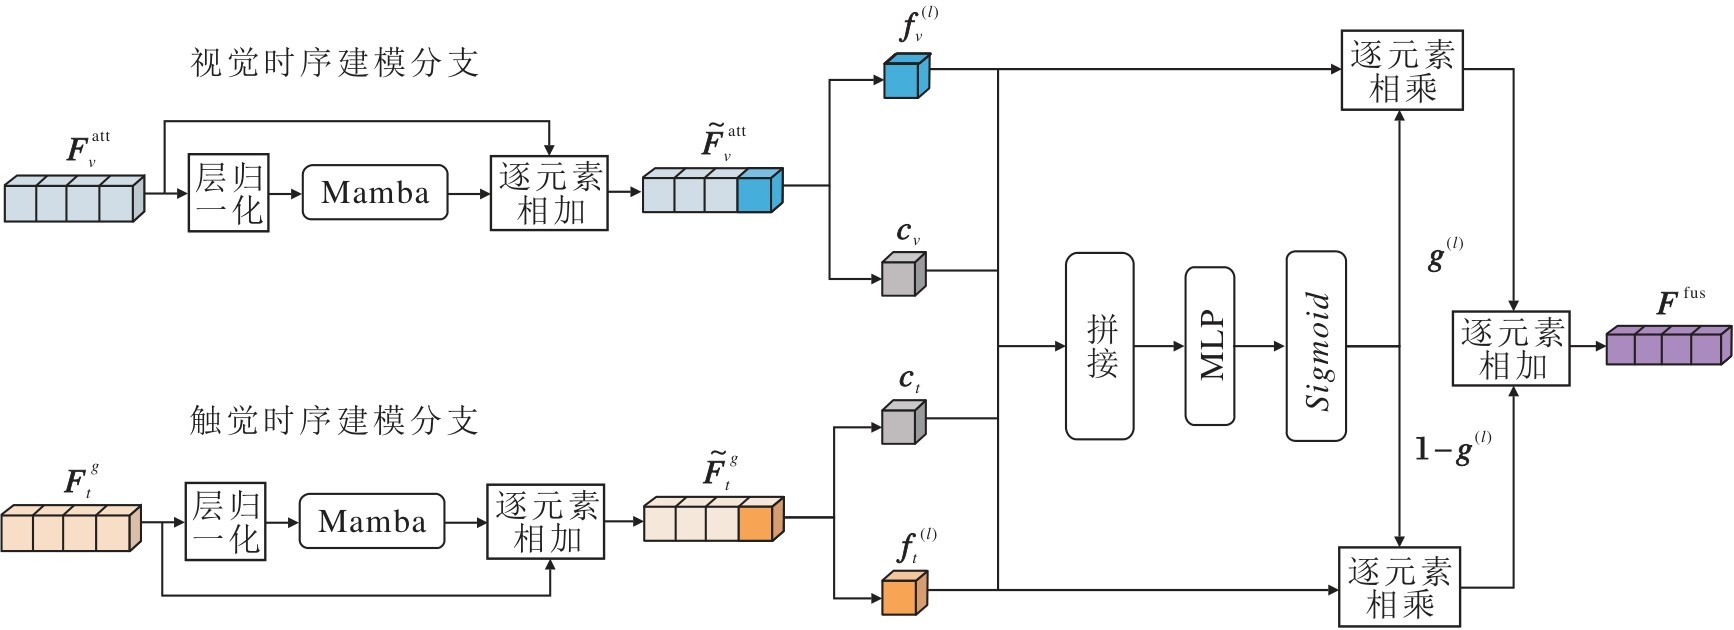 | 图3 DCMTF结构图Fig.3 Architecture of DCMTF |
首先, 将空间增强后的视觉特征序列
$\begin{array}{l} \widetilde{\boldsymbol{F}}_{v}^{\text {att }}=\boldsymbol{F}_{v}^{\text {att }}+\operatorname{Mamba}_{v}\left(L N\left(\boldsymbol{F}_{v}^{\text {att }}\right)\right) \in \mathbf{R}^{L \times D}, \\ \widetilde{\boldsymbol{F}}_{t}^{g}=\boldsymbol{F}_{t}^{g}+\operatorname{Mamba}_{t}\left(L N\left(\boldsymbol{F}_{t}^{\mathrm{g}}\right)\right) \in \mathbf{R}^{L \times D}, \end{array}$
其中, LN(· )表示归一化操作, Mambav(· )表示视觉时序建模分支, Mambat(· )表示触觉时序建模分支.残差连接用于保留原始模态特征并增强训练稳定性.经过Mamba建模后, 输出维度保持不变.
在获得视觉时序特征
$\boldsymbol{c}_{v}=\operatorname{Mean}\left(\widetilde{\boldsymbol{F}}_{v}^{\text {att }}\right)+\operatorname{Std}\left(\widetilde{\boldsymbol{F}}_{v}^{\text {att }}\right) \in \mathbf{R}^{D}$
和触觉模态上下文表示
$\boldsymbol{c}_{t}=\operatorname{Mean}\left(\widetilde{\boldsymbol{F}}_{t}^{g}\right)+\operatorname{Std}\left(\widetilde{\boldsymbol{F}}_{t}^{g}\right) \in \mathbf{R}^{D}, $
其中Mean(· )、Std(· )分别表示沿时间维度计算的均值和标准差.均值描述该模态在整个交互过程中的整体特征水平, 标准差反映其随时间变化的幅度.二者逐元素相加后形成模态级上下文表示, 使后续门控网络能同时利用模态的整体状态和动态变化信息.
随后, 采用逐帧动态门控机制对视觉特征和触觉特征进行自适应融合[22].对于第l个时间步, 从时序建模后的特征序列中取出视觉特征
f
和触觉特征
f
其中,
u(l)=[f
基于u(l), 门控网络通过两层MLP和Sigmoid函数生成动态门控权重:
g(l)=σ (W2δ (W1u(l)+b1)+b2)∈ RD,
其中, W1、W2表示可学习权重矩阵, b1、b2表示可学习偏置量, δ (· )表示GELU激活函数, σ (· )表示Sigmoid函数.由于g(l)与视觉特征、触觉特征具有相同的特征维度D, 且取值范围为[0, 1], 因此可用于调节当前时间步中两种模态的融合权重.
最后, 根据动态门控权重, 对当前时间步的视觉特征与触觉特征进行加权融合, 得到第l个时间步的跨模态融合特征:
f
其中, ☉表示逐元素乘法, g(l)表示第l个时间步中视觉特征动态融合权重, 1-g(l)对应触觉特征的动态融合权重.当当前时间步的视觉信息更具判别性时, 门控权重会增强视觉特征的贡献; 当触觉信息提供更有效的接触、纹理或材质线索时, 会相应提高触觉特征在融合结果中的占比.相比静态加法、平均融合或简单拼接, 该机制根据当前时间步特征和序列整体状态自适应调整不同时间阶段视觉特征与触觉特征的贡献程度.对所有时间步的融合结果进行堆叠, 可得到完整的融合特征序列:
Ffus={f
至此, DCMTF完成视觉序列特征与触觉序列特征的时序建模和逐帧融合, 输出的融合特征序列将作为时序注意力池化模块的输入.
对于单帧输入(L=1), 时间维度均值等于当前帧特征, 标准差设为0, 按单帧形式完成视觉特征与触觉特征的融合.
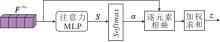
经过DCMTF后, 获得融合特征序列Ffus.该序列包含视觉模态与触觉模态在整个交互过程中的动态信息.然而, 不同时间步对最终分类任务的贡献并不相同:某些时刻包含更强的判别线索, 而另一些时刻的信息则相对冗余.若直接采用平均池化对整个序列的特征进行整合, 容易削弱关键时间步的重要性.为此, 本文引入时序注意力池化模块(TAP), 对融合序列进行加权池化, 突出对最终判断更关键的交互时刻[24].TAP结构如图4所示.
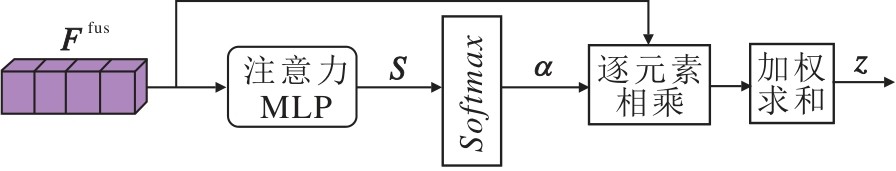 | 图4 TAP结构图Fig.4 Architecture of TAP |
第l个时间步的融合特征为f
sl=W
其中, W
再将所有时间步的注意力分数沿时间维度进行归一化, 得到第l个时间步对应的时序注意力权重:
α l=
最终利用注意力权重对融合序列进行加权求和, 得到全局序列特征:
z=
经过时序注意力加权汇聚后, 得到全局序列特征z, 并将其输入MLP分类头, 获得最终材料识别结果.
本文在The Feeling of Success[3]、Touch and Go[6]、ObjectFolder Real[25]这3个公开视觉-触觉数据集上评估方法, 主要针对材料属性识别和机器人抓取成功预测两类任务开展实验.其中, 材料属性识别包括材料类别分类、硬/软属性分类、粗糙/光滑属性分类.所有分类任务均采用准确率作为评价指标.
Touch and Go数据集是在真实环境中采集的视觉-触觉多模态数据集, 数据来源于人与不同物体及材料表面的交互过程, 总计约13 900条触觉接触片段, 覆盖约4 000个不同物体, 包含20类材料.基于该数据集, 本文开展材料类别识别、硬/软属性分类、粗糙/光滑属性分类实验.采用官方提供的数据划分方式, 将数据按照70%和30%的比例划分为训练集和测试集.
ObjectFolder Real数据集包含日常真实物体的多模态感知数据, 包括视觉、触觉等多种信息, 共100个日常物体, 并按照材料属性划分为7类, 同时也包含硬/软属性和粗糙/光滑属性标注.本文采用随机划分方式, 将数据按照70%和30%的比例划分为训练集和测试集, 重复实验5次, 取平均结果作为最终结果.
The Feeling of Success数据集用于机器人抓取成功预测任务, 包含夹爪触觉传感器数据及对应的RGB图像.每个抓取样本包含抓取前、抓取中和抓取后3个阶段的数据, 任务目标是判断抓取是否成功.本文选取原始数据集上抓取尝试次数较多的40个物体样本进行实验, 并采用公开的数据划分方式进行训练与测试.同时, 仅使用抓取过程中的“ during” 阶段样本进行评估.
在方法实现方面, 视觉编码器与触觉编码器均采用MambaVision-Tiny[21], 并使用ImageNet[26]预训练权重进行初始化.特征维度设为256, Mamba状态维度设为16.优化器采用AdamW(Adaptive Moment Estimation with Decoupled Weight Decay)[27], 权重衰减率设为0.01, 梯度裁剪阈值设为1.0, Dropout率[28]设为0.3, 学习率采用SGDR(Stochastic Gra- dient Descent with Warm Restarts)[29]中的余弦退火策略进行调度.
对于输入序列的构建, Touch and Go数据集上采用长度为L(L=8)的视觉-触觉序列作为输入, 每个序列由同一触碰片段中的8组连续同步采集的视觉-触觉帧构成, 训练集和测试集划分在序列构建前完成, 避免同一接触片段相邻帧同时出现在训练集和测试集上.在ObjectFolder Real、The Feeling of Success数据集上, 由于其样本不包含完整连续交互序列, 令L=1, 以单帧视觉-触觉样本形式输入.
针对不同数据集, 采用不同的学习率、批次大小和训练轮次.在Touch and Go数据集上, 编码器学习率设为3× 10⁻⁶, 其余模块学习率设为3× 10⁻⁵, 批次大小设为8, 训练轮次设为30.在The Feeling of Su- ccess、ObjectFolder Real数据集上, 编码器学习率设为3× 10⁻⁵, 其余模块设为3× 10⁻⁴, 批次大小设为64, 训练轮次设为50.
在数据增强方面, 训练时对视觉图像和触觉图像执行配对随机裁剪和水平翻转, 并对视觉图像额外施加颜色抖动.所有输入图像统一裁剪为224× 224大小, 并采用ImageNet均值和方差进行归一化.实验均在单张NVIDIA RTX 3090 GPU上进行.
较长的视觉-触觉序列能提供更完整的交互过程信息, 有助于方法捕捉接触过程中视觉外观、触觉响应及其动态变化.然而, 序列长度增加也会引入更多的计算开销.为了确定合适的输入序列长度, 在Touch and Go数据集上保持数据划分、网络结构、训练策略及其它超参数不变, 仅调整每个样本包含的同步视觉-触觉帧数.定义输入序列长度L=1, 2, 4, 8, 16, 相应类别识别准确率与计算开销变化如表1所示.由于不同序列长度实验仅改变输入序列帧数, 模型结构保持一致, 因此总参数量均为66.3 M.
 | 表1 L对HTA-DTF性能的影响 Table 1 Effect of L on HTA-DTF performance |
由表1可看出, 随着输入序列长度L的增加, 类别识别准确率整体呈上升趋势, 说明连续视觉-触觉序列能为材料识别提供有效的动态交互信息.当L由1增至8时, 类别识别准确率由88.1%升至89.0%, 提升0.9%, 表明引入更多的连续交互帧能帮助方法学习更充分的视觉-触觉时序特征.随着L的增加, 计算开销也随之增长.具体而言, 当L由1增至8时, 浮点运算量由18.0 G增至143.7 G, 推理时间由20.0 ms增至22.3 ms, 显存占用由389.3 MB增至406.9 MB.这说明更长的输入序列长度虽然能提供更丰富的时序信息, 但同时也会带来额外的计算资源消耗.当L由8增至16时, 类别识别准确率仅由89.0%升至89.2%, 提升幅度有限, 而浮点运算量由143.7 G增至287.3 G, 增加约一倍, 显存占用也进一步增至431.6 MB.因此, 继续增加输入序列长度难以带来明显性能提升.综合考虑识别性能、计算开销和资源占用, 本文选择L=8作为Touch and Go数据集后续实验的输入序列长度.
为了全面评估HTA-DTF的性能, 选取如下对比方法:VTFSA[5]、文献[6]方法、SSVTP[7]、MViTac[8]、ConViTac[9]、STAM[23].HTA-DTF采用与文献[8]和文献[9]一致的数据集划分方式, 并在相同评价指标下进行对比.
各方法在Touch and Go数据集上的准确率如表2所示.
| 表2 各方法在Touch and Go数据集上的准确率对比 Table 2 Accuracy comparison of different methods on Touch and Go dataset % |
由表2可看出, HTA-DTF在Touch and Go数据集上的各项指标都取得较优值.类别识别准确率达到89.0%, 相比次优的ConViTac提升2.7%; 在硬/软属性分类和粗糙/光滑属性分类上, 准确率分别达到97.4%和91.4%.从结果上看, HTA-DTF不仅在材料类别识别上有所提升, 在与材料属性相关的判断上也表现出较优的效果.现有方法多侧重于全局层面的跨模态一致性, 对视觉局部区域与触觉接触信息的对应关系及交互过程中的动态变化的关注相对有限.
为了分析HTA-DTF中不同组成部分及关键设计对性能的影响, 在Touch and Go数据集上开展消融实验, 分别从触觉引导方式、时序建模方式、跨模态融合策略及关键模块消融四个方面展开.触觉引导方式消融实验用于验证分层触觉引导空间注意力模块(HTGSA)设计的合理性; 时序建模方式对比实验用于分析不同序列建模方法的性能与计算复杂度; 跨模态融合策略消融实验用于对比不同视觉-触觉融合方式的影响; 关键模块消融实验在完整方法基础上分别移除 HTGSA、动态门控融合、时序Mamba建模和时序注意力池化模块(TAP), 分析各组成部分对整体性能的贡献.
为了验证分层触觉引导方式的有效性, 对比如下3种不同设置:不使用触觉引导、仅使用第4阶段进行触觉引导、结合第3阶段和第4阶段的多层触觉引导方式.在不使用触觉引导时, 视觉分支不再利用触觉信息对视觉局部区域进行引导, 而是直接采用视觉编码器输出的全局特征进行后续处理; 在仅使用第4阶段进行触觉引导时, 触觉引导仅作用于高层视觉特征.相应消融实验结果如表3所示.由表可见, 相比不使用触觉引导, 引入触觉引导后方法在类别识别和硬/软属性分类上的准确率均取得提升, 其中, 同时结合第3阶段和第4阶段的多层触觉引导方式的方法整体性能更优.还可看出, 引入触觉引导后, 方法在类别识别和硬/软属性分类上的准确率均有一定提升.仅使用第4阶段特征时, 方法主要利用高层语义信息, 对局部纹理和细节的表达相对有限.加入第3阶段特征后, 方法能结合中层特征中保留的局部外观和纹理细节, 因此进一步提高类别识别性能.另一方面, 在粗糙/光滑属性分类上, 不使用触觉引导的准确率略高于多层引导结果, 说明粗糙/光滑属性的判别可能更依赖稳定的局部纹理线索, 触觉引导带来的提升并不明显.总之, 多层级触觉引导有助于提升材料类别识别性能, 但其对不同属性分类任务的作用存在差异.
| 表3 HTGSA触觉引导方式的消融实验结果 Table 3 Ablation experiment results on tactile guidance strategies in HTGSA % |
为了分析不同时序建模方式对方法性能的影响, 在保持特征编码器、HTGSA、动态门控和时序池化等结构不变的条件下, 分别采用轻量时序卷积模块、Transformer自注意力模型[15]和Mamba选择性状态空间模型[19]进行双流时序特征建模.其中, 轻量时序卷积模块借鉴TCN[14]的膨胀卷积和残差连接思想, 由两层一维膨胀卷积构成, 用于捕捉局部时序动态变化.所有实验采用相同的数据划分、训练策略和输入序列长度(L=8).对于参数量和浮点运算量仅统计双流时序建模单元, 具体消融实验结果如表4所示.
| 表4 不同时序建模模块的消融实验结果 Table 4 Ablation experiment results of different temporal modeling modules |
由表4可看出, 3种时序建模方式在类别识别准确率上较接近.Mamba与Transformer的类别识别准确率均为89.0%, 但Mamba的参数量和浮点运算量分别降低约44.3%和41.1%.轻量时序卷积的参数量和浮点运算量与Mamba较接近, 准确率略微降低0.4%.综合来看, Mamba在保持较高识别精度的同时具有更低的计算开销, 本文采用Mamba进行视觉与触觉双流时序特征建模.
下面分析动态跨模态时序融合模块(DCMTF)中不同跨模态融合策略对方法性能的影响, 策略包括静态加法、静态平均、特征拼接+线性变换及本文采用的动态门控融合.为了保证对比的公平性, 不同设置均保持特征提取和双流时序Mamba建模结构一致, 仅替换Mamba输出后的视觉特征与触觉特征融合方式.相应消融实验结果如表5所示.
| 表5 DCMTF 融合策略的消融实验结果 Table 5 Ablation experiment results of fusion strategies in DCMTF % |
由表5可看出, 在不同融合策略中, 动态门控融合在类别识别和硬/软属性分类上取得最高准确率, 说明结合当前时间步特征和序列上下文动态调整视觉模态与触觉模态的融合比例, 能提升方法对类别和部分材料属性的判别能力.相比静态加法、静态平均和拼接+线性变换, 动态门控融合不再采用固定融合权重, 而是根据交互过程中的状态变化自适应调节两种模态的贡献.同时可看到, 在粗糙/光滑属性分类上, 静态平均融合取得略高结果, 这可能是因为粗糙/光滑属性分类更依赖相对稳定的局部纹理线索, 固定平均融合在一定程度上保留稳定的触觉纹理信息.总之, 动态门控融合在类别识别及整体性能方面表现更优, 而静态平均融合在特定属性分类上具有一定优势.
为了分析各主要组成部分的有效性, 在完整模型基础上分别去除HTGSA、动态门控融合、时序Mamba建模及TAP.去除HTGSA表示不使用触觉信息对视觉空间特征进行引导; 去除动态门控融合表示将动态门控融合替换为固定的静态平均融合; 去除时序Mamba建模表示视觉特征和触觉特征不经过Mamba时序建模; 去除TAP表示采用时间维度平均池化替代时序注意力池化.
各模块的消融实验结果如表6所示.由表可看出, 去除任一主要组成部分都会使类别识别准确率下降, 说明HTGSA、动态门控融合、时序Mamba建模和TAP均对整体性能具有积极作用.HTGSA主要影响空间特征表达, 时序Mamba建模和动态门控融合主要影响序列建模与跨模态融合, TAP则影响序列级特征汇聚.
| 表6 各模块的消融实验结果 Table 6 Ablation experiment results of main HTA-DTF components % |
由于视觉-触觉连续交互序列的获取成本较高, 部分公开数据集上并不包含完整的连续时序信息.为了验证HTA-DTF在不同数据形式下的适应性, 在ObjectFolder Real、The Feeling of Success数据集上进行单帧输入条件下的补充实验.实验将每个样本作为长度为1的视觉-触觉序列.此时, 时序建模部分的作用相对减弱, 方法主要依赖HTGSA和跨模态融合机制完成视觉-触觉信息整合.
选择如下对比方法:STAM、VTFSA、文献[6]方法、SSVTP、MViTac、ConViTac, 相应泛化实验结果如表7所示.由表可见, HTA-DTF在ObjectFolder Real数据集上取得75.9%的准确率, 在The Feeling of Success数据集上取得87.2%的准确率, 分别相比次优的ConViTac提升16.0%和2.9%.结果表明, HTA-DTF在缺少长程时序信息时仍能保持较好的跨模态融合能力.HTGSA能增强视觉区域与触觉信息之间的对应关系, 动态融合机制能自适应整合两种模态信息, 因此在单帧输入条件下仍具有较好的适应性.
| 表7 单帧输入条件下的泛化实验结果 Table 7 Generalization experiments under single-frame input % |
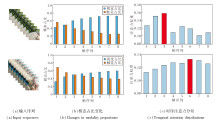
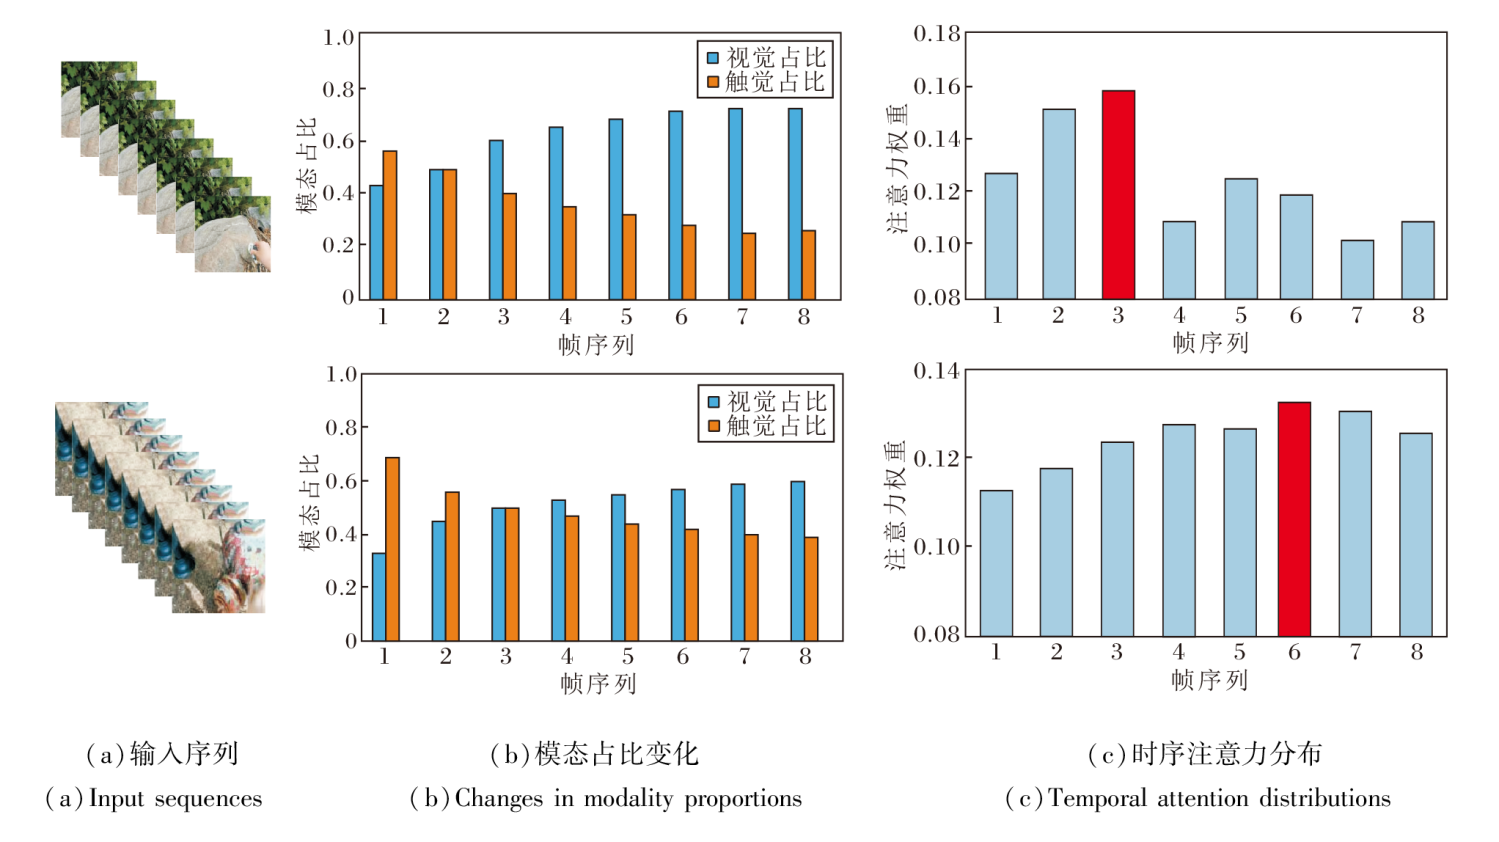
为了分析HTA-DTF在时间维度上的跨模态融合过程, 对动态跨模态时序融合过程进行可视化分析, 观察不同时间步视觉模态与触觉模态贡献及其时序注意力权重的动态变化情况, 相应结果如图5所示.在图中, 每行对应一个样本, 从左到右依次为输入序列、视觉与触觉贡献比例随时间步的变化情况、对应的时序注意力权重分布.其中, 视觉贡献比例由动态门控权重得到, 触觉贡献比例由其互补权重得到.时序注意力权重来自TAP, 用于表示不同时间步对最终分类结果的重要程度.(c)中红色柱体表示时序注意力权重最高的时间步, 即方法在最终判断时最关注的关键交互时刻.
 | 图5 DCMTF 融合过程可视化结果Fig.5 Visualization results of DCMTF fusion process |
由图5可看出, 不同样本中视觉与触觉的贡献比例会随时间发生变化, 时序注意力权重的峰值位置也并不固定.这表明方法能根据具体交互过程调整模态融合结果, 并对不同时间步赋予不同权重.
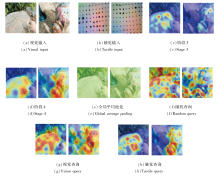
为了进一步分析HTA-DTF中HTGSA和DCMTF的作用, 分别对空间注意力响应和时序融合过程进行可视化分析, 不同视觉层级和不同查询设置下的可视化结果如图6所示.由图可看出, 阶段3和阶段4分别表示采用触觉查询时不同视觉层级生成的空间注意力响应.第3阶段生成的空间注意力更关注局部纹理及接触细节, 而第4阶段生成的空间注意力具有更大的感受野, 更侧重于目标主体及高层语义信息, 说明不同层级视觉特征在局部细节建模和全局语义表达方面具有互补性.融合两个层级的视觉特征能同时利用细粒度空间信息和高层语义信息, 提高视觉-触觉特征表示能力.
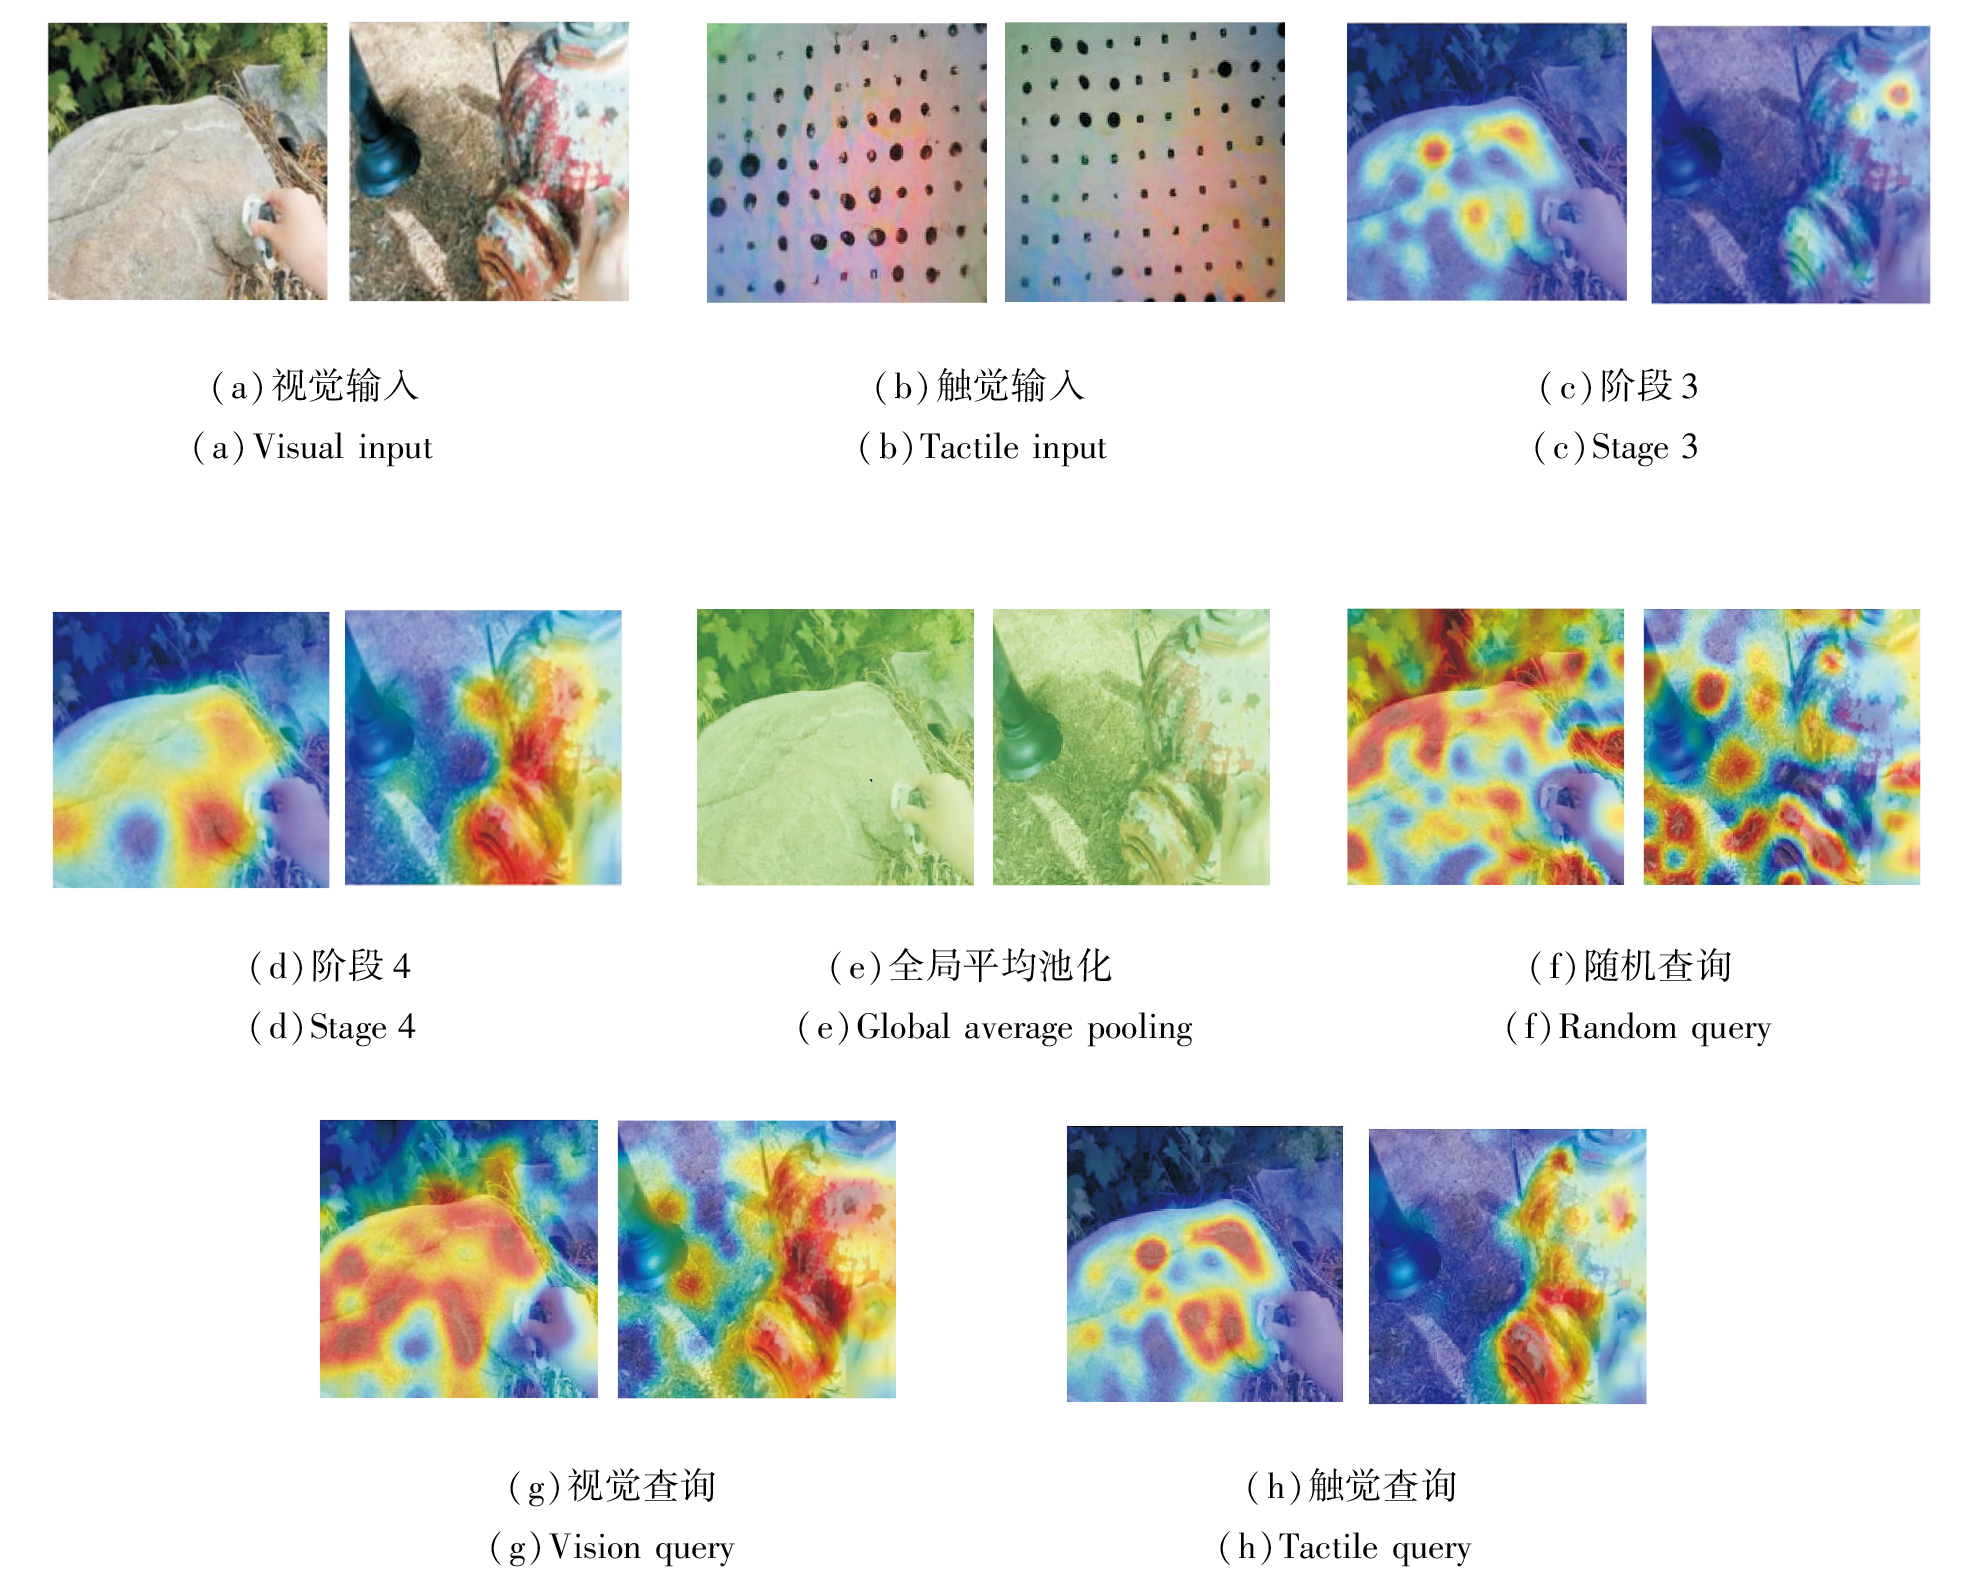 | 图6 不同视觉层级和不同查询设置下的可视化结果Fig.6 Visualization results with different visual feature levels and different query settings |
从不同查询设置的结果可看出:全局平均池化(无查询)对各空间位置进行等权聚合, 缺乏对局部接触区域的选择性关注; 随机查询得到的注意力响应较分散; 视觉查询主要依据视觉特征生成注意力, 容易受到物体外观及视觉显著区域的影响.相比之下, 触觉查询能根据不同触觉输入, 自适应关注与当前接触状态相关的视觉区域, 并产生相应的注意力响应.可视化结果表明, 触觉信息能有效引导视觉分支关注与当前接触状态相关的局部区域, 增强视觉与触觉之间与接触相关的空间对应关系.
本文针对视觉-触觉多模态融合中空间对应关系不足、多层级视觉特征利用不充分及交互过程融合方式固定等问题, 提出基于分层触觉引导空间注意力和动态跨模态时序融合的视觉-触觉多模态学习方法(HTA-DTF).
HTA-DTF设计分层触觉引导空间注意力模块(HTGSA), 利用触觉信息引导视觉分支关注与接触相关的局部区域, 并结合不同层级视觉特征增强空间表达.构建动态跨模态时序融合模块(DCMTF), 对视觉序列与触觉序列进行时序建模, 并结合动态门控机制自适应融合两种模态特征.设计时序注意力池化模块(TAP), 对融合序列进行加权汇聚, 获得更有效的序列级表示.
在Touch and Go数据集上的实验表明, HTA-DTF在材料类别识别任务上取得89.0%的准确率.消融实验和可视化结果验证各模块的有效性.在ObjectFolder Real、The Feeling of Success数据集上的实验也表明, HTA-DTF在单帧输入条件下仍具有一定的适应性.
尽管HTA-DTF取得一定的性能提升, 但结构仍相对复杂, 实际部署中的计算开销有待降低.此外, 本文主要通过接触相关空间对齐和动态时序交互实现视觉-触觉信息融合, 尚未显式引入语义对齐约束.在交互对象类别更多样、跨数据集迁移或视觉与触觉语义关联较弱的场景中, 显式语义对齐可能有助于进一步增强异构模态特征的一致性和模型泛化能力.
未来将重点研究轻量化视觉-触觉融合模型, 探索结合语义对齐机制的跨模态融合方法, 并将HTA-DTF应用于真实机器人抓取和动态交互感知场景中.
本文责任编委 兰旭光
Recommended by Associate Editor LAN Xuguang
| [1] |
|
| [2] |
|
| [3] |
|
| [4] |
|
| [5] |
|
| [6] |
|
| [7] |
|
| [8] |
|
| [9] |
|
| [10] |
|
| [11] |
|
| [12] |
|
| [13] |
|
| [14] |
|
| [15] |
|
| [16] |
|
| [17] |
|
| [18] |
|
| [19] |
|
| [20] |
|
| [21] |
|
| [22] |
|
| [23] |
|
| [24] |
|
| [25] |
|
| [26] |
|
| [27] |
|
| [28] |
|
| [29] |
|